
python模块之HTMLParser简介
html.parser是一个非常简单和实用的库,它的核心是HTMLParser类。
工作的流程是:当你feed给它一个类似HTML格式的字符串时,它会调用goahead方法向前迭代各个标签,并调用对应的parse_xxxx方法提取start_tag, tag, attrs data comment和end_tag等等标签信息和数据,然后调用对应的方法对这些抽取出来的内容进行处理。整个HTMLParser的大致结构如下图所示:
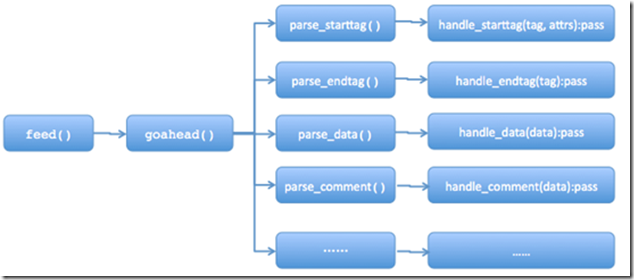
可以发现,处理开始标签(handle_starttag)、结束标签(handle_endtag)和处理数据(handle_data)等处理函数在HTMLParser里是没有实现的(pass),这需要我们继承HTMLParser这个类的并覆盖这些方法。详细可以参阅python文档,https://docs.python.org/3/library/html.parser.html?highlight=htmlparser
一、常用方法介绍
l feed(data):主要用于接受带html标签的str,当调用这个方法时并提供相应的data时,整个实例(instance)开始执行,结束执行close()。
l handle_starttag(tag, attrs): 这个方法接收Parse_starttag返回的tag和attrs,并进行处理,处理方式通常由使用者进行覆盖,本身为空。
例如,连接的start tag是<a>,那么对应的参数tag=’a’(小写)。attrs是start tag <>中的属性,以元组形式(name, value)返回(所有这些内容都是小写)。
例如,对于<A HREF="http://www.baidu.com“>,那么内部调用形式为:handle_starttag(’a’,[(‘href’,’http://www.baidu.com)]).
l handle_endtag(tag):跟上述一样,只是处理的是结束标签,也就是以</开头的标签。
l handle_data(data):处理的是网页的数据,也就是开始标签和结束标签之间的内容。例如:<script>...</script>的省略号内容
l handle_comment(data) ,处理注释,<!-- -->之间的文本
l reset():将实例重置,包括作为参数输入的数据进行清空。
二、基本使用
from html.parser import HTMLParser

class MyHTMLParser(HTMLParser):

    def handle_starttag(self, tag, attrs):

        """

        recognize start tag, like <div>

        :param tag:

        :param attrs:

        :return:

        """

        print("Encountered a start tag:", tag)

    def handle_endtag(self, tag):

        """

        recognize end tag, like </div>

        :param tag:

        :return:

        """

        print("Encountered an end tag :", tag)

    def handle_data(self, data):

        """

        recognize data, html content string

        :param data:

        :return:

        """

        print("Encountered some data  :", data)

    def handle_startendtag(self, tag, attrs):

        """

        recognize tag that without endtag, like <img />

        :param tag:

        :param attrs:

        :return:

        """

        print("Encountered startendtag :", tag)

    def handle_comment(self,data):

        """

        :param data:

        :return:

        """

        print("Encountered comment :", data)

parser = MyHTMLParser()

parser.feed('<html><head><title>Test</title></head>'

            '<body><h1>Parse me!</h1><img src = "" />'

            '<!-- comment --></body></html>')
以上是根据python手册写的基本使用,解析了一个简单的html。可以运行看看,主要用于了解各个函数负责解析的部分,以及解析顺序
Encountered a start tag: html

Encountered a start tag: head

Encountered a start tag: title

Encountered some data  : Test

Encountered an end tag : title

Encountered an end tag : head

Encountered a start tag: body

Encountered a start tag: h1

Encountered some data  : Parse me!

Encountered an end tag : h1

Encountered startendtag : img

Encountered comment :  comment

Encountered an end tag : body

Encountered an end tag : html
三、实用案例
以下的实用案例均在上面的代码中修改对应函数,每个实例都是单独的。
解析的html如下
<html>

    <head>

        <title>Test</title>

    </head>

    <body>

        <h1>Parse me!</h1>

        <img src = "" />

        <p class='123'>A paragraph.</p>

                <p class = "p_font">A paragraph with class.</p>

                <!-- comment -->

        <div>

            <p>A paragraph in div.</p>

        </div>

    </body>

</html>
1.获取所有p标签的文本,最简单方法只修改handle_data
def handle_data(self, data):

    if self.lasttag == 'p':

        print("Encountered p data  :", data)
2.获取css样式(class)为p_font的p标签的文本,使用了案例1,增加一个实例属性作为标志,选取需要的标签
def __init__(self):

    HTMLParser.__init__(self)

    self.flag = False

def handle_starttag(self, tag, attrs):

for attr in attrs:

if tag == 'p' and attr[1]=='"p_font":

self.flag = True

def handle_data(self, data):

    if self.flag == True:

        print("Encountered p data  :", data)
3.获取p标签的属性列表
def handle_starttag(self, tag, attrs):

    if tag == 'p':

        print("Encountered p attrs  :", attrs)
4.获取p标签的class属性
def handle_starttag(self, tag, attrs):

for attr in attrs:

    	If tag == 'p' and attr[0]= 'class'):

        	print("Encountered p class  :", attr[1])
5.获取div下的p标签的文本
def __init__(self):

    HTMLParser.__init__(self)

    self.in_div = False

def handle_starttag(self, tag, attrs):

    if tag == 'div':

        self.in_div = True

def handle_data(self, data):

    if self.in_div == True and self.lasttag == 'p':

        print("Encountered p data  :", data)

self.in_div = False
6.处理注释中的标签,若需要的数据在注释中,使用一般函数解析不到
处理方法为,写两个类,继承HTMLParser。在其中一个类的handle_comment里实例化解析类,和其他标签一样解析
def __init__(self):

    HTMLParser.__init__(self)

def handle_comment(self,data):

    print(("Encountered  comment:",data)
完整实例
例如:我们有以下一堆带HTML标签的数据
html = '''<h3 class="tb-main-title" data-title="Xiaomi/小米">

     【金冠现货/全色/顶配版】Xiaomi/小米 小米note移动联通4G手机

   </h3>

   <p class="tb-subtitle">

 【购机即送布丁套+高清贴膜+线控耳机+剪卡器+电影支架等等,套餐更多豪礼更优惠】

 </p>

   <div id="J_TEditItem" class="tb-editor-menu"></div>

 </div>

<h3 class="tb-main-title" data-title="MIUI/小米">

     【现货增强/标准】MIUI/小米 红米手机2红米2移动联通电信4G双卡

   </h3>

   <p class="tb-subtitle">

 [红米手机2代颜色版本较多,请亲们阅读购买说明按需选购---感谢光临]

   <div id="J_TEditItem" class="tb-editor-menu"></div>

 </div>'''
很明显,这里面包含了两台手机,我们的目标是提取两个手机的名字出来。
由于当我们feed这个html到HTMLParser中后,他们所有的标签都迭代,如果需要它只提取我们需要的数据时,我们需要设置当handle_starttag遇到那个标签和属性时,才调用handle_data并print出我们的结果,这个时候我们可以使用一个flag作为判定,代码如下:
#定义一个MyParser继承自HTMLParser

class MyParser(HTMLParser):

    re=[]#放置结果

    flag=0#标志,用以标记是否找到我们需要的标签

    def handle_starttag(self, tag, attrs):

        if tag=='p':#目标标签

            for attr in attrs:

                if attr[0]=='class' and attr[1]=='tb-subtitle':#目标标签具有的属性

                    self.flag=1#符合条件则将标志设置为1

                    break

        else:

            pass

    def handle_data(self, data):

        if self.flag==1:

            self.re.append(data.strip())#如果标志为我们设置的,则将数据添加到列表中

            self.flag=0#重置标志,进行下次迭代

        else:

            pass

my=MyParser()

my.feed(html)

my.re
运行结果如下,达到了我们的预期:
['【购机即送布丁套+高清贴膜+线控耳机+剪卡器+电影支架等等,套餐更多豪礼更优惠】',
'[红米手机2代颜色版本较多,请亲们阅读购买说明按需选购---感谢光临]']
python模块之HTMLParser简介的更多相关文章
- python模块介绍- HTMLParser 简单的HTML和XHTML解析器
python模块介绍- HTMLParser 简单的HTML和XHTML解析器 2013-09-11 磁针石 #承接软件自动化实施与培训等gtalk:ouyangchongwu#gmail.comqq ...
- python模块之HTMLParser(原理很大程度上就是对类构造的熟练运用)
# -*- coding: utf-8 -*- #python 27 #xiaodeng #python模块之HTMLParser(原理很大程度上就是对类构造的熟练运用) import HTMLPar ...
- python模块之HTMLParser之穆雪峰的案例(理解其用法原理)
# -*- coding: utf-8 -*- #python 27 #xiaodeng #python模块之HTMLParser之穆雪峰的案例(理解其用法原理) #http://www.cnblog ...
- python模块之HTMLParser抓页面上的所有URL链接
# -*- coding: utf-8 -*- #python 27 #xiaodeng #python模块之HTMLParser抓页面上的所有URL链接 import urllib #MyParse ...
- python模块之HTMLParser解析出URL链接
# -*- coding: utf-8 -*- #python 27 #xiaodeng #python模块之HTMLParser解析出URL链接 #http://www.cnblogs.com/mf ...
- python模块之HTMLParser
HTMLParser是python用来解析html的模块.它可以分析出html里面的标签.数据等等,是一种处理html的简便途径. HTMLParser采用的是一种事件驱动的模式,当HTMLParse ...
- python模块学习---HTMLParser(解析HTML文档元素)
HTMLParser是Python自带的模块,使用简单,能够很容易的实现HTML文件的分析. 本文主要简单讲一下HTMLParser的用法. 使用时需要定义一个从类HTMLParser继承的类,重定义 ...
- python模块——PrettyTable
python模块——PrettyTable 一. 简介 Python通过prettytable模块将输出内容如表格方式整齐输出,可用来生成美观的ASCII格式的表格,十分实用. python本身并不内 ...
- 6.文件所有权和权限----免费设置匿名----Windows键盘记录器----简介和python模块
文件所有权和权限 touch --help cd Desktop mkdir Folder cd Folder clear touch Test1 Test2 Test3 Test4 ls ls -l ...
随机推荐
- str_place()替换函数
str_replace() 函数使用一个字符串替换字符串中的另一些字符. 注释:该函数对大小写敏感.请使用 str_ireplace() 执行对大小写不敏感的搜索. echo str_replace( ...
- SqlServer中把结果集放到到临时表的方法(转)
一. SELECT INTO 1. 使用select into会自动生成临时表,不需要事先创建 select * into #temp from sysobjects 01. 把存储过程结 ...
- Entity Framework Tutorial Basics(10):Entity Lifecycle
Entity Lifecycle: Before we work on CRUD operation (Create, Read, Update, Delete), it's important to ...
- easyUI datagrid 分页参数page和rows
Struts2获取easyUI datagrid 分页参数page和rows 用pageHelper分页时,只要是能够获取前台传来的两个参数page和rows基本就完成了很大一部分. 获取方法:定义两 ...
- auto和register关键字
关键字概述 很多朋友看到这儿可能会有疑问,往往其它讲C语言的书籍都是从HelloWorld,数据类型开始C语言学习的,为什么我们要从C语言的关键字开始呢?关于这点,我有两点需要说明: 本章节面向的读者 ...
- 《Head First Servlets & JSP》-12-Web应用安全
serlvet安全的4大要素 认证.授权.机密性和数据完整性. 容器完成认证和授权的过程 代码中不要有安全信息 大多数Web应用,大多数情况下Web应用的安全约束都应该以声明方式处理,即在部署描述文档 ...
- java的import关键字的使用
在java中如何使用Java包中自带的类呢? 方法一: 在使用时可以用Java.(包名).(方法名).(包中的类名): 例如:Java.util.Arrays.toString(某个要排序数组); 具 ...
- MVC中使用代码创建数据库(code first +mysql+EF)
1.新建一个mvc项目 2.安装mysql需要的几个文件 EntityFramework.MySql.Data(6.9.12)和MySql.Data.Entity (6.9.12) 这里有几点要注意 ...
- HTTP 协议 -- 浏览器缓存机制
浏览器缓存机制 浏览器缓存机制主要是 HTTP 协议定义的缓存机制. HTTP 协议中有关缓存的缓存信息头的关键字有 Cache-Control,Pragma,Expires,Last-Modifie ...
- 数据加密实战之记住密码、自动登录和加密保存数据运用DES和MD5混合使用
MD5的简介:MD5即Message-Digest Algorithm 5(信息-摘要算法5),用于确保信息传输完整一致.是计算机广泛使用的杂凑算法之一(又译摘要算法.哈希算法),主流编程语言普遍已有 ...