
tf-idf sklearn
第一步:语料转化为词袋向量
step 1. 声明一个向量化工具vectorizer;
本文使用的是CountVectorizer,默认情况下,CountVectorizer仅统计长度超过两个字符的词,但是在短文本中任何一个字都可能十分重要,比如“去/到”等,所以要想让CountVectorizer也支持单字符的词,需要加上参数token_pattern='\\b\\w+\\b'。
step 2. 根据语料集统计词袋(fit);
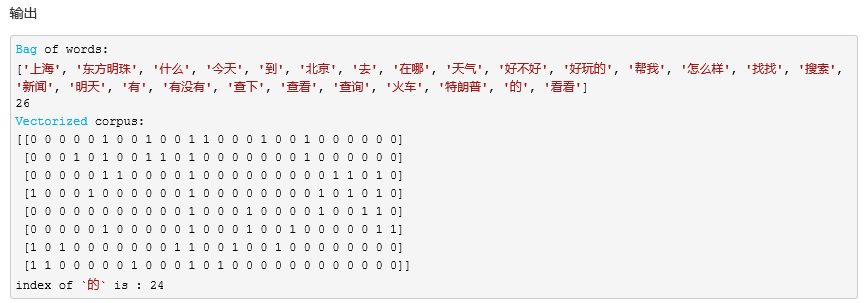
step 3. 打印语料集的词袋信息;
step 4. 将语料集转化为词袋向量(transform);
step 5. 还可以查看每个词在词袋中的索引。
代码:
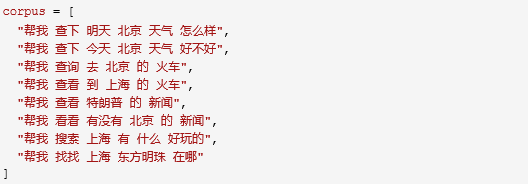
step 1中: min_df、max_df 表示一个阈值,低于、超过这个阈值的词汇讲被忽略
from sklearn.feature_extraction.text import CountVectorizer

# step 1

vectoerizer = CountVectorizer(min_df=1, max_df=1.0, token_pattern='\\b\\w+\\b')

# step 2

vectoerizer.fit(corpus)

# step 3

bag_of_words = vectoerizer.get_feature_names()

print("Bag of words:")

print(bag_of_words)

print(len(bag_of_words))

# step 4

X = vectoerizer.transform(corpus)

print("Vectorized corpus:")

print(X.toarray())

# step 5

print("index of `的` is : {}".format(vectoerizer.vocabulary_.get('的')))
第二步:根据词袋向量统计TF-IDF
step 1. 声明一个TF-IDF转化器(TfidfTransformer);
step 2. 根据语料集的词袋向量计算TF-IDF(fit);
step 3. 打印TF-IDF信息:比如结合词袋信息,可以查看每个词的TF-IDF值;
step 4. 将语料集的词袋向量表示转换为TF-IDF向量表示;
from sklearn.feature_extraction.text import TfidfTransformer

# step 1

tfidf_transformer = TfidfTransformer()

# step 2

tfidf_transformer.fit(X.toarray())

# step 3

for idx, word in enumerate(vectoerizer.get_feature_names()):

  print("{}\t{}".format(word, tfidf_transformer.idf_[idx]))

# step 4

tfidf = tfidf_transformer.transform(X)

print(tfidf.toarray())
输出
上海  1.8109302162163288

东方明珠    2.504077396776274

什么  2.504077396776274

今天  2.504077396776274

到   2.504077396776274

北京  1.587786664902119

去   2.504077396776274

在哪  2.504077396776274

天气  2.09861228866811

好不好 2.504077396776274

好玩的 2.504077396776274

帮我  1.0

怎么样 2.504077396776274

找找  2.504077396776274

搜索  2.504077396776274

新闻  2.09861228866811

明天  2.504077396776274

有   2.504077396776274

有没有 2.504077396776274

查下  2.09861228866811

查看  2.09861228866811

查询  2.504077396776274

火车  2.09861228866811

特朗普 2.504077396776274

的   1.587786664902119

看看  2.504077396776274

[[0.         0.         0.         0.         0.         0.3183848

  0.         0.         0.42081614 0.         0.         0.20052115

  0.50212047 0.         0.         0.         0.50212047 0.

  0.         0.42081614 0.         0.         0.         0.

  0.         0.        ]

 [0.         0.         0.         0.50212047 0.         0.3183848

  0.         0.         0.42081614 0.50212047 0.         0.20052115

  0.         0.         0.         0.         0.         0.

  0.         0.42081614 0.         0.         0.         0.

  0.         0.        ]

 [0.         0.         0.         0.         0.         0.33116919

  0.52228256 0.         0.         0.         0.         0.20857285

  0.         0.         0.         0.         0.         0.

  0.         0.         0.         0.52228256 0.43771355 0.

  0.33116919 0.        ]

 [0.38715525 0.         0.         0.         0.53534183 0.

  0.         0.         0.         0.         0.         0.21378805

  0.         0.         0.         0.         0.         0.

  0.         0.         0.44865824 0.         0.44865824 0.

  0.33944982 0.        ]

 [0.         0.         0.         0.         0.         0.

  0.         0.         0.         0.         0.         0.23187059

  0.         0.         0.         0.48660646 0.         0.

  0.         0.         0.48660646 0.         0.         0.5806219

  0.36816103 0.        ]

 [0.         0.         0.         0.         0.         0.33116919

  0.         0.         0.         0.         0.         0.20857285

  0.         0.         0.         0.43771355 0.         0.

  0.52228256 0.         0.         0.         0.         0.

  0.33116919 0.52228256]

 [0.33420711 0.         0.4621274  0.         0.         0.

  0.         0.         0.         0.         0.4621274  0.18454996

  0.         0.         0.4621274  0.         0.         0.4621274

  0.         0.         0.         0.         0.         0.

  0.         0.        ]

 [0.37686288 0.52110999 0.         0.         0.         0.

  0.         0.52110999 0.         0.         0.         0.20810458

  0.         0.52110999 0.         0.         0.         0.

  0.         0.         0.         0.         0.         0.

  0.         0.        ]]
出处: http://www.cnblogs.com/CheeseZH/
上面的sklearn 的函数介绍:
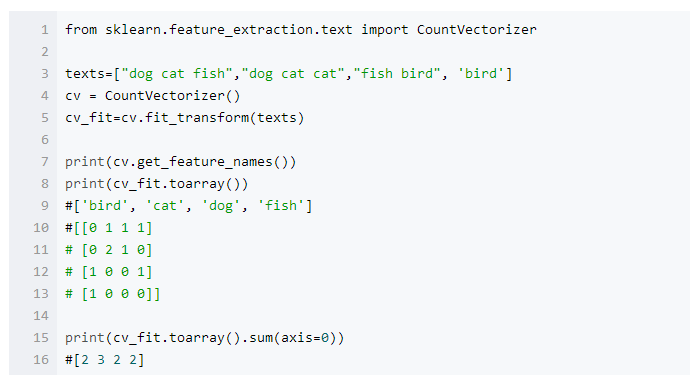
CountVectorizer 实例介绍:
tf-idf sklearn的更多相关文章
- tf idf公式及sklearn中TfidfVectorizer
在文本挖掘预处理之向量化与Hash Trick中我们讲到在文本挖掘的预处理中,向量化之后一般都伴随着TF-IDF的处理,那么什么是TF-IDF,为什么一般我们要加这一步预处理呢?这里就对TF-IDF的 ...
- TF/IDF(term frequency/inverse document frequency)
TF/IDF(term frequency/inverse document frequency) 的概念被公认为信息检索中最重要的发明. 一. TF/IDF描述单个term与特定document的相 ...
- 基于TF/IDF的聚类算法原理
一.TF/IDF描述单个term与特定document的相关性TF(Term Frequency): 表示一个term与某个document的相关性. 公式为这个term在document中出 ...
- 使用solr的函数查询,并获取tf*idf值
1. 使用函数df(field,keyword) 和idf(field,keyword). http://118.85.207.11:11100/solr/mobile/select?q={!func ...
- TF/IDF计算方法
FROM:http://blog.csdn.net/pennyliang/article/details/1231028 我们已经谈过了如何自动下载网页.如何建立索引.如何衡量网页的质量(Page R ...
- tf–idf算法解释及其python代码实现(下)
tf–idf算法python代码实现 这是我写的一个tf-idf的简单实现的代码,我们知道tfidf=tf*idf,所以可以分别计算tf和idf值在相乘,首先我们创建一个简单的语料库,作为例子,只有四 ...
- tf–idf算法解释及其python代码实现(上)
tf–idf算法解释 tf–idf, 是term frequency–inverse document frequency的缩写,它通常用来衡量一个词对在一个语料库中对它所在的文档有多重要,常用在信息 ...
- 文本分类学习(三) 特征权重(TF/IDF)和特征提取
上一篇中,主要说的就是词袋模型.回顾一下,在进行文本分类之前,我们需要把待分类文本先用词袋模型进行文本表示.首先是将训练集中的所有单词经过去停用词之后组合成一个词袋,或者叫做字典,实际上一个维度很大的 ...
- 信息检索中的TF/IDF概念与算法的解释
https://blog.csdn.net/class_brick/article/details/79135909 概念 TF-IDF(term frequency–inverse document ...
- Elasticsearch学习之相关度评分TF&IDF
relevance score算法,简单来说,就是计算出,一个索引中的文本,与搜索文本,他们之间的关联匹配程度 Elasticsearch使用的是 term frequency/inverse doc ...
随机推荐
- 读书笔记 Week6 2018-4-12
Chap 24 重构 读书笔记 一.需求的变更 单纯就科目学习中的小项目来说,目标在一开始便被明确下来,即可定义一份严谨的列表来描述功能.故在原来的编程经历中,只要上交了程序便一切都没事儿了,也没有重 ...
- linux安装wifi驱动,开热点
本次安装的debian系统安装的时候提示wifi硬件需要安装非自由固件才能运行,并告诉本硬件要安装的固件名字叫做iwlwifi-2030-6.ucode.是iwlwifi驱动适配我的wireless硬 ...
- UICamera
[UICamera] UICamera是一个命名不太好的组件.实际上,它的名字某种原因只是为了保持向后兼容.UICamera脚本实际做的事是发送NGUI事件给所有被它所附加的摄像机所看见的对象.除此之 ...
- 压缩包法安装mysql
之前一直安装mysql,我一直是用压缩包安装的.如果之前安装过Mysql,必须要删除注册文件,才能把Mysql彻底删除了. 先在官网下载mysql的版本.下载package版本,即.zip版本的.下载 ...
- archives of source
"ubuntu 暂时不能解析域名 archive.ubuntu.com"怎么办? root下输入命令:lsb_release -a用来查询Ubuntu版本号 登录网站 http:/ ...
- fitting 方法的异常值过滤
training = pd.DataFrame({'x':[3,6,9,15,300, 20,85]}). 原始数据training_fitting = pd.DataFrame({'x':[4,7 ...
- HTTP 499状态码 nginx下499错误详解-乾颐堂
日志记录中HTTP状态码出现499错误有多种情况,我遇到的一种情况是nginx反代到一个永远打不开的后端,就这样了,日志状态记录是499.发送字节数是0. 老是有用户反映网站系统时好时坏,因为线上的产 ...
- Greeplum 系列(三) 基本用法
Greeplum 系列(三) 基本用法 <PostgreSQL 教程>:https://www.yiibai.com/postgresql 一.Greeplum 登陆与创建 1.1 登陆 ...
- 3.3.5 高效读取:不变模式下的CopyOnWriteArrayList
源码分析:读写(get,add) 一:get 方法 private E get(Object[] a, int index) { return (E) a[index];}可以看到读取数据的时候 没有 ...
- ping别的电脑出错
原因ifconfig 电脑1:172.31.45.101 电脑2:172.31.188.232 http://ask.csdn.net/questions/178358 如何防止别人ping自己的电脑 ...