
步步深入:MySQL架构总览->查询执行流程->SQL解析顺序
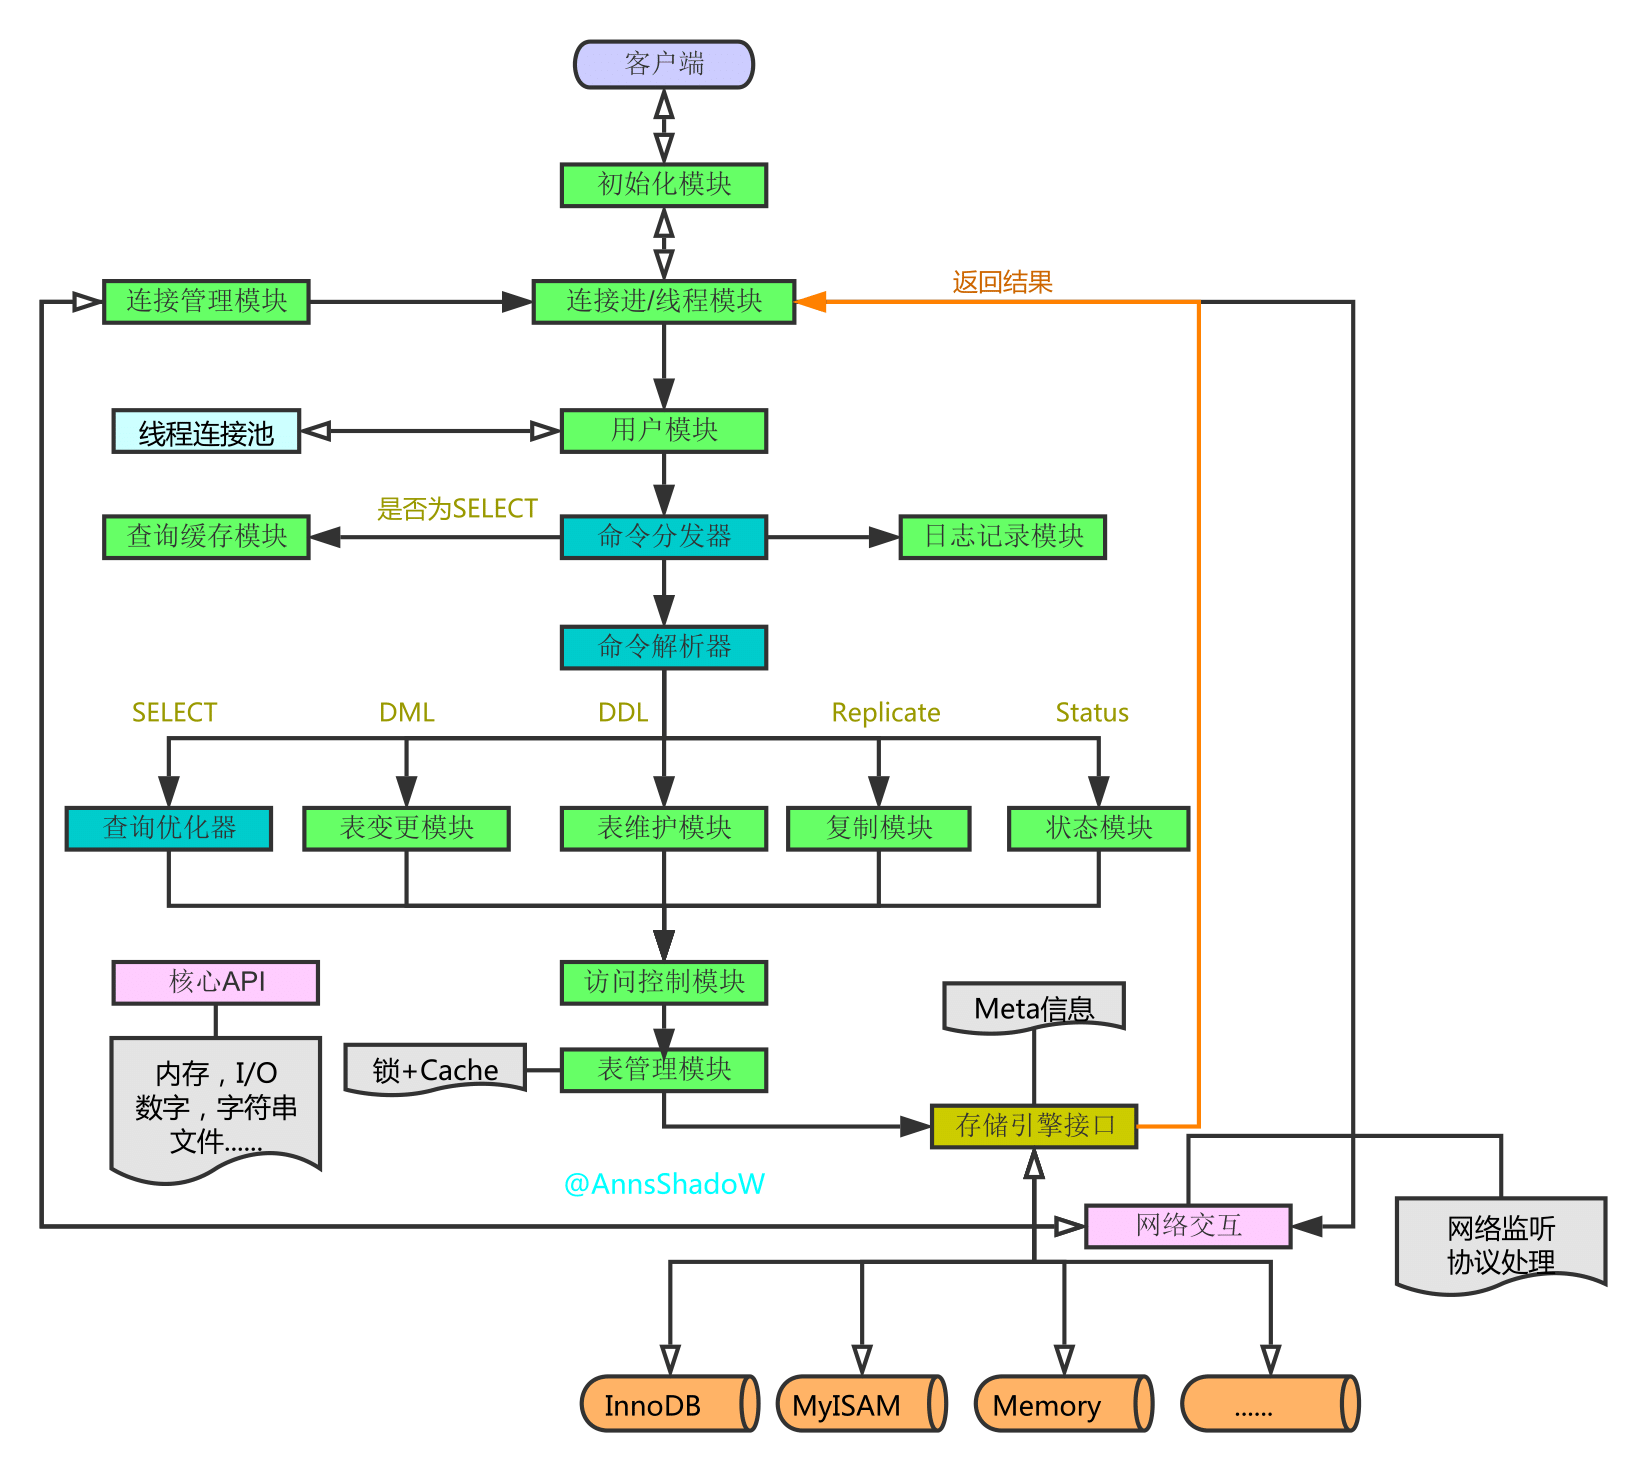
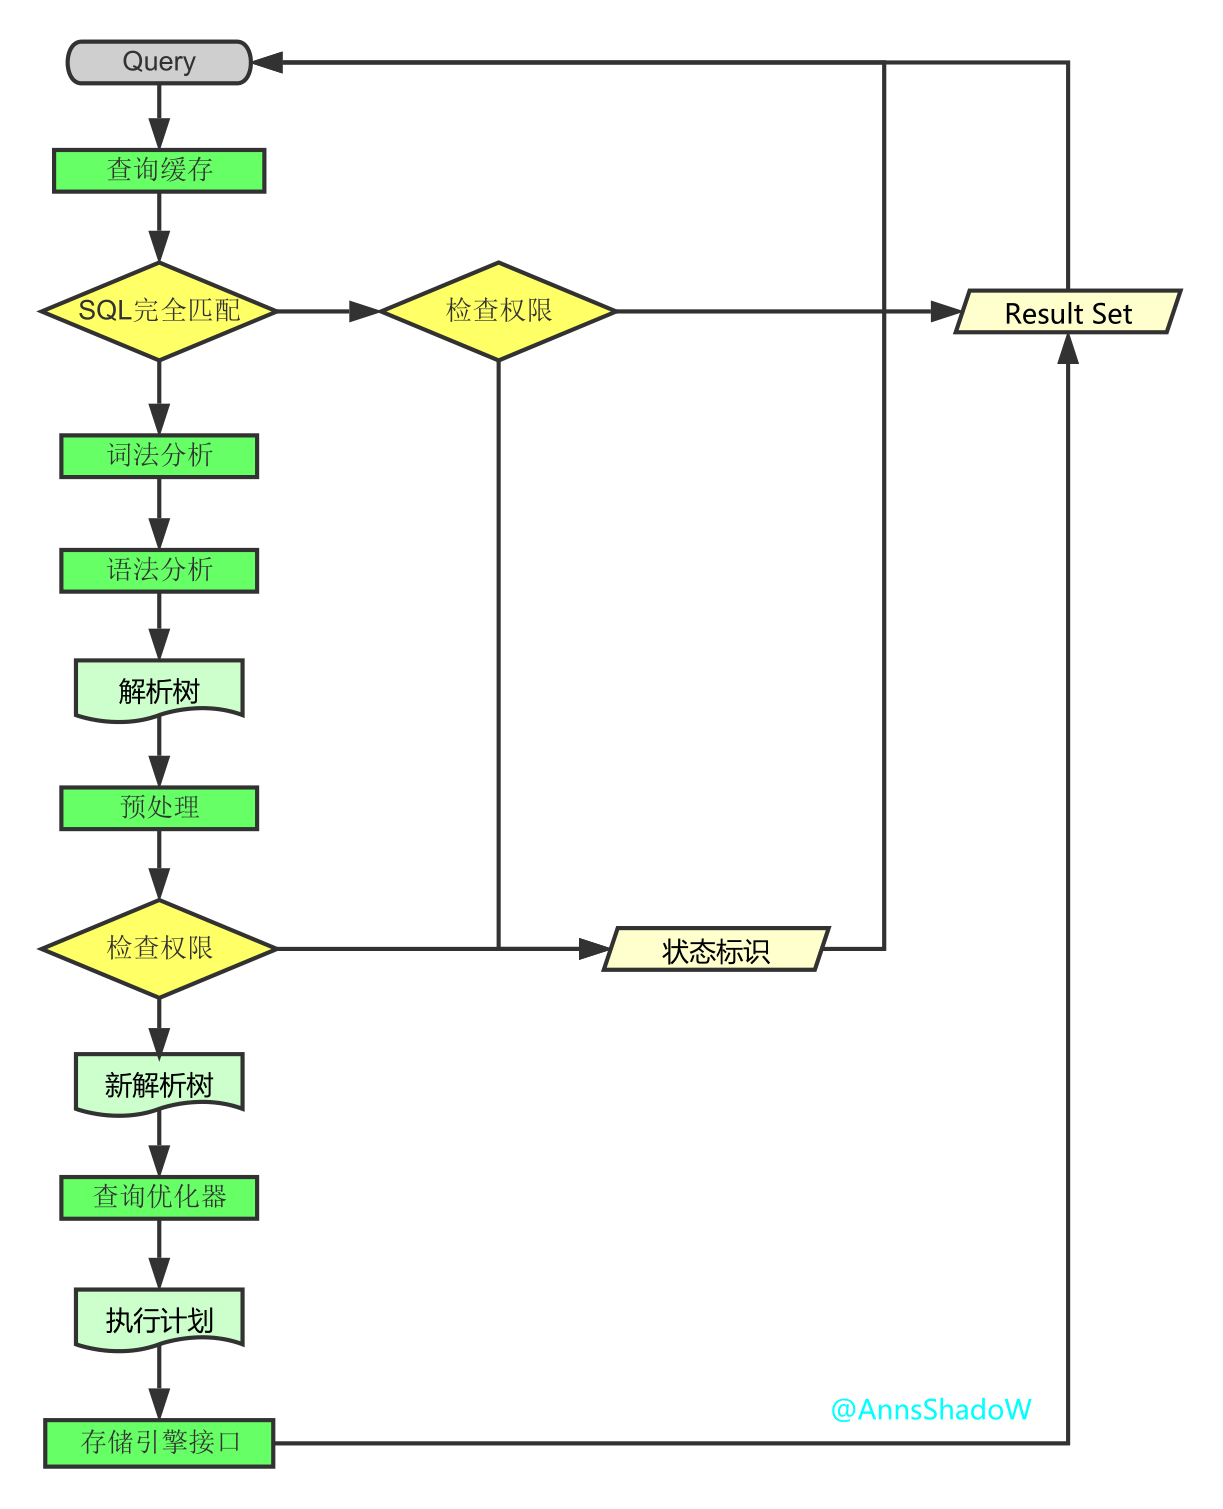
SELECT DISTINCT

    < select_list >

FROM

    < left_table > < join_type >

JOIN < right_table > ON < join_condition >

WHERE

    < where_condition >

GROUP BY

    < group_by_list >

HAVING

    < having_condition >

ORDER BY

    < order_by_condition >

LIMIT < limit_number >
 FROM <left_table>

 ON <join_condition>

 <join_type> JOIN <right_table>

 WHERE <where_condition>

 GROUP BY <group_by_list>

 HAVING <having_condition>

 SELECT

 DISTINCT <select_list>

 ORDER BY <order_by_condition>

 LIMIT <limit_number>
create database testQuery
CREATE TABLE table1

(

    uid VARCHAR(10) NOT NULL,

    name VARCHAR(10) NOT NULL,

    PRIMARY KEY(uid)

)ENGINE=INNODB DEFAULT CHARSET=UTF8;

CREATE TABLE table2

(

    oid INT NOT NULL auto_increment,

    uid VARCHAR(10),

    PRIMARY KEY(oid)

)ENGINE=INNODB DEFAULT CHARSET=UTF8;
INSERT INTO table1(uid,name) VALUES('aaa','mike'),('bbb','jack'),('ccc','mike'),('ddd','mike');

INSERT INTO table2(uid) VALUES('aaa'),('aaa'),('bbb'),('bbb'),('bbb'),('ccc'),(NULL);
SELECT

    a.uid,

    count(b.oid) AS total

FROM

    table1 AS a

LEFT JOIN table2 AS b ON a.uid = b.uid

WHERE

    a. NAME = 'mike'

GROUP BY

    a.uid

HAVING

    count(b.oid) < 2

ORDER BY

    total DESC

LIMIT 1;
mysql> select * from table1,table2;

+-----+------+-----+------+

| uid | name | oid | uid  |

+-----+------+-----+------+

| aaa | mike |   1 | aaa  |

| bbb | jack |   1 | aaa  |

| ccc | mike |   1 | aaa  |

| ddd | mike |   1 | aaa  |

| aaa | mike |   2 | aaa  |

| bbb | jack |   2 | aaa  |

| ccc | mike |   2 | aaa  |

| ddd | mike |   2 | aaa  |

| aaa | mike |   3 | bbb  |

| bbb | jack |   3 | bbb  |

| ccc | mike |   3 | bbb  |

| ddd | mike |   3 | bbb  |

| aaa | mike |   4 | bbb  |

| bbb | jack |   4 | bbb  |

| ccc | mike |   4 | bbb  |

| ddd | mike |   4 | bbb  |

| aaa | mike |   5 | bbb  |

| bbb | jack |   5 | bbb  |

| ccc | mike |   5 | bbb  |

| ddd | mike |   5 | bbb  |

| aaa | mike |   6 | ccc  |

| bbb | jack |   6 | ccc  |

| ccc | mike |   6 | ccc  |

| ddd | mike |   6 | ccc  |

| aaa | mike |   7 | NULL |

| bbb | jack |   7 | NULL |

| ccc | mike |   7 | NULL |

| ddd | mike |   7 | NULL |

+-----+------+-----+------+

28 rows in set (0.00 sec)
mysql> SELECT

    -> *

    -> FROM

    -> table1,

    -> table2

    -> WHERE

    -> table1.uid = table2.uid

    -> ;

+-----+------+-----+------+

| uid | name | oid | uid  |

+-----+------+-----+------+

| aaa | mike |   1 | aaa  |

| aaa | mike |   2 | aaa  |

| bbb | jack |   3 | bbb  |

| bbb | jack |   4 | bbb  |

| bbb | jack |   5 | bbb  |

| ccc | mike |   6 | ccc  |

+-----+------+-----+------+

6 rows in set (0.00 sec)
mysql> SELECT

    -> *

    -> FROM

    -> table1 AS a

    -> LEFT OUTER JOIN table2 AS b ON a.uid = b.uid;

+-----+------+------+------+

| uid | name | oid  | uid  |

+-----+------+------+------+

| aaa | mike |    1 | aaa  |

| aaa | mike |    2 | aaa  |

| bbb | jack |    3 | bbb  |

| bbb | jack |    4 | bbb  |

| bbb | jack |    5 | bbb  |

| ccc | mike |    6 | ccc  |

| ddd | mike | NULL | NULL |

+-----+------+------+------+

7 rows in set (0.00 sec)

mysql> SELECT

    -> *

    -> FROM

    -> table1 AS a

    -> LEFT OUTER JOIN table2 AS b ON a.uid = b.uid

    -> WHERE

    -> a. NAME = 'mike';

+-----+------+------+------+

| uid | name | oid  | uid  |

+-----+------+------+------+

| aaa | mike |    1 | aaa  |

| aaa | mike |    2 | aaa  |

| ccc | mike |    6 | ccc  |

| ddd | mike | NULL | NULL |

+-----+------+------+------+

4 rows in set (0.00 sec)
mysql> SELECT

    -> *

    -> FROM

    -> table1 AS a

    -> LEFT OUTER JOIN table2 AS b ON a.uid = b.uid

    -> WHERE

    -> a. NAME = 'mike'

    -> GROUP BY

    -> a.uid;

+-----+------+------+------+

| uid | name | oid  | uid  |

+-----+------+------+------+

| aaa | mike |    1 | aaa  |

| ccc | mike |    6 | ccc  |

| ddd | mike | NULL | NULL |

+-----+------+------+------+

3 rows in set (0.00 sec)
mysql> SELECT

    -> *

    -> FROM

    -> table1 AS a

    -> LEFT OUTER JOIN table2 AS b ON a.uid = b.uid

    -> WHERE

    -> a. NAME = 'mike'

    -> GROUP BY

    -> a.uid

    -> HAVING

    -> count(b.oid) < 2;

+-----+------+------+------+

| uid | name | oid  | uid  |

+-----+------+------+------+

| ccc | mike |    6 | ccc  |

| ddd | mike | NULL | NULL |

+-----+------+------+------+

2 rows in set (0.00 sec)
mysql> SELECT

    -> a.uid,

    -> count(b.oid) AS total

    -> FROM

    -> table1 AS a

    -> LEFT OUTER JOIN table2 AS b ON a.uid = b.uid

    -> WHERE

    -> a. NAME = 'mike'

    -> GROUP BY

    -> a.uid

    -> HAVING

    -> count(b.oid) < 2;

+-----+-------+

| uid | total |

+-----+-------+

| ccc |     1 |

| ddd |     0 |

+-----+-------+

2 rows in set (0.00 sec)
mysql> SELECT

    -> a.uid,

    -> count(b.oid) AS total

    -> FROM

    -> table1 AS a

    -> LEFT OUTER JOIN table2 AS b ON a.uid = b.uid

    -> WHERE

    -> a. NAME = 'mike'

    -> GROUP BY

    -> a.uid

    -> HAVING

    -> count(b.oid) < 2

    -> ORDER BY

    -> total DESC;

+-----+-------+

| uid | total |

+-----+-------+

| ccc |     1 |

| ddd |     0 |

+-----+-------+

2 rows in set (0.00 sec)
mysql> SELECT

    -> a.uid,

    -> count(b.oid) AS total

    -> FROM

    -> table1 AS a

    -> LEFT JOIN table2 AS b ON a.uid = b.uid

    -> WHERE

    -> a. NAME = 'mike'

    -> GROUP BY

    -> a.uid

    -> HAVING

    -> count(b.oid) < 2

    -> ORDER BY

    -> total DESC

    -> LIMIT 1;

+-----+-------+

| uid | total |

+-----+-------+

| ccc |     1 |

+-----+-------+

1 row in set (0.00 sec)

步步深入:MySQL架构总览->查询执行流程->SQL解析顺序的更多相关文章
- MySQL架构总览->查询执行流程->SQL解析顺序
Reference: https://www.cnblogs.com/annsshadow/p/5037667.html 前言: 一直是想知道一条SQL语句是怎么被执行的,它执行的顺序是怎样的,然后 ...
- 步步深入:MySQL架构总览->查询执行流程->SQL解析顺序(转)
文章转自 http://www.cnblogs.com/annsshadow/p/5037667.html https://www.cnblogs.com/cuisi/p/7685893.html
- 步步深入MySQL:架构->查询执行流程->SQL解析顺序!
一.前言 一直是想知道一条SQL语句是怎么被执行的,它执行的顺序是怎样的,然后查看总结各方资料,就有了下面这一篇博文了. 本文将从MySQL总体架构--->查询执行流程--->语句执行顺序 ...
- 让MySQL为我们记录执行流程
让MySQL为我们记录执行流程 我们可以开启profiling,让MySQL为我们记录SQL语句的执行流程 查看profiling参数 shell > select @@profilin ...
- mysql join语句的执行流程是怎么样的
mysql join语句的执行流程是怎么样的 join语句是使用十分频繁的sql语句,同样结果的join语句,写法不同会有非常大的性能差距. select * from t1 straight_joi ...
- MySQL深层理解,执行流程
MySQL是一个关系型数据库,关联的数据保存在不同的表中,增加了数据操作的灵活性. 执行流程 MySQL是一个单进程服务,每一个请求用线程来响应, 流程: 1,客户请求,服务器开辟一个线程响应用户. ...
- Spark架构与作业执行流程简介(scala版)
在讲spark之前,不得不详细介绍一下RDD(Resilient Distributed Dataset),打开RDD的源码,一开始的介绍如此: 字面意思就是弹性分布式数据集,是spark中最基本的数 ...
- mysql update语句的执行流程是怎样的
update更新语句流程是怎么样的 update更新语句基本流程也会查询select流程一样,都会走一遍. update涉及更新数据,会对行加dml写锁,这个DML读锁是互斥的.其他dml写锁需要等待 ...
- SQL学习笔记四(补充-1-1)之MySQL单表查询补充部分:SQL逻辑查询语句执行顺序
阅读目录 一 SELECT语句关键字的定义顺序 二 SELECT语句关键字的执行顺序 三 准备表和数据 四 准备SQL逻辑查询测试语句 五 执行顺序分析 一 SELECT语句关键字的定义顺序 SELE ...
随机推荐
- ABP源码分析六:依赖注入的实现
ABP的依赖注入的实现有一个本质两个途径:1.本质上是依赖于Castle这个老牌依赖注入的框架.2.一种实现途径是通过实现IConventionalDependencyRegistrar的实例定义注入 ...
- Android之SQLite数据库篇
一.SQLite简介 Google为Andriod的较大的数据处理提供了SQLite,他在数据存储.管理.维护等各方面都相当出色,功能也非常的强大. 二.SQLite的特点 1.轻量级使用 SQLit ...
- C#,.Net 学习资源
原文:http://blog.csdn.net/chinacsharper/article/details/17514923一.网站1.http://msdn.microsoft.com/zh-CN/ ...
- Java学习笔记(05)
目录: static的用法 主函数的定义 增强for的循环 单例设计模式 封装 一.Static的用法 1.对象的内存分析 对象的引用变量是存在于栈区,而在堆区开辟了一块内存空间,调用对象给成员变量赋 ...
- Oracle PL/SQL随堂笔记总结
1.pl/sql编程 2.存储过程 3.函数 4.触发器 5.包 6.pl/sql基础 -定义并使用变量 7.pl/sql的进阶 8.oracle的视图 1.pl/sql编程 1.理解oracle的p ...
- 计算机网络学习笔记--数据链据层之MAC子层(整理)
概述: 为什么需要介质访问控制子层(MAC)? 介质访问控制子层(MAC)是局域网体系结构中划分的子层,多路访问链路采用共享介质连接所有站点.发送站点通过广播方式发送数据并占用整个带宽,如果有多个站点 ...
- java多线程--同步屏障CyclicBarrier的使用
CyclicBarrier的概念理解: CyclicBarrier的字面上的意思是可循环的屏障,是java并发包java.util.concurrent 里的一个同步工具类,在我下载的JDK1.6的中 ...
- 利用Python进行数据分析(15) pandas基础: 字符串操作
字符串对象方法 split()方法拆分字符串: strip()方法去掉空白符和换行符: split()结合strip()使用: "+"符号可以将多个字符串连接起来: join( ...
- asp.net core 依赖注入问题
最近.net core可以跨平台了,这是一个伟大的事情,为了可以赶上两年以后的跨平台部署大潮,我也加入到了学习之列.今天研究的是依赖注入,但是我发现一个问题,困扰我很久,现在我贴出来,希望可以有人帮忙 ...
- css3新单位学习
vw,vh,vmin,vmax vw 1vw = 视窗width*1% vh 1vh = 视窗heihgt*1% 如果视窗的宽度小于高度,1vmin = 1vw,如果视窗宽度大于高度,1vmin = ...