
python爬取QQVIP音乐
QQ音乐相比于网易云音乐加密部分基本上没有,但是就是QQ音乐的页面与页面之间的联系太强了,,导致下载一个音乐需要分析前面多个页面,找数据。。太繁琐了
1、爬取链接:https://y.qq.com/
首先随便找一个页面先点进去

2、点击播放歌曲会打开一个页面,按F12打开控制台,然后刷新页面并点击播放歌曲,network里面就会有数据包
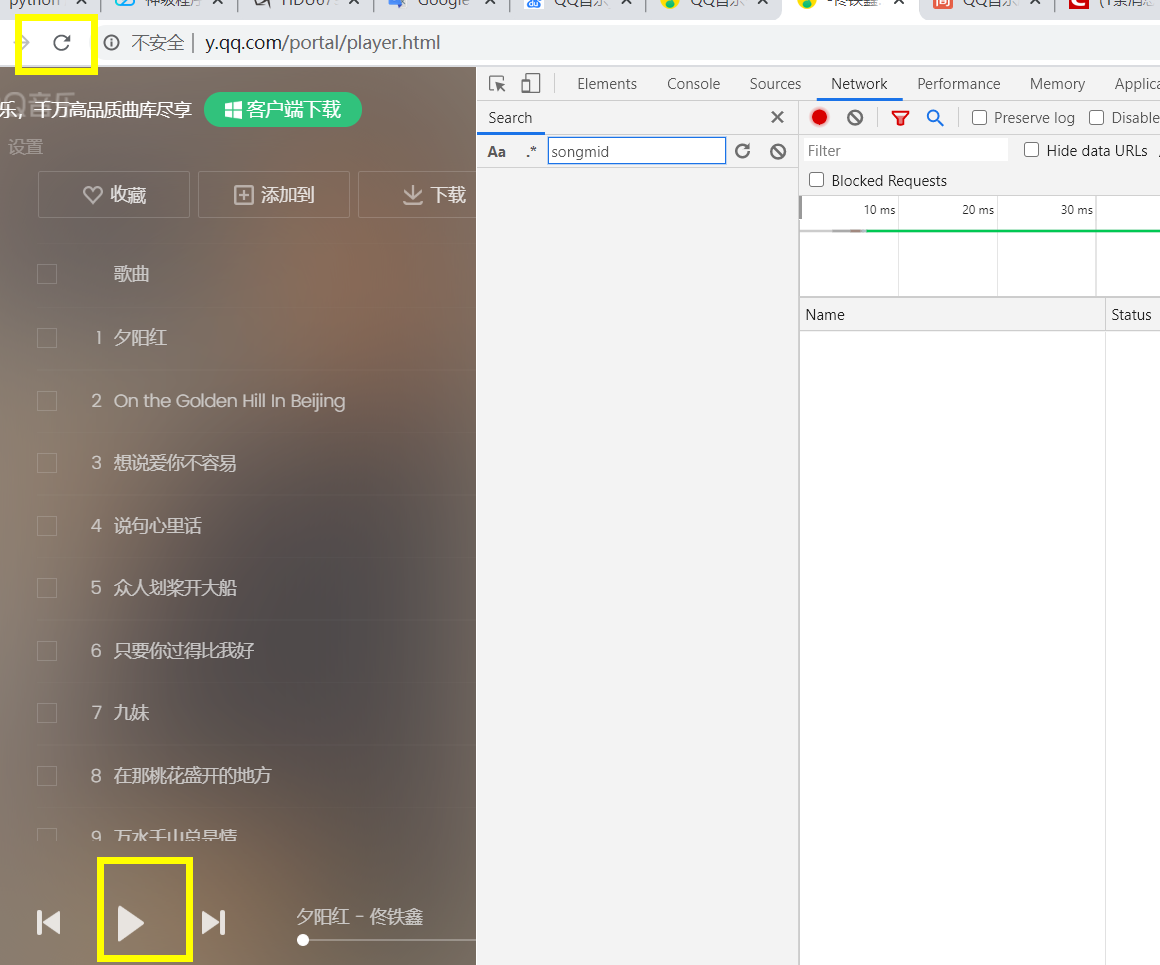
3、在控制台选中media,找到下图这样类型的文件,它的request url就是歌曲播放url,如下下图

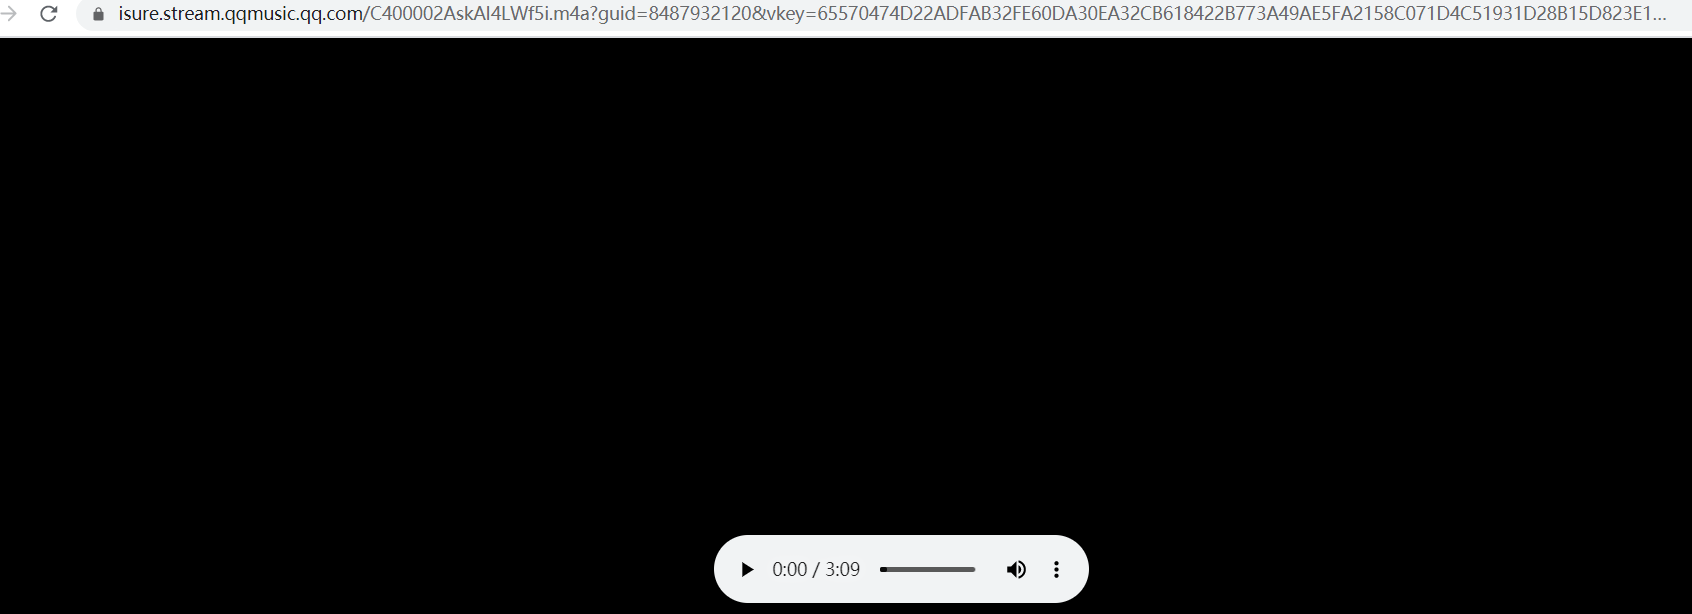
当然,我们肯定不能每下载一首歌都这样,一是这样很麻烦,二是遇到vip等音乐,你在线都不能播放,你还怎么找到歌曲链接
所以,分析页面是必然的!!!我们首先分析一下这个歌曲播放链接的url
https://isure.stream.qqmusic.qq.com/C400002AskAI4LWf5i.m4a?guid=8487932120&vkey=65570474D22ADFAB32FE60DA30EA32CB618422B773A49AE5FA2158C071D4C51931D28B15D823E1BA87BCA837EC09A0FCF8BD9E2763D46B91&uin=0&fromtag=66
我们对这个url进行删减(因为url有些部分都不需要,我们为了看起来更直观要对其进行处理)
#精简后url

https://isure.stream.qqmusic.qq.com/C400002AskAI4LWf5i.m4a?guid=8487932120&vkey=65570474D22ADFAB32FE60DA30EA32CB618422B773A49AE5FA2158C071D4C51931D28B15D823E1BA87BCA837EC09A0FCF8BD9E2763D46B91
我们大致一看它的url,就知道页面提交用get将参数guid和vkey追加到url地址后面,那么我们就要去找vkey和guid参数是怎么来的
guid参数:
你多打开几个歌曲就会发现它的guid都是一样的,所以这个我们就不用管
vkey参数:
这个参数难为死我了,我刚开始以为它和网易云音乐一样也是加密一下,然后我就去js文件里面找,找了半天没找到赋值语句,我就纳闷了,以为这是更高级的加密,,,,然后看了半天js,最后终于确定,js和这个没啥关系。。。。。。。
之后感觉分析页面分析不动了,上网找了篇博客给了我灵感,虽然那篇博客代码已经过时了,但是它启发了我 “播放歌曲的链接可能不止一个”
于是我又开始找vkey在哪个数据包出现过,如下图

我找到了vkey且对比了一下和之前链接上vkey的值一样,你再仔细看就会发现那个歌曲下载链接就是
https://isure.stream.qqmusic.qq.com/加上purl的值。(我giao!!)
然后就要去分析这个数据包的请求头了(呜呜呜~),请求头如下(好长~~~)
https://u.y.qq.com/cgi-bin/musics.fcg?-=getplaysongvkey6574047973093009&g_tk=1740745507&sign=zzaztgck8xaqpsxorw45ed952a339dbe91c7990f803cb9a6f1&loginUin=0&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8¬ice=0&platform=yqq.json&needNewCode=0&data=%7B%22req_0%22%3A%7B%22module%22%3A%22vkey.GetVkeyServer%22%2C%22method%22%3A%22CgiGetVkey%22%2C%22param%22%3A%7B%22guid%22%3A%228487932120%22%2C%22songmid%22%3A%5B%22003cGaJY10RAsX%22%5D%2C%22songtype%22%3A%5B0%5D%2C%22uin%22%3A%220%22%2C%22loginflag%22%3A1%2C%22platform%22%3A%2220%22%7D%7D%2C%22comm%22%3A%7B%22uin%22%3A0%2C%22format%22%3A%22json%22%2C%22ct%22%3A24%2C%22cv%22%3A0%7D%7D
这个时候我就遇到一个坑点(QQ音乐有毒),这么长的链接我们肯定要对其进行删减,好看看哪些参数有用,哪些参数用来混乱我们的视线
但是如果你前面的一段链接改为
https://u.y.qq.com/cgi-bin/musicu
你就能对很多参数进行删除,就最后一个字母不一样,但是对参数进行删除的时候前面那个链接就基本上参数都不能删除
这让我就很难受,我的访问链接就是
https://u.y.qq.com/cgi-bin/musics
这一部分,但是有些人访问链接是
https://u.y.qq.com/cgi-bin/musicu
化简之后链接就变成了
https://u.y.qq.com/cgi-bin/musicu.fcg?format=json&data=%7B%22req_0%22%3A%7B%22module%22%3A%22vkey.GetVkeyServer%22%2C%22method%22%3A%22CgiGetVkey%22%2C%22param%22%3A%7B%22guid%22%3A%22358840384%22%2C%22songmid%22%3A%5B%22{}%22%5D%2C%22songtype%22%3A%5B0%5D%2C%22uin%22%3A%221443481947%22%2C%22loginflag%22%3A1%2C%22platform%22%3A%2220%22%7D%7D%2C%22comm%22%3A%7B%22uin%22%3A%2218585073516%22%2C%22format%22%3A%22json%22%2C%22ct%22%3A24%2C%22cv%22%3A0%7D%7D".format(mid值)
与其他歌曲的这个链接对比一下就会发现只有songmid的值再改变
我们再去找songmid是什么,疯狂在文件中寻找,结果没有songmid字样,有也是在js中,songmid在js中还多以注释出现。。。
之后我在搜索歌曲之后,在歌曲信息的数据包里面发现了mid,然后我把url地址中编码过的mid解码后发现它们一样。。。(牛掰!!!)
下面给一个在多个文件中快速搜索关键子字的方法,如下图:
在线url解码:http://tool.chinaz.com/tools/urlencode.aspx
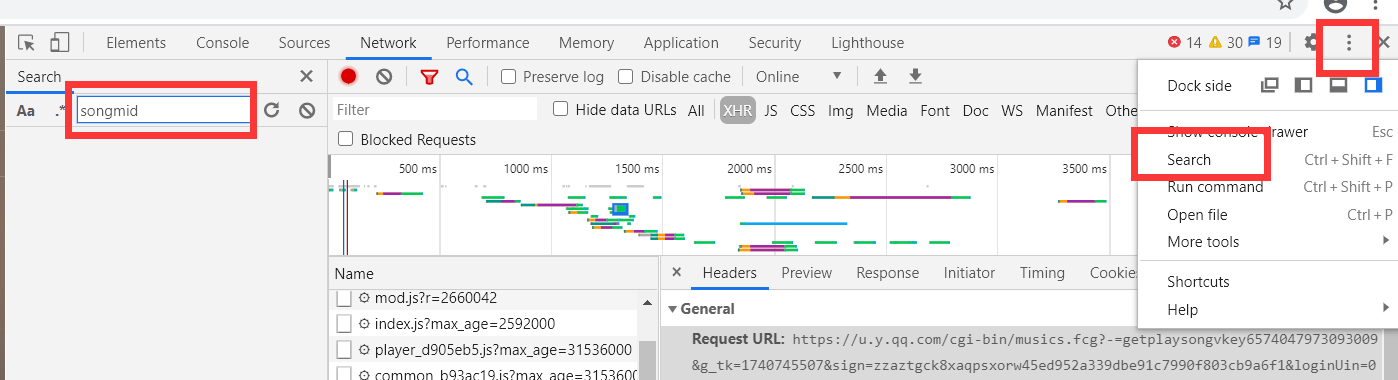
以搜索“夕阳红为例”
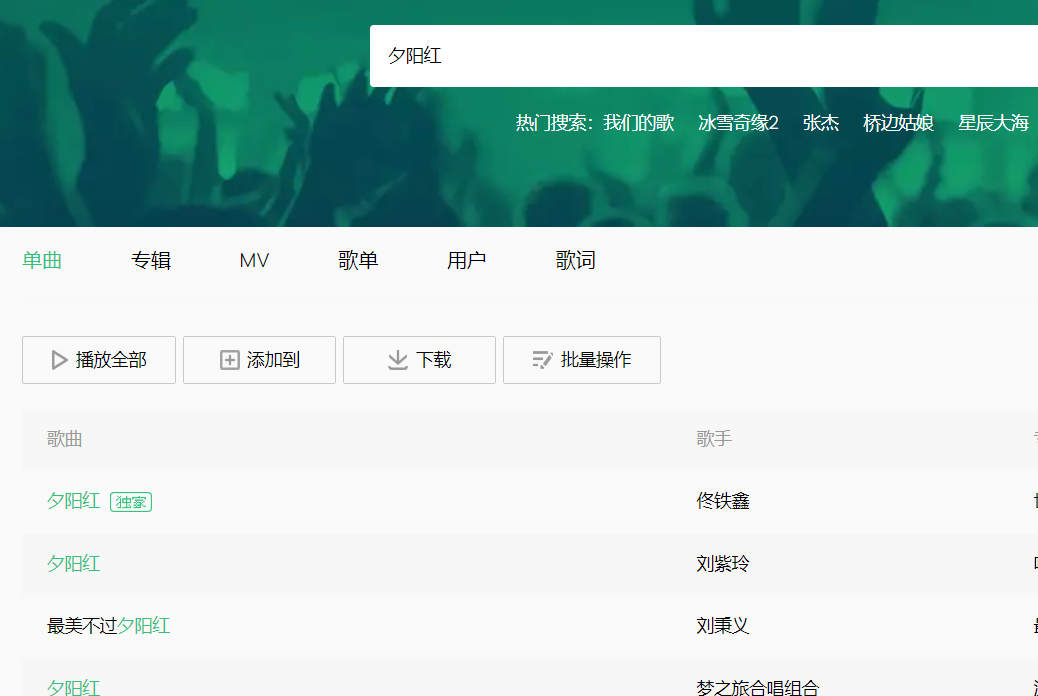
数据包list字段下面就是歌曲信息
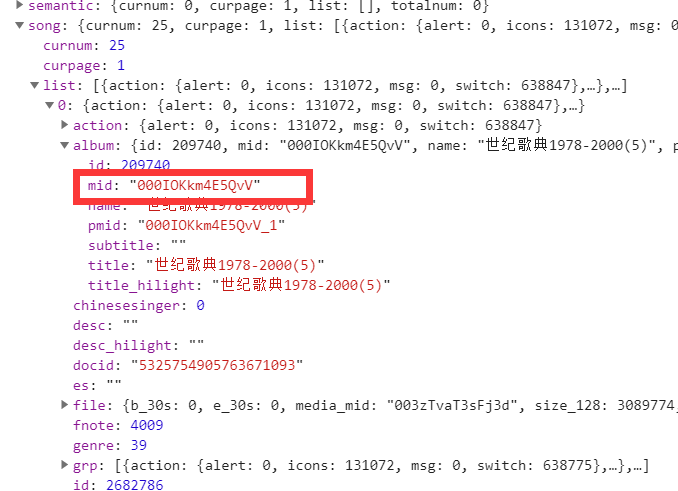
然后再看一下这个数据包的请求头(希望不要麻烦)
https://c.y.qq.com/soso/fcgi-bin/client_search_cp?ct=24&qqmusic_ver=1298&new_json=1&remoteplace=txt.yqq.song&searchid=70921863029222715&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag_qc=0&p=1&n=10&w=%E5%A4%95%E9%98%B3%E7%BA%A2&g_tk_new_20200303=1740745507&g_tk=1740745507&loginUin=0&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8¬ice=0&platform=yqq.json&needNewCode=0
删减之后
https://c.y.qq.com/soso/fcgi-bin/client_search_cp?ct=24&qqmusic_ver=1298&new_json=1&remoteplace=txt.yqq.song&searchid=70631360004412645&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag_qc=0&p=1&n=10&w=%E9%9D%9E%E9%B1%BC&g_tk_new_20200303=5381&g_tk=5381&loginUin=2272463882&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8¬ice=0&platform=yqq.json&needNewCode=0
通过归纳可以知道n代表搜索到的歌曲显示数目,w是搜索的关键字
所以我们n设定一个值就行,w就运行程序是输入就行
所有问题都解决了(呼~~~~~~~)
import requests
import re
import os
import json
import time as t class QQmusic():
"""代码仅供学习""" def __init__(self):
"""初始化"""
self.headers = {
'Accept-Encoding': 'gzip, deflate, sdch',
'Accept-Language': 'en-US,en;q=0.8',
'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.95 Safari/537.36',
'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
'Referer': 'http://www.baidu.com/',
'Connection': 'keep-alive',
}
self.names = []
self.order = ' ' def search(self):
"""搜索"""
w = input("请输入歌曲名: ")
url_0 = "https://c.y.qq.com/soso/fcgi-bin/client_search_cp?ct=24&qqmusic_ver=1298&new_json=1&remoteplace=txt.yqq.song&searchid=61460539676714578&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag_qc=0&p=1&n=10&w={0}&g_tk_new_20200303=5381&g_tk=5381&loginUin=0&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8¬ice=0&platform=yqq.json&needNewCode=0".format(
w)
res_0 = requests.get(url_0, headers=self.headers) # 第一层,搜索页
res_0.encoding = res_0.apparent_encoding
res_0 = res_0.json() # dict
music_list = res_0["data"]["song"]["list"]
print("共计" + str(len(music_list)) + "结果: ") all_singers = []
a = 0
for music in music_list:
singer = music["singer"][0]["title"] # 歌手名
name = str(a) + " " + music["title"] # 歌曲名
all_singers.append(singer)
self.names.append(name)
a = a + 1
infs = dict(zip(self.names, all_singers))
infs = json.dumps(infs, ensure_ascii=False, indent=4, separators=(',', ':'))
infs = infs.replace('"', ' ')
infs = infs.replace(':', '——————')
print(infs) self.order = input("请输入歌曲前的序号:")
songmid = res_0['data']['song']['list'][int(self.order)]['mid']
url_1 = "https://u.y.qq.com/cgi-bin/musicu.fcg?format=json&data=%7B%22req_0%22%3A%7B%22module%22%3A%22vkey.GetVkeyServer%22%2C%22method%22%3A%22CgiGetVkey%22%2C%22param%22%3A%7B%22guid%22%3A%22358840384%22%2C%22songmid%22%3A%5B%22{}%22%5D%2C%22songtype%22%3A%5B0%5D%2C%22uin%22%3A%221443481947%22%2C%22loginflag%22%3A1%2C%22platform%22%3A%2220%22%7D%7D%2C%22comm%22%3A%7B%22uin%22%3A%2218585073516%22%2C%22format%22%3A%22json%22%2C%22ct%22%3A24%2C%22cv%22%3A0%7D%7D".format(songmid) res_1 = requests.get(url_1, headers=self.headers)
res_1.encoding = res_1.apparent_encoding
res_1 = res_1.json() # dict
purl = res_1['req_0']['data']['midurlinfo'][0]['purl']
url_2 = "https://isure.stream.qqmusic.qq.com/" + purl
return url_2 def download(self):
"""下载"""
res_2 = requests.get(self.search(), headers=self.headers).content
fir = self.names[int(self.order)]
tit = re.sub(r'\d+', '', fir)
now = os.getcwd()
now = os.path.join(now, "qq音乐 ")
if not os.path.exists(now):
os.mkdir(now)
os.chdir(now)
file_name = tit + '.m4a'
with open(file_name, 'wb') as f:
f.write(res_2) one_file = QQmusic()
one_file.download()
python爬取QQVIP音乐的更多相关文章
- Python爬取豆瓣音乐存储MongoDB数据库(Python爬虫实战1)
1. 爬虫设计的技术 1)数据获取,通过http获取网站的数据,如urllib,urllib2,requests等模块: 2)数据提取,将web站点所获取的数据进行处理,获取所需要的数据,常使用的技 ...
- python爬取酷我音乐
我去!!!我之后一定按照搜索方式下载歌曲~~~~~~~~~ 1.首先打开我们本次主讲链接:http://www.kuwo.cn/ 2.刚开始我就随便点了一个地方,然后开始在后台找歌曲的链接地址.但是 ...
- Python 爬取qqmusic音乐url并批量下载
qqmusic上的音乐还是不少的,有些时候想要下载好听的音乐,但有每次在网页下载都是烦人的登录什么的.于是,来了个qqmusic的爬虫. 至少我觉得for循环爬虫,最核心的应该就是找到待爬元素所在ur ...
- python爬取酷我音乐(收费也可)
第一次创作,请多指教 环境:Python3.8,开发工具:Pycharm 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做案例的 ...
- Python爬虫实战一之爬取QQ音乐
一.前言 前段时间尝试爬取了网易云音乐的歌曲,这次打算爬取QQ音乐的歌曲信息.网易云音乐歌曲列表是通过iframe展示的,可以借助Selenium获取到iframe的页面元素, 而QQ音乐采用的是 ...
- 手把手教你使用Python抓取QQ音乐数据(第一弹)
[一.项目目标] 获取 QQ 音乐指定歌手单曲排行指定页数的歌曲的歌名.专辑名.播放链接. 由浅入深,层层递进,非常适合刚入门的同学练手. [二.需要的库] 主要涉及的库有:requests.json ...
- 手把手教你使用Python抓取QQ音乐数据(第二弹)
[一.项目目标] 通过Python爬取QQ音乐数据(一)我们实现了获取 QQ 音乐指定歌手单曲排行指定页数的歌曲的歌名.专辑名.播放链接. 此次我们在之前的基础上获取QQ音乐指定歌曲的歌词及前15个精 ...
- python定时器爬取豆瓣音乐Top榜歌名
python定时器爬取豆瓣音乐Top榜歌名 作者:vpoet mail:vpoet_sir@163.com 注:这些小demo都是前段时间为了学python写的,现在贴出来纯粹是为了和大家分享一下 # ...
- python爬取酷狗音乐排行榜
本文为大家分享了python爬取酷狗音乐排行榜的具体代码,供大家参考,具体内容如下
随机推荐
- 【C++】《C++ Primer 》第十章
第十章 泛型算法 一.概述 因为它们实现共同的操作,所以称之为"算法".而"泛型",指的是它们可以操作在多种容器类型上. 泛型算法并不直接操作容器,而是遍历由两 ...
- Selenium WebDriver 定位之Xpath定位
Selenium 定位之Xpath定位: 1.绝对路径定位:以/开头从根节点一直找到当前节点,不推荐使用决定路径定位方式 2.相对路径定位:使用"//"表示相对路径定位,格式:// ...
- Linux性能相关命令
Linux性能相关命令 目录 Linux性能相关命令 1. 查看硬盘相关信息 2. 查看CPU相关信息 3. 查看内存相关信息 4. 查看进程运行的信息 1. 查看硬盘相关信息 cat /proc/s ...
- 【Python】部署上手App后端服务器 - Linux环境搭建安装Python、Tornado、SQLAlchemy
基于阿里云服务器端环境搭建 文章目录 基于阿里云服务器端环境搭建 配置开发环境 安装 Python 3.8.2 安装 Tornado 安装 MySQL 安装 mysqlclient 安装 SQLAlc ...
- 【Java】集合框架(List Set Map)
文章目录 集合框架 List(列表) ArrayList 案例 Set HashSet 案例 iterator(迭代器) Map HashMap 案例 集合总结 参考资料 重新搞一波 复习巩固 简单记 ...
- kubernets之configMap和secret
一 如何有效且更好的将配置写到pod的容器中 考虑一个问题,就是在传统的应用中,程序里面需要的配置一般以配置文件的形式或者shell脚本里面的参数是在执行的时候在命令行里面进行添加,但是在kuber ...
- Unsafe Fileupload - Pikachu
概述: 文件上传功能在web应用系统很常见,比如很多网站注册的时候需要上传头像.上传附件等等.当用户点击上传按钮后,后台会对上传的文件进行判断 比如是否是指定的类型.后缀名.大小等等,然后将其按照设计 ...
- C语言逗号运算符(C语言学习笔记)
什么是逗号运算符 逗号运算符 逗号运算符是指在C语言中,多个表达式可以用逗号分开,其中用逗号分开的表达式的值分别结算,但整个表达式的值是最后一个表达式的值. 用法 多个变量赋值 原因:"=& ...
- oracle编译表上失效USERDBY脚本
对表进行DLL操作之后,依赖这个表的一些存储过程,触发器等会失效,可以用下边的脚本进行重编译 /* Formatted on 2020/7/8 上午 09:31:31 (QP5 v5.163.1008 ...
- 前端知识(二)05-Eslint语法规范检查-谷粒学院
目录 一.ESLint简介 二.启用ESLint 1.ESLint插件安装 2.插件的扩展设置 3.确认开启语法检查 三.ESLint规则说明 1.规则说明 2.语法规则 一.ESLint简介 ESL ...