
PRML读书笔记——3 Linear Models for Regression
Linear Basis Function Models
线性模型的一个关键属性是它是参数的一个线性函数,形式如下:

w是参数,x可以是原始的数据,也可以是关于原始数据的一个函数值,这个函数就叫basis function,记作φ(x),于是线性模型可以表示成:
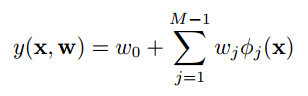
w0看着难受,定义一个函数φ0(x) = 1, 模型的形式再一次简化成:
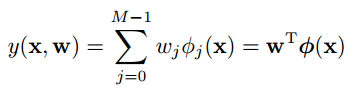
以上就是线性模型的一般形式。basis function有很多选择,例如Gaussian、sigmoid、tanh (tanh(x) = 2 * sigmoid(a) − 1)。
Maximum likelihood and least squares
训练线性模型的时候,假设cost function为sum-of-squares error function,那么minimize cost function 和 maximize likelihood function是等价的。
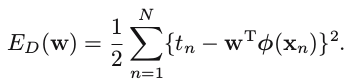
另外一个发现就是,w0最终解出来为target values的均值 和 各个特征的basis function values均值的加权和 的差,如下:
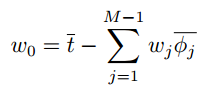
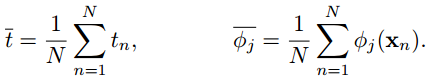
Regularized least squares
一般的正则化形式如下:
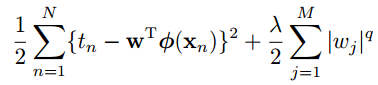
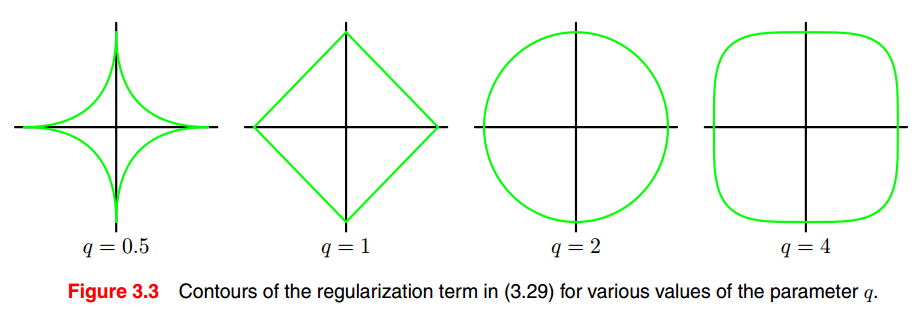
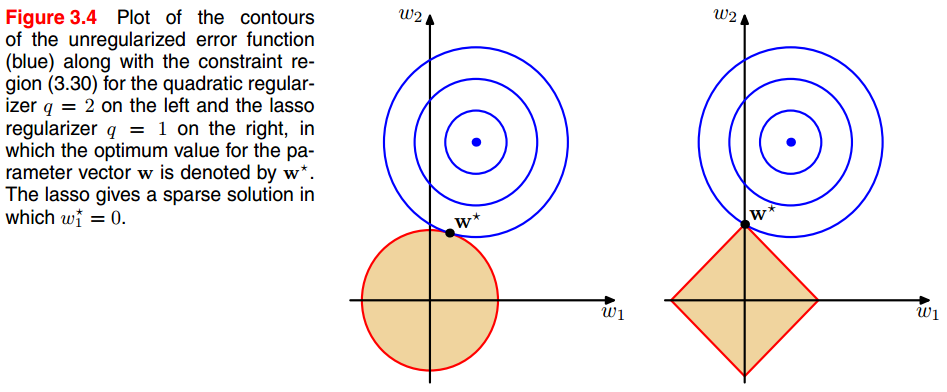
q = 1, 为lasso(least absolute shrinkage and selection operator) 正则化,其特点是,当λ足够大的时候,某些参数会趋向0,看下图。
q = 2, 二次正则化,使得一些参数足够小。
Bias-Variance trade-off
假设y(x, D)代表基于数据集D训练出来的regression function, h(x)代表数据集D中,给定x条件下target value的期望
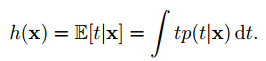
squared loss function可以写成:
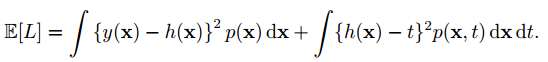
后一项与y(x)无关,考虑前一项积分里面的部分:
{y(x; D) − h(x)}2 = {y(x; D) − ED[y(x; D)] + ED[y(x; D)] − h(x)}2
= {y(x; D) − ED[y(x; D)]}2 + {ED[y(x; D)] − h(x)}2
+2{y(x; D) − ED[y(x; D)]}{ED[y(x; D)] − h(x)}
这样积分取期望后为:
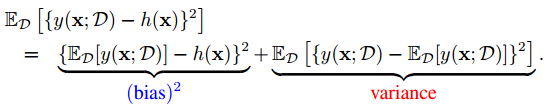
前一项为bias,后一项为variance。
于是loss function的总体希望就为,(bias)2 + variance + noise
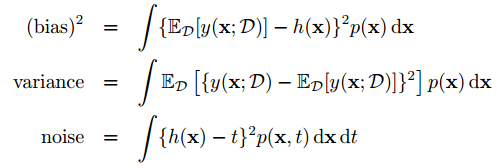
于是就产生了bias-variance trade-off问题, flexible models低bias,高variance;rigid models 高bias,低variance。
在实际应用中,为了观察bias和variance,计算如下:
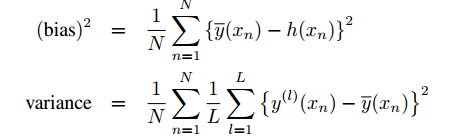
其中:
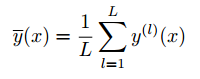
y(l)(x)是prediction function。
Bayesian Linear Regression(该段摘自Jian Xiao(iamxiaojian@gmail.com)的笔记Notes on Pattern Recognition and Machine Learning (Bishop))
Bayesian 方法能够避免 over-fitting 的原因是: Marginalizing over the model parameters instead of making point estimates of their values.
假设有多个 model;观察到的 data set 是 D。 Bayesian 的 model comparison 方法是,比较各个模型的后验概率,即:
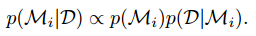
先验概率 p(Mi) allows us to express a preference for different model。可以假设每个模型的先验概率相等,那么剩下要比较的关键是: p(D|Mi) ——model evidence 或 marginal likelihood。
Model averaging V.S. model selection
Model averaging:把多个模型,用各自模型的后验概率加权平均,得到 predictive distribution为
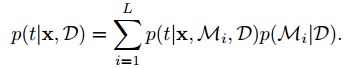
Model selection: 只选择一个模型,即其中后验概率最大的模型。这是一种 approximation to model averaging。以上分析可以看出,各个 model 的后验概率是关键,而计算后验概率的关键又是 model evidence。
从 sampling 的角度看, Mi 相当于 hyper-parameter,而 w 则是 parameter。 一个 model 不同于另一个 model,是因为 hyper-parameter。
The Evidence Approximation
full Bayesian需要marginalize with respect to hyper-parameters as well as parameters,例如hyperparameter是alpha和beta,w是parameter,那么predictive distribution为:
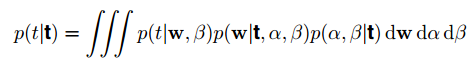
就比较难,这里就考虑一种approximation,给hyperparameters设置一个特定的数值,这个数值由maximizing the marginal likelihood function 来确定。这个方法叫empirical Bayes、 type 2 maximum likelihood、generalized maximum likelihood、evidence approximation(in machine learning)
Previous Chapter | Next Chapter
PRML读书笔记——3 Linear Models for Regression的更多相关文章
- PRML读书笔记——Introduction
1.1. Example: Polynomial Curve Fitting 1. Movitate a number of concepts: (1) linear models: Function ...
- Andrew Ng机器学习公开课笔记 -- Generalized Linear Models
网易公开课,第4课 notes,http://cs229.stanford.edu/notes/cs229-notes1.pdf 前面介绍一个线性回归问题,符合高斯分布 一个分类问题,logstic回 ...
- [Scikit-learn] 1.1 Generalized Linear Models - Logistic regression & Softmax
二分类:Logistic regression 多分类:Softmax分类函数 对于损失函数,我们求其最小值, 对于似然函数,我们求其最大值. Logistic是loss function,即: 在逻 ...
- PRML读书会第三章 Linear Models for Regression(线性基函数模型、正则化方法、贝叶斯线性回归等)
主讲人 planktonli planktonli(1027753147) 18:58:12 大家好,我负责给大家讲讲 PRML的第3讲 linear regression的内容,请大家多多指教,群 ...
- PRML读书笔记——机器学习导论
什么是模式识别(Pattern Recognition)? 按照Bishop的定义,模式识别就是用机器学习的算法从数据中挖掘出有用的pattern. 人们很早就开始学习如何从大量的数据中发现隐藏在背后 ...
- PRML-Chapter3 Linear Models for Regression
Example: Polynomial Curve Fitting The goal of regression is to predict the value of one or more cont ...
- Coursera台大机器学习课程笔记10 -- Linear Models for Classification
这一节讲线性模型,先将几种线性模型进行了对比,通过转换误差函数来将linear regression 和logistic regression 用于分类. 比较重要的是这种图,它解释了为何可以用Lin ...
- [Scikit-learn] 1.1 Generalized Linear Models - Lasso Regression
Ref: http://blog.csdn.net/daunxx/article/details/51596877 Ref: https://www.youtube.com/watch?v=ipb2M ...
- PRML读书笔记——线性回归模型(上)
本章开始学习第一个有监督学习模型--线性回归模型."线性"在这里的含义仅限定了模型必须是参数的线性函数.而正如我们接下来要看到的,线性回归模型可以是输入变量\(x\)的非线性函数. ...
随机推荐
- Android开发 代替 “(XXXX)findViewById()”
public class NActivity extends Activity{ protected void onCreate(Bundle savedInstanceState){ setCont ...
- hdu 3632 A Captivating Match(区间dp)
题目链接:http://acm.split.hdu.edu.cn/showproblem.php?pid=3632 题意:n个人进行比赛,每个人有一个价值a[i],最后冠军只有一个,只能相邻两个人进行 ...
- python 函数传递方式
在python中方法传递的参数到底是值传递还是引用传递? 1. 首先需要知道python中变量的类型:Python的变量分为可变变量和不可变变量. 针对于不可变的类型比如string int def ...
- iOS GCD学习笔记
// 后台执行: dispatch_async(dispatch_get_global_queue(, ), ^{ // something }); // 主线程执行: dispatch_async( ...
- JDBC总结
今天复习了JDBC的内容,古人说温故知新,真的深有体会了.所以决定用自已的话在此记下,如有不对之处,请高手指教. JDBC连接数据库,采用的是面向接口编程.接口在java.sql和javax.sql包 ...
- spring task 配置
Spring对Quartz作了一个封装,同时,Spring自己也提供了一个任务定时器(spring-task),现把它总结一下. 对于Quartz,我们使用的时候主要是注重两个方面,一个是定时任 ...
- sqlserver2008 函数1
SQL2008 表达式:是常量.变量.列或函数等与运算符的任意组合. 1. 字符串函数 函数 名称 参数 示例 说明 ascii(字符串表达式) select ascii('abc') 返回 97 返 ...
- nginx域名隐性(地址栏域名不变)跳转
1.完全url的域名隐性跳转 server_name a.b.com location / { proxy_pass http://x.y.com; } 效果:浏览器地址栏中输入a.b.com域名不变 ...
- DevOps is dirty work - What's the deal
什么是DevOps?终于又回到这个最初的问题. 第一次看到这个词的时候,还身陷于各种敏捷概念轰炸中.用“身陷”这个词其实并不准确,因为那个年代的我也是那些热情洋溢地无处不宣传敏捷的热血文艺青年中的一员 ...
- requestAnimationFrame与setInterval,setTimeout
自打学习canvas动画以来,都说requestAnimationFrame好,就一直用,也没觉得有什么太过于特殊的地方,直到刚才,在写完前面的"小球碰撞墙壁----干掉误差"之后 ...