
[转]Python爬虫html解析工具beautifulSoup在pycharm中安装及失败的解决办法
原文地址:https://www.cnblogs.com/yysbolg/p/9040649.html
刚开始学习一门技术最麻烦的问题就是搞定IDE环境,直接在PyCharm里安装BeautifulSoup报错,让初学者一头雾水;
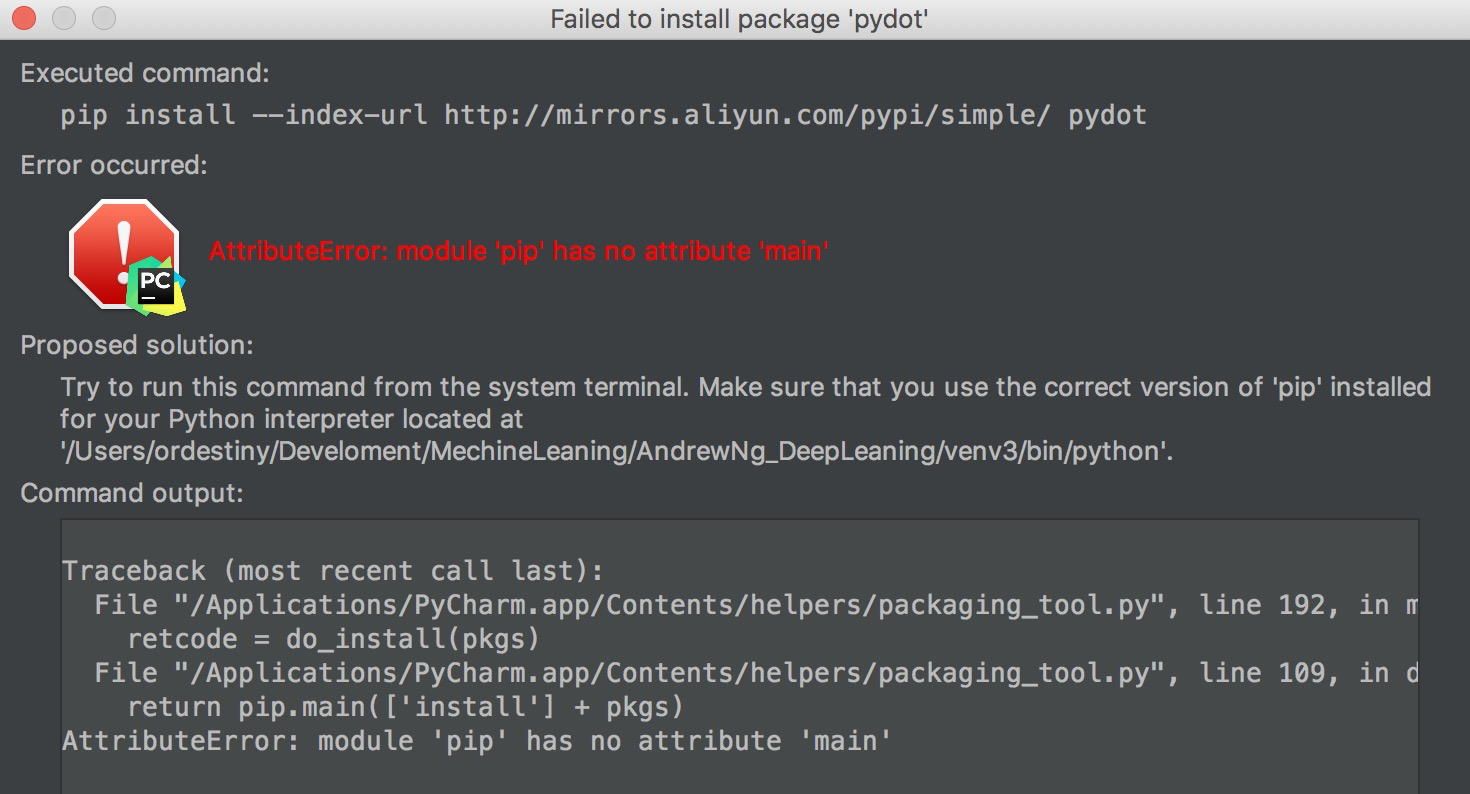
这是由于pip版本的问题,pip 10.0版本的没有main()方法, 因此更改如下代码即可:
可以考虑降个版本:python -m pip install --upgrade pip==9.0.3
解决方法:
找到C:\Program Files\JetBrains\PyCharm 2017.3.2安装目录下的 helpers/packaging_tool.py文件,找到如下代码:
def do_install(pkgs):

    try:

         import pip

    except ImportError:

        error_no_pip()

    return main(['install'] + pkgs)
def do_uninstall(pkgs):

    try:

        import pip

    except ImportError:

        error_no_pip()

    return main(['uninstall', '-y'] + pkgs)
修改为如下,保存即可

def do_install(pkgs):

    try:

        # import pip

        try:

            from pip._internal import main

        except Exception:

            from pip import main

    except ImportError:

        error_no_pip()

    return main(['install'] + pkgs)

def do_uninstall(pkgs):

    try:

        # import pip

        try:

            from pip._internal import main

        except Exception:

            from pip import main

    except ImportError:

        error_no_pip()

    return main(['uninstall', '-y'] + pkgs)
再次运行,就可以安装这些扩展包啦,Yeah!!!
[转]Python爬虫html解析工具beautifulSoup在pycharm中安装及失败的解决办法的更多相关文章
- Python爬虫html解析工具beautifulSoup在pycharm中安装及失败的解决办法
1.安装步骤: 首先,你要先进入pycharm的Project Interpreter界面,进入方法是:setting(ctrl+alt+s) ->Project Interpreter,Pro ...
- python爬虫数据解析之BeautifulSoup
BeautifulSoup是一个可以从HTML或者XML文件中提取数据的python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式. BeautfulSoup是python爬虫三 ...
- 【XPath Helper:chrome爬虫网页解析工具 Chrome插件】XPath Helper:chrome爬虫网页解析工具 Chrome插件下载_教程_安装 - 开发者插件 - Chrome插件网
[XPath Helper:chrome爬虫网页解析工具 Chrome插件]XPath Helper:chrome爬虫网页解析工具 Chrome插件下载_教程_安装 - 开发者插件 - Chrome插 ...
- python爬虫网页解析之lxml模块
08.06自我总结 python爬虫网页解析之lxml模块 一.模块的安装 windows系统下的安装: 方法一:pip3 install lxml 方法二:下载对应系统版本的wheel文件:http ...
- python爬虫网页解析之parsel模块
08.06自我总结 python爬虫网页解析之parsel模块 一.parsel模块安装 官网链接https://pypi.org/project/parsel/1.0.2/ pip install ...
- 【Python】在Pycharm中安装爬虫库requests , BeautifulSoup , lxml 的解决方法
BeautifulSoup在学习Python过程中可能需要用到一些爬虫库 例如:requests BeautifulSoup和lxml库 前面的两个库,用Pychram都可以通过 File--> ...
- web报表工具FineReport使用中遇到的常见报错及解决办法(二)
web报表工具FineReport使用中遇到的常见报错及解决办法(二) 这里写点抛砖引玉,希望大家能把自己整理的问题及解决方法晾出来,Mark一下,利人利己. 出现问题先搜一下文档上有没有,再看看度娘 ...
- Ubuntu“无法解析或打开软件包的列表或是状态文件”的解决办法。_StarSasumi_新浪博客
Ubuntu"无法解析或打开软件包的列表或是状态文件"的解决办法. (2011-04-30 14:56:14) 转载▼ 标签: ubuntu apt 分类: Ubuntu/Linu ...
- Python爬虫学习三------requests+BeautifulSoup爬取简单网页
第一次第一次用MarkDown来写博客,先试试效果吧! 昨天2018俄罗斯世界杯拉开了大幕,作为一个伪球迷,当然也得为世界杯做出一点贡献啦. 于是今天就编写了一个爬虫程序将腾讯新闻下世界杯专题的相关新 ...
随机推荐
- Hbase集群部署
1.安装Hadoop集群 这个之前已经写过 2.安装Zookeeper 这个之前也已经写过 3.下载hbase,放到master机器,解压 4.修改hbase-env.sh,添加Java地址 expo ...
- /etc/vsftpd.conf详解
#################匿名权限控制############### anonymous_enable=YES #是否启用匿名用户no_anon_password=YES #匿名用户logi ...
- java正则表达式校验移动电话、固话、邮编的校验
package com.tmall.epp.web.module.util; import java.util.regex.Pattern; /** * 移动电话.固话.邮编的校验 * @since ...
- jQuery 小案例
用jquery实现 百度换肤的模式; <!DOCTYPE html> <html lang="en"> <head> <meta cha ...
- configparser logging collections 模块
configparser 模块: 这是一个写入的模块就是把你的信息给写入的模块 #这是一个把信息写入example文件内import configparserconfig = configparser ...
- Python学习---文件操作的学习1208
1.1. 对文件操作基本操作: 操作流程: 打开文件,得到文件句柄并赋值给一个变量 通过句柄对文件进行操作 关闭文件 注意:pyton中操作的文件是utf8保存的,打开文件时open函数是通过操作系统 ...
- 乘风破浪:LeetCode真题_003_Longest Substring Without Repeating Characters
乘风破浪:LeetCode真题_003_Longest Substring Without Repeating Characters 一.前言 在算法之中出现最多的就是字符串方面的问题了,关于字符串的 ...
- PHP面试常用算法(推荐)
一.冒泡排序 基本思想: 对需要排序的数组从后往前(逆序)进行多遍的扫描,当发现相邻的两个数值的次序与排序要求的规则不一致时,就将这两个数值进行交换.这样比较小(大)的数值就将逐渐从后面向前面移动. ...
- OC文件操作2
1.对文件本身的操作 NSManager 2.对文件内容的操作 NSHandle 文件句柄 NSFileHandle * fh = [NSFileHandle fileHandleForReading ...
- npm 使用国内镜像的方法
npm全称Node Package Manager,是node.js的模块依赖管理工具.由于npm的源在国外,所以国内用户使用起来各种不方便.我们通过设置使用淘宝的镜像来加快我们的速度. 临时使用 n ...