
昇腾CANN DVPP硬件加速训练数据预处理,友好解决Host CPU预处理瓶
本文分享自华为云社区《昇腾CANN 7.0 黑科技:DVPP硬件加速训练数据预处理,友好解决Host CPU预处理瓶颈》,作者: 昇腾CANN 。
在NPU/GPU上进行模型训练计算,为了充分使用计算资源,一般采用批量数据处理方式,因此一般情况下为提升整体吞吐率,batch值会设置的比较大,常见的batch数为256/512,这样一来,对数据预处理处理速度要求就会比较高。对于AI框架来说,常见的应对方式是采用多个CPU进程并发处理,比如PyTorch框架的torchvision就支持多进程并发,使用多个CPU进程来进行数据预处理,以满足与NPU/GPU的计算流水并行处理。
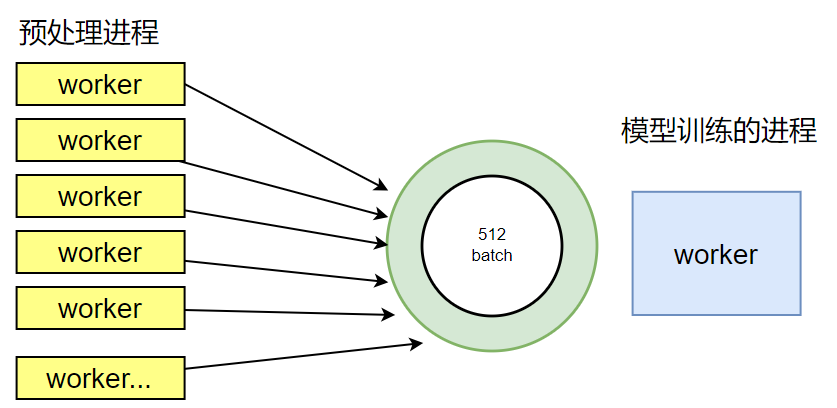
然而,随着NPU算力和性能的倍速提升,host CPU数据预处理过程逐渐成为性能瓶颈。模型端到端训练时间会因为数据预处理的瓶颈而拉长,这种情况下,如何解决性能瓶颈,提升端到端模型执行性能呢?
 # Data loading code

    traindir = os.path.join(args.data, 'train')

normalize = transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])

    train_dataset = datasets.ImageFolder(

        traindir,

        transforms.Compose([

            transforms.RandomResizedCrop(224),

            transforms.RandomHorizontalFlip(),

            transforms.ToTensor(),

            normalize,

        ]))
import torchvision_npu  # 导入torchvision_npu包

    # Data loading code

    traindir = os.path.join(args.data, 'train')

    normalize = transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])

    torchvision_npu.set_image_backend('npu')  # 设置图像处理后端为npu

    train_dataset = datasets.ImageFolder(

        traindir,

        transforms.Compose([

            transforms.RandomResizedCrop(224),

            transforms.RandomHorizontalFlip(),

            transforms.ToTensor(),

            normalize,

        ]))
if img.device.type == 'npu': _assert_image_npu(img) return F_npu.resize(img, size=size, interpolation=interpolation.value)
return torch.ops.torchvision.npu_resize(img, size=sizes, mode=mode)
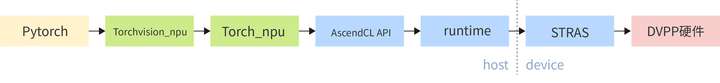
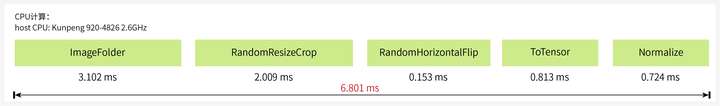
下面来看下替换之后的性能如何。以ImageNet中最常见的分辨率375*500的jpeg图片为例,CPU上执行预处理操作需要6.801ms:
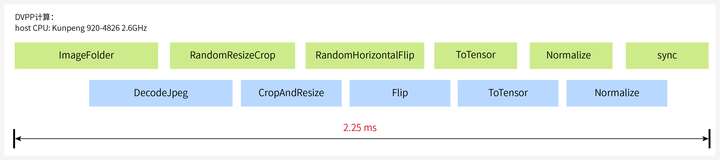
使用DVPP不但能加速数据预处理,还能异步执行host下发任务和device任务,整个流程只需要2.25ms,单张图片处理节省了60%+的时间。
在ResNet50训练过程中,512batch数据处理只需要1.152 s,预处理多进程处理场景下性能优势更加明显。
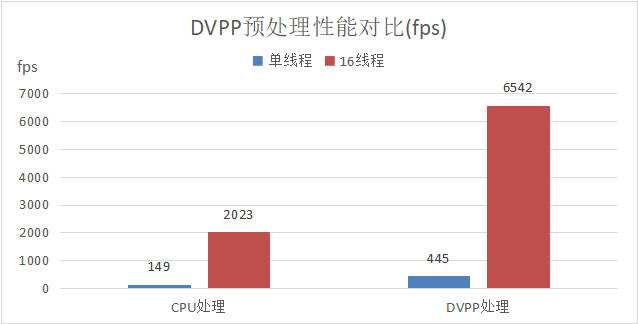
基于Atlas 800T A2 训练服务器,ResNet50使用DVPP加速数据预处理,单P只需要6个预处理进程即可把NPU的算力跑满;而使用CPU预处理,则需要12个预处理进程才能达到相应的效果,大大减少了对host CPU的性能依赖。
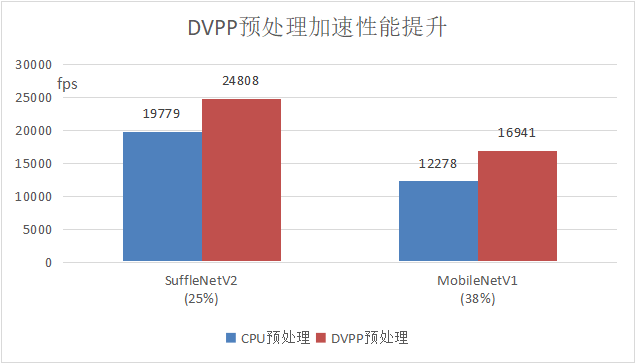
典型网络场景,基于Atlas 800T A2 训练服务器,在CPU预处理成为性能瓶颈的情况下,使用DVPP预处理加速即可获得整网训练速度显著提升,其中ShuffleNetV2整网性能提升25%,MobileNetV1提升38%。
昇腾CANN内置的预处理算子是比较丰富的,后续在继续丰富torchvision预处理算子库的同时,也会进一步提升预处理算子的下发和执行流程,让流水处理的更好,减少数据处理的时间,持续提升昇腾CANN的产品竞争力,满足更广泛的业务场景诉求。
昇腾CANN DVPP硬件加速训练数据预处理,友好解决Host CPU预处理瓶的更多相关文章
- 『TensorFlow』SSD源码学习_其五:TFR数据读取&数据预处理
Fork版本项目地址:SSD 一.TFR数据读取 创建slim.dataset.Dataset对象 在train_ssd_network.py获取数据操作如下,首先需要slim.dataset.Dat ...
- CANN训练:模型推理时数据预处理方法及归一化参数计算
摘要:在做基于Ascend CL模型推理时,通常使用的有OpenCV.AIPP.DVPP这三种方式,或者是它们的混合方式,本文比较了这三种方式的特点,并以Resnet50的pytorch模型为例,结合 ...
- 图形性能(widgets的渲染性能太低,所以推出了QML,走硬件加速)和网络性能(对UPD性能有实测数据支持)
作者:JasonWong链接:http://www.zhihu.com/question/37444226/answer/72007923来源:知乎著作权归作者所有,转载请联系作者获得授权. ---- ...
- 开发实践丨昇腾CANN的推理应用开发体验
摘要:这是关于一次 Ascend 在线实验的记录,主要内容是通过网络模型加载.推理.结果输出的部署全流程展示,从而快速熟悉并掌握 ACL(Ascend Computing Language)基本开发流 ...
- 一键抠除路人甲,昇腾CANN带你识破神秘的“AI消除术”
摘要:都说人工智能改变了生活,你感觉到了么?AI的魔力就在你抠去路人甲的一瞬间来到了你身边.今天就跟大家聊聊--神秘的"AI消除术". 引语 旅途归来,重温美好却被秀丽河山前的路人 ...
- 英特尔® 至强® 平台集成 AI 加速构建数据中心智慧网络
英特尔 至强 平台集成 AI 加速构建数据中心智慧网络 SNA 通过 AI 方法来实时感知网络状态,基于网络数据分析来实现自动化部署和风险预测,从而让企业网络能更智能.更高效地为最终用户业务提供支撑. ...
- 昇腾CANN论文上榜CVPR,全景图像生成算法交互性再增强!
摘要:近日,CVPR 2022放榜,基于CANN的AI论文<Interactive Image Synthesis with Panoptic Layout Generation>强势上榜 ...
- ffmpeg实现dxva2硬件加速
这几天在做dxva2硬件加速,找不到什么资料,翻译了一下微软的两篇相关文档.这是第二篇,记录用ffmpeg实现dxva2. 第一篇翻译的Direct3D device manager,链接:http: ...
- Qt 框架的图形性能高(OpenGL上的系统效率高),网络性能低,开发效率高,Quick是可以走硬件加速——Qt中分为好几套图形系统,差不多代表了2D描画的发展史。最经典的软描画系统
-----图形性能部分-----Qt的widgets部分,运行时的图像渲染性能是一般的,因为大部分的界面内容都是Qt自绘,没有走硬件加速,也就是说很多图形内容都是CPU算出来的.但是widgets底层 ...
- 英特尔® 硬件加速执行管理器安装指南 — Microsoft Windows*
介绍 本文将指导您安装英特尔® 硬件加速执行管理器(英特尔® HAXM),这是一款可以使用英特尔® 虚拟化技术(VT)加快 Android* 开发速度的硬件辅助虚拟化引擎(管理程序). 前提条件 英特 ...
随机推荐
- ABC318 A-G 题解
A 枚举 \(1\sim n\) 的每个数,判断是否有 \(i-M\equiv 0\pmod P\) 即可. 赛时代码 B 暴力覆盖即可,注意 \(x,y\) 均是左开右闭. 赛时代码 C 贪心的想, ...
- 强化学习的一周「GitHub 热点速览」
当强化学习遇上游戏,会擦出什么样的火花呢?PokemonRedExperiments 将经典的 Pokeman 游戏接上了强化学习,效果非同凡响,不然能一周获得 4.5k star 么?看看效果图就知 ...
- Net 高级调试之二:CLR和Windows加载器及应用程序域介绍
一.简介 今天是 Net 高级调试的第二篇文章,第一篇文章记录了自己学习 Net 高级调试的第一步,认识一些调试工具,有了工具的倚仗,我们开始仗剑走天涯了,开始Net 高级调试正式的征程了.我先说一下 ...
- 拒绝恶意IP登录服务器
拒绝恶意IP登录服务器,并加入防火墙黑名单 #!/bin/bash #2020-03-20 16:39 #auto refuse ip dlu #By Precious ############### ...
- 线段树(nb)
今天刚学习了线段树,赶紧趁热打了两遍模版 下面都是线段树的基本操作,这个板子是维护的区间中的最大值,当然修改change和build包括线段树中的data可以维护区间上的不同信息. 首先介绍一下线段树 ...
- JVM-Java虚拟机是怎么实现synchronized的?
1. JVM的锁优化 今天我介绍了 Java 虚拟机中 synchronized 关键字的实现,按照代价由高至低可分为重量级锁.轻量级锁和偏向锁三种. 重量级锁会阻塞.唤醒请求加锁的线程.它针对的是多 ...
- 通过mybatis-plus的自定义拦截器实现控制 mybatis-plus的全局逻辑删除字段的控制 (修改其最终执行的sql中的where条件)
需求:过滤部分请求不实现mybatis-plus的逻辑删除 看到网上关于mybatis-plus的自定义拦截器的文章有的少 想了想自己写了一篇 欢迎参考 指正 通过springboot的拦截器 在请求 ...
- 【re】[NISACTF 2022]string --linux下的随机数
附件下载,查壳 发现是ELF程序,64位,ida打开分析 flag函数点进去 前面一堆代码其实都不重要,直接看主要代码: puts("The length of flag is 13&qu ...
- VSCODE中无法搜索插件的解决办法
当前我的使用环境是虚拟机, 如果无法搜索插件但是网络连接是正确的极有可能是代理设置的问题. 解决办法如下: ctrl+, 打开设置 这里填写正确的代理设置.
- 如何使用C#编写低代码应用插件
本文由葡萄城技术团队发布.转载请注明出处:葡萄城官网,葡萄城为开发者提供专业的开发工具.解决方案和服务,赋能开发者. 前言 作为当今快速发展的技术之一,低代码平台为开发人员提供了更高效.更简便的工具和 ...