
【Hadoop 分布式部署 三:基于Hadoop 2.x 伪分布式部署进行修改配置文件】
1.规划好哪些服务运行在那个服务器上

需要配置的配置文件
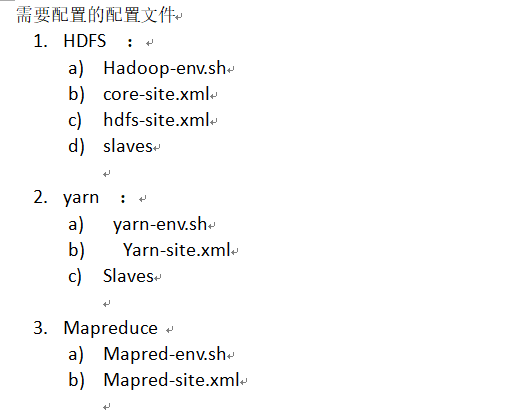
2. 修改配置文件,设置服务运行机器节点
首先在 hadoop-senior 的这台主机上 进行 解压 hadoop2.5 按照伪分布式的配置文件来进行配置
使用命令 :tar -zxvf hadoop-2.5.0.tar.gz -C /opt/app/ (解压 hadoop 2.5)
然后进入 cd /opt/app/hadoop-2.5.0/etc
将里面一开始的配置文件重命令 mv hadoop backup-hadoop
然后将一开始伪分布式中的配置文件复制过来 使用命令 cp -r /opt/moudles/hadoop-2.5.0/etc/hadoop ./
(如果在Windows下 想使用方便,可以在C:\Windows\System32\drivers\etc目录下 修改hosts文件 配置 虚拟机的主机IP)

开始配置
使用notepad 进行配置hadoop 的配置文件
hadoop.env export JAVA_HOME=/opt/modules/jdk1.7.0_67 (默认已经配置好了,不用更改)
core-site.xml 文件中的内容配置
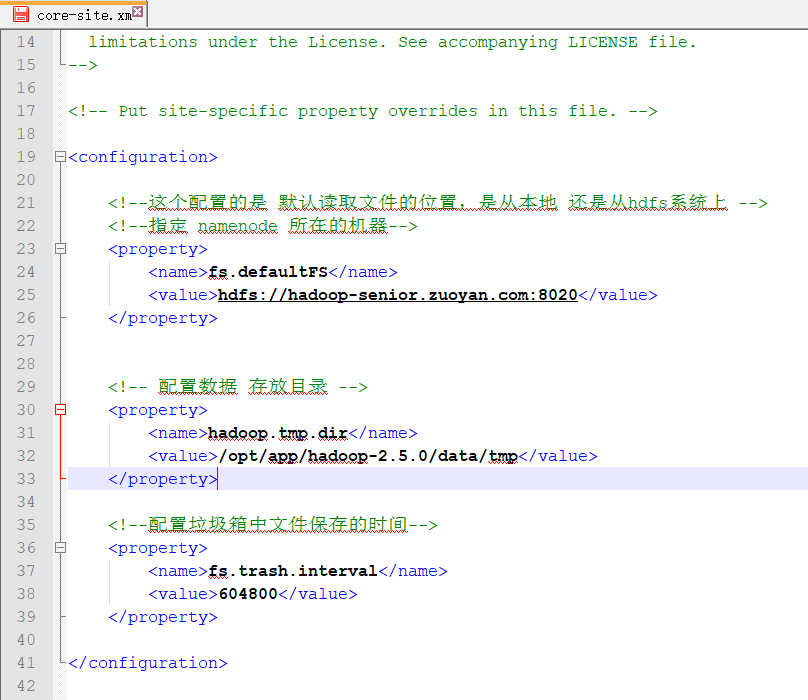
<configuration>

	<!--这个配置的是 默认读取文件的位置,是从本地 还是从hdfs系统上 -->

	<!--指定 namenode 所在的机器-->

	<property>

        <name>fs.defaultFS</name>

        <value>hdfs://hadoop-senior.zuoyan.com:8020</value>

    </property>

	<!-- 配置数据 存放目录 -->

	<property>

        <name>hadoop.tmp.dir</name>

        <value>/opt/app/hadoop-2.5.0/data/tmp</value>

    </property>

	<!--配置垃圾箱中文件保存的时间-->

	<property>

        <name>fs.trash.interval</name>

        <value>604800</value>

    </property>

</configuration>
因为没有数据存放的目录 所以需要配置一下 hadoop.tmp.dir 的目录
命令 : mkdir -p /opt/app/hadoop-2.5.0/data/tmp
配置hdfs
首先配置hdfs-site.xml 文件
因为是分布式 所以不需要配置副本数 去掉 dfs.replication
配置SecondaryNameNode 所在的节点 dfs.namenode.secondary.http-address hadoop-senior03.zuoyan.com
<configuration>

    <!--配置secondary namenode 所在的主机-->

    <property>

            <name>dfs.namenode.secondary.http-address</name>

            <value>hadoop-senior03.zuoyan.com:</value>

        </property>

</configuration>
配置slaves 也就是配制 DataNode NodeManager
配置的内容为
hadoop-senior.zuoyan.com

hadoop-senior02.zuoyan.com

hadoop-senior03.zuoyan.com
配置yarn
首先配置 yarn.env 配置yarn的环境变量 (我这里已经配置好了,就不用更改了)

配置yarn-site.xml 这个文件
这个配置文件只需要 将 resourcesmanager 所在的主机节点更改成第二台主机就可以了
剩下的配置文件不用修改,配置文件内容如下
<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

	<!--配置resourcemanager 所在的主机名 -->

	<property>

        <name>yarn.resourcemanager.hostname</name>

        <value>hadoop-senior02.zuoyan.com</value>

    </property>

	<!--启用历史服务器的日志聚集功能-->

	<property>

        <name>yarn.log-aggregation-enable</name>

        <value>true</value>

    </property>

	<!--设置日志在文件系统上的存放时间-->

	<property>

        <name>yarn.log-aggregation.retain-seconds</name>

        <value>640800</value>

    </property>

	<!--配置NodeManager Resource-->

	<property>

        <name>yarn.nodemanager.resource.memory-mb</name>

        <value>4096</value>

    </property>

	<property>

        <name>yarn.nodemanager.resource.cpu-vcores</name>

        <value>4</value>

    </property>

</configuration>
配置 mapred-site.xml
配置 JobHistoryServer 的配置文件 资源设计的时候 就把他放在了第一台主机上,所以 保持默认配置文件即可,修改一下主机名就行
配置文件的内容如下
<configuration>

	<property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

	<!--配置历史记录服务器所在地址-->

	<property>

	  <name>mapreduce.jobhistory.address</name>

	  <value>hadoop-senior.zuoyan.com:10020</value>

	</property>

	<property>

	  <name>mapreduce.jobhistory.webapp.address</name>

	  <value>hadoop-senior.zuoyan.com:19888</value>

	</property>

</configuration>
到此,配置文件就配置完成了!下一步就是分发到各个机器上去
(还有一个小点就是 删除 在 /opt/app/hadoop-2.5.0/share 下的 doc文件夹,这个文件是文档,我们一般,不用,而且还占用磁盘空间 大概占用的磁盘空间是1.5G )
好了,这篇随笔就到这里了,下一篇继续!
【Hadoop 分布式部署 三:基于Hadoop 2.x 伪分布式部署进行修改配置文件】的更多相关文章
- 网站用户行为分析——Hadoop的安装与配置(单机和伪分布式)
Hadoop安装方式 Hadoop的安装方式有三种,分别是单机模式,伪分布式模式,伪分布式模式,分布式模式. 单机模式:Hadoop默认模式为非分布式模式(本地模式),无需进行其他配置即可运行.非分布 ...
- Hadoop整理五(基于Hadoop的数据仓库Hive)
数据仓库,是为企业所有级别的决策制定过程,提供所有类型数据支持的战略集合.它是单个数据存储,出于分析性报告和决策支持目的而创建. 为需要业务智能的企业,提供指导业务流程改进.监视时间.成本.质量以及控 ...
- 【连载】redis库存操作,分布式锁的四种实现方式[三]--基于Redis watch机制实现分布式锁
一.redis的事务介绍 1. Redis保证一个事务中的所有命令要么都执行,要么都不执行.如果在发送EXEC命令前客户端断线了,则Redis会清空事务队列,事务中的所有命令都不会执行.而一旦客户端发 ...
- hadoop搭建伪分布式集群(centos7+hadoop-3.1.0/2.7.7)
目录: Hadoop三种安装模式 搭建伪分布式集群准备条件 第一部分 安装前部署 1.查看虚拟机版本2.查看IP地址3.修改主机名为hadoop4.修改 /etc/hosts5.关闭防火墙6.关闭SE ...
- hadoop 2.7.3伪分布式环境运行官方wordcount
hadoop 2.7.3伪分布式模式运行wordcount 基本环境: 系统:win7 虚机环境:virtualBox 虚机:centos 7 hadoop版本:2.7.3 本次以伪分布式模式来运行w ...
- hadoop伪分布式
一.安装jdk 1.下载解压 2.配置环境变量 配置成功: 二.ssh免密码登录 https://www.cnblogs.com/suwy/p/9326087.html 三.hadoop伪分布式配置 ...
- 云计算课程实验之安装Hadoop及配置伪分布式模式的Hadoop
一.实验目的 1. 掌握Linux虚拟机的安装方法. 2. 掌握Hadoop的伪分布式安装方法. 二.实验内容 (一)Linux基本操作命令 Linux常用基本命令包括: ls,cd,mkdir,rm ...
- java大数据最全课程学习笔记(1)--Hadoop简介和安装及伪分布式
Hadoop简介和安装及伪分布式 大数据概念 大数据概论 大数据(Big Data): 指无法在一定时间范围内用常规软件工具进行捕捉,管理和处理的数据集合,是需要新处理模式才能具有更强的决策力,洞察发 ...
- Hadoop学习笔记(一):ubuntu虚拟机下的hadoop伪分布式集群搭建
hadoop百度百科:https://baike.baidu.com/item/Hadoop/3526507?fr=aladdin hadoop官网:http://hadoop.apache.org/ ...
- Hadoop 2.7 伪分布式环境搭建
1.安装环境 ①.一台Linux CentOS6.7 系统 hostname ipaddress subnet mask ...
随机推荐
- jQuery属性--html([val|fn])、text([val|fn])和val([val|fn|arr])
html([val|fn]) 概述 取得第一个匹配元素的html内容,这个函数不能用于XML文档.但可以用于XHTML文档. 在一个 HTML 文档中, 我们可以使用 .html() 方法来获取任意一 ...
- 20155228 2016-2017-2 《Java程序设计》第1周学习总结
20155228 2016-2017-2 <Java程序设计>第1周学习总结 教材学习内容总结 这部分内容是以教材为基础,根据个人的理解来描述的,有的地方的理解和表述可能不规范甚至不正确, ...
- redis和mongodb的比较
>>RedisRedis的优点:支持多种数据结构,如 string(字符串). list(双向链表).dict(hash表).set(集合).zset(排序set).hyperloglog ...
- ajax评论
评论有好几种格式:有评论树.评论楼等的格式 发表评论注意事项: 1. 展示评论 1. 评论楼(Django模板语言渲染) 1. 从后端查询出所有的评论 2. 如果有父评论就展示父评论 2. 评论树 通 ...
- tensorflow学习5----变量管理
---恢复内容开始--- 前面,读书笔记用加入正则化损失模型效果带来的提升要相对显著. 变量管理: 目的:当神经网络的结构更加复杂,参数更多的时候,就需要一个更好的方式来管理神经网络中的参数. 解决方 ...
- 基于jquery、bootstrap的数据验证插件bootstrapValidator使用
实时验证用户名是否存在,密码不能和用户名相同,两次密码需要相同,提交之后需要验证返回值: <form id="defaultForm" role="form&quo ...
- SQL8数据库定期自动备份
我们知道,利用SQL Server 2008数据库可以实现数据库的定期自动备份.方法是用SQL SERVER 2008自带的维护计划创建一个计划对数据库进行备份, 下面我们将SQL SERVER 20 ...
- PYQT5 + PYCHARM
PYQT5 C:\Users\xxx\AppData\Local\Programs\Python\Python37\Lib\site-packages\pyqt5_tools\designer.exe ...
- Prometheus监控学习笔记之Prometheus不完全避坑指南
0x00 概述 Prometheus 是一个开源监控系统,它本身已经成为了云原生中指标监控的事实标准,几乎所有 k8s 的核心组件以及其它云原生系统都以 Prometheus 的指标格式输出自己的运行 ...
- 远程图片转化为base64
远程图片转化为base64 <?php /* * * 第一种方法 * 远程图片转化为base64,只支持http(推荐使用) * */ public static function imgUrl ...