
SqlServer索引碎片
1.产生碎片的操作
通过sys.dm_index_physical_stats来查看,索引上的页不在具有连续性时就会产生碎片,碎片是索引上页拆分的物理结果。
(1).插入操作:
INSERT操作在聚集索引和非聚集索引上都可以引起碎片
使用业务键或者GUID等类型 做聚集索引,很容易产生碎片
代码如下:
 IF OBJECT_ID('dbo.Table_GUID') IS NOT NULL

DROP TABLE dbo.Table_GUID;

CREATE TABLE Table_GUID

(

RowID UNIQUEIDENTIFIER CONSTRAINT DF_GUIDValue DEFAULT NEWID(),--使用GUID作为默认值

Name sysname,

Value VARCHAR(2000)

);

--插入数据,注意此时还没有创建聚集索引

INSERT INTO dbo.Table_GUID(  Name, Value )

		SELECT name,REPLICATE('X',2000)

		 FROM sys.columns

		 SELECT * FROM dbo.Table_GUID

--在列上创建聚集索引

CREATE CLUSTERED INDEX CLUS_UsingUniqueidentifer ON dbo.Table_GUID(RowID);

--查看平均碎片

SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.Table_GUID'),NULL,NULL,'DETAILED')

平均碎片为0,插入后才建索引。
插入数据:
 --插入新数据

 INSERT INTO dbo.Table_GUID

         (  Name, Value )

SELECT name, REPLICATE('X',2000) FROM sys.objects
查看索引碎片:
--查看平均碎片

SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.Table_GUID'),NULL,NULL,'DETAILED')

非聚集索引:
CREATE NONCLUSTERED INDEX IX_Name ON dbo.Table_GUID(Name) INCLUDE(Value)
执行以上两次操作。
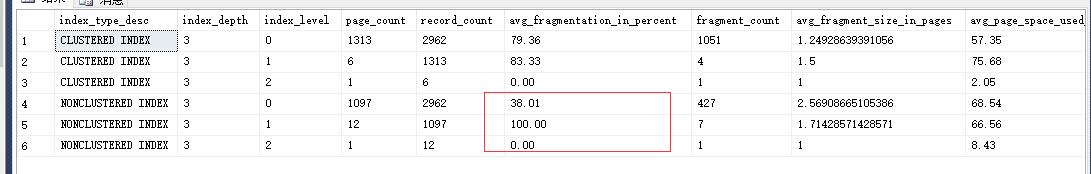
由此可见:当INSERT操作发生时,产生碎片再所难免,唯一要做的是尽可能降低碎片的产生速率。
(2):更新操作
 --跟新操作

  IF OBJECT_ID('dbo.Update_Fr') IS NOT NULL

DROP TABLE dbo.Update_Fr;

CREATE TABLE Update_Fr

(

RowID INT IDENTITY(1,1),--使用GUID作为默认值

Name sysname,

Value VARCHAR(2000)

);

INSERT INTO dbo.Update_Fr

        (  Name, Value )

		SELECT name,REPLICATE('X',1000)

 FROM sys.columns

 CREATE CLUSTERED INDEX CLUS_UsingUniqueidentifier ON dbo.Update_Fr(RowID);

 --检查一下空间

SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.Update_Fr'),NULL,NULL,'DETAILED')

--更新数据让长度变长

 UPDATE dbo.Update_Fr SET Value=REPLICATE('X',2000)

 WHERE RowID % 5=1

键值的改变导致碎片的产生:
 --创建一个非聚集索引

 CREATE NONCLUSTERED INDEX IX_Name ON dbo.Update_Fr(Name) INCLUDE (Value);

 --通过REVERST函数把名称反转监控跟新前后的碎片情况

SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.Update_Fr'),NULL,NULL,'DETAILED')
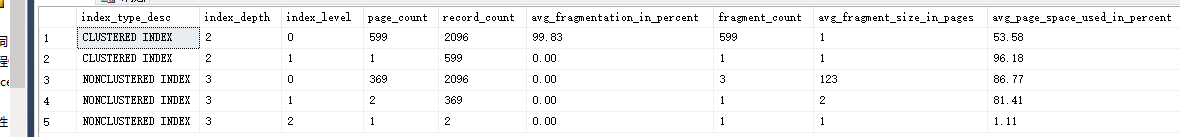
--通过REVERST函数把名称反转监控跟新前后的碎片情况
UPDATE dbo.Update_Fr

 SET Name=REVERSE(Name)

 WHERE RowID%9=1

 SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.Update_Fr'),NULL,NULL,'DETAILED')
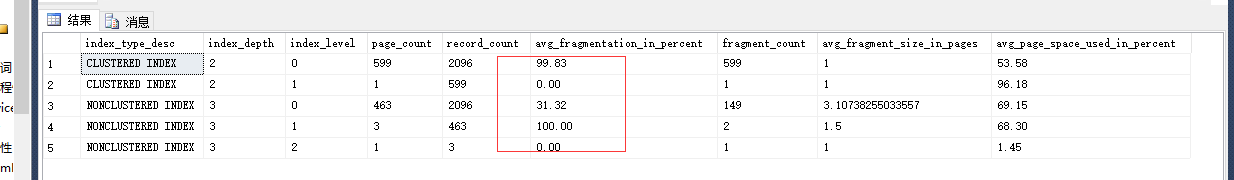
(3).收缩操作:
 IF DB_ID(N'Fragmentation') IS NOT NULL

 DROP DATABASE Fragmentation

 CREATE DATABASE Fragmentation

  USE Fragmentation

  IF OBJECT_ID('dbo.FirstTable') IS NOT NULL

DROP TABLE dbo.FirstTable;

CREATE TABLE dbo.FirstTable

(

RowID INT IDENTITY(1,1),

Name sysname,

Value VARCHAR(2000),

CONSTRAINT PK_FirstTable PRIMARY KEY CLUSTERED(RowID)

);

INSERT INTO dbo.FirstTable

        (  Name, Value )

SELECT name,REPLICATE('X',2000) FROM sys.columns

 IF OBJECT_ID('dbo.SecondTable') IS NOT NULL

DROP TABLE dbo.SecondTable;

CREATE TABLE dbo.SecondTable

(

RowID INT IDENTITY(1,1),

Name sysname,

Value VARCHAR(2000),

CONSTRAINT PK_SecondTable PRIMARY KEY CLUSTERED(RowID)

);

INSERT INTO dbo.SecondTable

        (  Name, Value )

SELECT name,REPLICATE('X',2000) FROM sys.columns

INSERT INTO dbo.FirstTable

        (  Name, Value )

SELECT name,REPLICATE('X',2000) FROM sys.columns

INSERT INTO dbo.SecondTable

        (  Name, Value )

SELECT name,REPLICATE('X',2000) FROM sys.columns

INSERT INTO dbo.FirstTable

        (  Name, Value )

SELECT name,REPLICATE('X',2000) FROM sys.columns

 SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.FirstTable'),NULL,NULL,'DETAILED')

 IF OBJECT_ID('dbo.SecondTable') IS NOT NULL

DROP TABLE dbo.SecondTable;

 SELECT index_type_desc,

index_depth,

index_level,

page_count,

record_count,

CAST(avg_fragmentation_in_percent AS DECIMAL(6,2)) AS avg_fragmentation_in_percent,

fragment_count,

avg_fragment_size_in_pages,

CAST(avg_page_space_used_in_percent AS DECIMAL(6,2)) AS avg_page_space_used_in_percent

 FROM sys.dm_db_index_physical_stats(DB_ID(),OBJECT_ID(N'dbo.FirstTable'),NULL,NULL,'DETAILED')
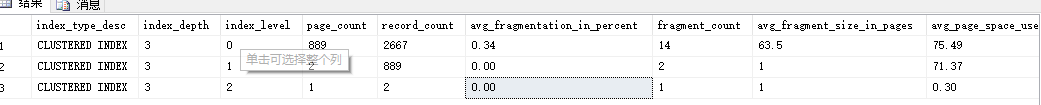
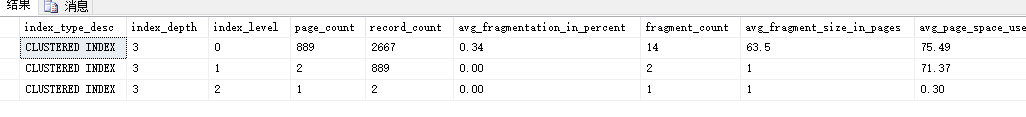
删除前后的索引碎片一样。
由于SqlServer不会自动回收,调用DBCC SHRINKDATABASE来收缩数据库,再次查看碎片情况。
DBCC SHRINKDATABASE(Fragmentation)
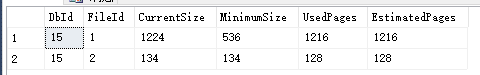
再次查看碎片:

所以自动收缩数据不建议使用。
SqlServer索引碎片的更多相关文章
- mssql sqlserver 索引专题
摘要: 下文将详细讲述sql server 索引的相关知识,如下所示: 实验环境: sql server 2008 R2 sqlserver索引简介: mssql sqlsever 索引分类简介 ms ...
- SQLServer中重建聚集索引之后会影响到非聚集索引的索引碎片吗
本文出处:http://www.cnblogs.com/wy123/p/7650215.html (保留出处并非什么原创作品权利,本人拙作还远远达不到,仅仅是为了链接到原文,因为后续对可能存在的一些错 ...
- SqlServer 如何知道是否发生了索引碎片
--如何知道是否发生了索引碎片 SELECT object_name(dt.object_id) Tablename,si.name IndexName,dt.avg_fragmentation_in ...
- SQLServer 数据库索引碎片
--改成当前库 use DB_Name --创建变量 指定要查看的表 declare @table_id int set @table_id=object_id('TableName') --执行 d ...
- sqlserver索引小结
1.1 什么是索引? SQL索引有两种,聚集索引和非聚集索引,索引主要目的是提高了SQL Server系统的性能,加快数据的查询速度与减少系统的响应时间 下面举两个简单的例子: 图书馆的例子:一个图书 ...
- SQL Server2005索引碎片分析和解决方法
SQL Server2005索引碎片分析和解决方法 本文作者(郑贤娴),请您在阅读本文时尊重作者版权. 摘要: SQL Server,为了反应数据的更新,需要维护表上的索引,因而这些索引会形成碎片.根 ...
- 转:sql server索引碎片和解决方法
毫无疑问,给表添加索引是有好处的,你要做的大部分工作就是维护索引,在数据更改期间索引可能产生碎片,所以一些维护是必要的.碎片可能是你查询产生性能问题的来源. 那么到底什么是索引碎片呢?索引碎片实际上有 ...
- 提升SQL Server速度整理索引碎片
转载:http://wenku.baidu.com/view/f64c8a707fd5360cba1adbea.html SQL Server2005索引碎片分析和解决方法 毫无疑问,给表添加索引 ...
- sqlserver2008 如何定时清理索引碎片
sqlserver2008 如何定时清理索引碎片 查询索引引起的表垃圾碎片sql脚本: SELECT object_name(a.object_id) [TableName] ,a.index_id ...
随机推荐
- 设计模式---对象创建模式之工厂方法模式(Factory Method)
前提:“对象创建”模式 通过“对象创建”模式绕开new,来避免对象创建(new)过程中所导致的紧耦合(依赖具体类),从而支持对象创建的稳定.它是接口抽象之后的第一步工作. 典型模式(表现最为突出) 工 ...
- Linux记录-分区(df/fdisk/mount/umount/fuser)
1.查看磁盘挂载(df -TH) 2.卸载umount /dev/vdb1 3.查杀用户进程(fuser -m -v -i -k /dev/vdb1) 4.再次卸载umount /dev/vdb1,并 ...
- 详细解读Jquery各Ajax函数:$.get(),$.post(),$.ajax(),$.getJSON()【转】【补】
一,$.get(url,[data],[callback]) 说明:url为请求地址,data为请求数据的列表(是可选的,也可以将要传的参数写在url里面),callback为请求成功后的回调函数,该 ...
- Java Calendar详解
网上看到的一篇,码一下.侵删 一:字段和方法的信息 YEAR 字段: public static final int YEAR ; 指示年的 get 和 set 的字段数字.这是一个特定于日历的值: ...
- 第二节:从程序集的角度分析MemoryCache,并完成基本封装
一. 轻车熟路 有了上一个章节对 System.Web.Caching.Cache 的探究,这里我们按照同样的思路对 MemoryCache 进行探究,相信必定会得心应手. 1. 程序集准备 a. 需 ...
- python执行centos命令
import os improt sys import re import commands a = commands.getoutput("ls -al /") print a
- .NET面试题系列(十二)Dictionary原理
序言 Dictionary Dictionary的开发人员都了解,和List相比,字典添加会慢,但是查找会比较快. Dictionary的本质 --- 两个数组.这是典型的用空间换取时间的做法. 先来 ...
- JavaScript之对原生JavaScript对象及其原型扩展初探
Object对象: //扩展:对JavaScript原生对象的扩展 //原理:原型对象 Object.prototype.keys = function(){ var keys = []; for(v ...
- 第一次安卓android studio安装,常见问题。
出处:纸月 托了很久终于开始学习安卓了,之前看课本教程<第一行代码>用的是eclipse,但后来它不支持了就决定用android studio,第一次安装就出现了一些小的问题 第一个是关于 ...
- python - 计算器 程序练习
v1.0 计算器(数据内不含括号方式:) import re def jisuan(a,b,c): sun_count = 0 if c =="+": sun_count = st ...