
python 全栈开发,Day4(正式)
一、列表
列表是python中的基础数据类型之一,它是以[]括起来,每个元素以逗号隔开,而且他里面可以存放各种数据类型比如:
li = [‘alex’,123,Ture,(1,2,3,’wusir’),[1,2,3,’小明’,],{‘name’:’alex’}]
列表相比于字符串,不仅可以储存不同的数据类型,而且可以储存大量数据。列表是有序的,有索引值,可切片,方便取值。
索引,切片,步长
li = ['xiao',123,True,(1,2,3,'wusir'),[1,2,3,'小明',],{'name':'xiao'}]

print(li[0])

print(li[2])

print(li[1:4])

print(li[:5:2])

#倒着取,后2个

print(li[-1:-3:-1])
执行输出:
xiao
True
[123, True, (1, 2, 3, 'wusir')]
['xiao', True, [1, 2, 3, '小明']]
[{'name': 'xiao'}, [1, 2, 3, '小明']]
下面介绍列表的增、删、改、查
增
append() 追加,在最后一个位置添加元素
li = [1,'a','b',2,3,'a','laonaihai']

li.append('xiao')

print(li)
执行输出:
[1, 'a', 'b', 2, 3, 'a', 'laonaihai', 'xiao']
insert() 按照索引添加
将元素插入到指定的索引值位置,后面的元素索引值会自动加1
li = [1,'a','b',2,3,'a','laonaihai']

li.insert(2,'zhang')

print(li)
仔细输出:
[1, 'a', 'zhang', 'b', 2, 3, 'a', 'laonaihai']
extend() 迭代着添加
在最后的位置,迭代每一个元素,依次添加。
li = [1,'a','b',2,3,'a','laonaihai']

li.extend('ABC')

print(li)
执行输出:
[1, 'a', 'b', 2, 3, 'a', 'laonaihai', 'A', 'B', 'C']
使用输入框方式添加元素
name_list = ['张无忌','张敏','胡歌','江疏影']

while True:

    name = input('请输入新员工姓名:Q/q ').strip()

    if name.upper() == 'Q':break

    else:

        name_list.append(name)

        print('已成功添加新员工%s' % name)

print(name_list)
执行输出:

删
pop() 按照索引删除
默认删除最后一个
li = [1,'a','b',2,3,'a','laonaihai']

li.pop()

print(li)
执行输出:
[1, 'a', 'b', 2, 3, 'a']
删除索引值为1的元素
li = [1,'a','b',2,3,'a','laonaihai']

li.pop(1)

print(li)
执行输出:
[1, 'b', 2, 3, 'a', 'laonaihai']
pop() 是增删改查,所有方法里面,唯一有返回值的方法。
返回删除的元素。
pop()只能删除一个元素
remove() 按照元素删除,只能删除一个
li = [1,'a','b','a',2,3,'a','laonaihai']

li.remove('a')

print(li)
执行输出:
[1, 'b', 'a', 2, 3, 'a', 'laonaihai']
clear() 清空列表的所有元素
li = [1,'a','b','a',2,3,'a','laonaihai']

li.clear()

print(li)
执行输出:
[]
del 删除列表
li = [1,'a','b','a',2,3,'a','laonaihai']

del li
切片删除
li = [1,'a','b','a',2,3,'a','laonaihai']

del li[:3]

print(li)
执行输出:
['a', 2, 3, 'a', 'laonaihai']
跳着删除
li = [1,'a','b','a',2,3,'a','laonaihai']

del li[:3:2]

print(li)
执行输出:
['a', 'a', 2, 3, 'a', 'laonaihai']
改
使用赋值修改
按照索引改,是一个整体修改
a改成A
li = [1,'a','b','a',2,3,'a','laonaihai']

li[1] = 'A'

print(li)
执行输出:
[1, 'A', 'b', 'a', 2, 3, 'a', 'laonaihai']
切片修改
不是整体,而是迭代添加。
li = [1,'a','b','a',2,3,'a','laonaihai']

li[:3] = 'aq'

print(li)
执行输出:
['a', 'q', 'a', 2, 3, 'a', 'laonaihai']
切片,添加一个列表
li = [1,'a','b','a',2,3,'a','laonaihai']

li[:3] = [11,22,33,44]

print(li)
执行输出:
[11, 22, 33, 44, 'a', 2, 3, 'a', 'laonaihai']
切片修改的执行过程是,先删除切片部分,再迭代添加的对象,依次添加元素。
比如上面的11,22,33
查
索引,切片,步长,查看方法,和字符串操作是一样的,这里不再举例。
for 循环
li = [1,'a','b','a',2,3,'a','laonaihai']

for i in li:

    print(i)
执行输出:
1
a
b
a
2
3
a
laonaihai
其他操作方法:
sort() 从小到大,正向排序
li = [1,2,7,8,5,6,3,4]

li.sort()

print(li)
执行输出:
[1, 2, 3, 4, 5, 6, 7, 8]
从大到小,反向排序
li = [1,2,7,8,5,6,3,4]

li.sort(reverse=True)

print(li)
执行输出:
[8, 7, 6, 5, 4, 3, 2, 1]
reverse() 翻转
翻转,就是将右边的元素和左边的元素进行对换。
li = [1,2,7,8,5,6,3,4]

li.reverse()

print(li)
执行输出:
[4, 3, 6, 5, 8, 7, 2, 1]
任何排序都不如sort和reverse 快。
如果没有明确要求指定排序方法,优先使用sort和reverse
len() 查看数据长度
li = [1,2,7,8,5,6,3,4]

print(len(li))
执行输出:
8
count() 统计元素出现次数
li = [1,2,7,8,5,6,3,4]

print(li.count(7))
执行输出:
1
index() 通过元素找索引
li = [1,'a','b','a',2,3,'a','laonaihai']

print(li.index('a'))
执行输出:
1
列表的嵌套
li = [1,2,'alex',['100','wusir',99],22]
1.将alex 变成首字母大写的Alex
2.将wusir变成全部大写的wusir放到原处
3.将99加1变成100,返回原处
解题答案:
li = [1,2,'alex',['100','wusir',99],22]

#首字母大写

li[2] = li[2].capitalize()

#转换大写

li[3][1] = li[3][1].upper()

#数值加1

li[3][2] += 1

print(li)
执行输出:
[1, 2, 'Alex', ['100', 'WUSIR', 100], 22]
二、元组tupe
元组被称为只读列表,即数据可以被查询,但不能被修改,所以,字符串的切片操作同样适用于元组。例:(1,2,3)("a","b","c"
tu = (1,2,'alex','oldboy')

#切片

print(tu[:2])

#指定索引取值

print(tu[2])
执行输出:
(1, 2)
alex
遍历元祖
tu = (1,2,'alex','oldboy')

for i in tu:

    print(i)
执行输出:
1
2
alex
oldboy
有一种情况,元组的值会改变,俗称:
儿子不能改,孙子可能改
tu = (1,2,'alex',[1,'taibai'],'oldboy')

tu[3].append('yuhuang')

print(tu)
执行输出:
(1, 2, 'alex', [1, 'taibai', 'yuhuang'], 'oldboy')
一般元组,是放只读的数据。所以不会随意更改。
公用方法:count,len,index
三、range
range 当成一个数字列表,范围
范围可控,步长可正可负
打印0到9
for i in range(10):

    print(i)
执行输出:
0
1
2
3
4
5
6
7
8
9
注意:range()不会打印末尾的数字,默认是从0开始的。
打印1~10之间的奇数
for i in range(1,10,2):

    print(i)
执行输出:
1
3
5
7
9
打印0~10之间的偶数
for i in range(0,10,2):

    print(i)
执行输出:
0
2
4
6
8
反向步长
倒序输出1到10
for i in range(10,0,-1):

    print(i)
执行输出:
10
9
8
7
6
5
4
3
2
1
遍历列表元素,打印每一个索引值
li = [2,3,'alex',4,5]

for i in li:

    print(li.index(i))
执行输出:
0
1
2
3
4
使用range打印索引
li = [2,3,'alex',4,5]

for i in range(0,len(li)):

    print(i)
执行输出:
0
1
2
3
4
列表长度永远比索引值大1
所以可以用range方式
四、join
join用字符串做一个连接符
连接可迭代对象中的每一个元素,形成一个新的字符串
s = '@'.join('我是谁')

print(s)
执行输出:
我@是@谁
split str ---> list
使用split方法将字符串转换为列表
s1 = 'wusir taibai xiao'

print(s1.split())
执行输出:
['wusir', 'taibai', 'xiao']
join list ---> str
使用join方法将列表转换为字符串
li = ['wusir', 'taibai', 'xiao']

print(' '.join(li))
执行输出:
wusir taibai xiao
join很重要,一定要掌握
思考题:
li = [1,2,['alex','wusir'],'a','b',{'name':'xiao','age':21}]
将列表中的每一个元素打印出来,如果遇到列表,需要打印列表中的每一个元素
答案如下:
li = [1, 2, ['alex', 'wusir'], 'a', 'b']

for i in li:

    if type(i) == list:

        for j in i:

            print(j)

    else:

        print(i)
执行输出:
1
2
alex
wusir
a
b
如果列表包含字典以及元组呢?
li = [1,2,['alex','wusir'],'a','b',{'name':'xiao','age':21},('d','n','f')]

for i in li:

    #判断元素类型是否是整形和布尔值,除了这2种类型,其他类型都是可迭代对象

    if type(i) not in [int,bool]:

        # 判断元素的长度等于1,排除有多个元素的数据,比如列表,字典...

        if len(i) == 1:

            print(i)

        else:

            #循环可迭代对象

            for j in i:

                print(j)
执行输出:
1
2
alex
wusir
a
b
name
age
d
n
f
第2种写法:
#加载模块

from collections import Iterable

li = [1,2,['alex','wusir'],'a','b',{'name':'xiao','age':21},('d','n','f')]

for i in li:

    #判断是否是可迭代对象

    if isinstance(i,Iterable):

        for j in i:

            print(j)

    else:

        print(i)
执行程序,效果同上
今日作业:
1,写代码,有如下列表,按照要求实现每一个功能

li = ['alex','wusir','eric','rain','alex']

    1)计算列表的长度并输出

    2)列表中追加元素'seven',并输出添加后的列表

    3)请在列表的第1个位置插入元素'Tony',并输出添加后的列表

    4)请修改列表第2个位置的元素为'Kelly',并输出修改后的列表

    5)请将列表l2=[1,'a',3,4,'heart']的每一个元素添加到列表li中,一行代码实现,不允许循环添加。

    6)请将字符串s = 'qwert'的每一个元素添加到列表li中,一行代码实现,不允许循环添加。

    7)请删除列表中的元素'eric',并输出添加后的列表

    8)请删除列表中的第2个元素,并输出删除的元素和删除元素后的列表

    9)请删除列表中的第2至4个元素,并输出删除元素后的列表

    10)请将列表所有得元素反转,并输出反转后的列表

    11)请计算出'alex'元素在列表li中出现的次数,并输出该次数。

2,写代码,有如下列表,利用切片实现每一个功能

li = [1,3,2,'a',4,'b',5,'c']

    1)通过对li列表的切片形成新的列表l1,l1 = [1,3,2]

    2)通过对li列表的切片形成新的列表l2,l2 = ['a',4,'b']

    3)通过对li列表的切片形成新的列表l3,l3 = ['1,2,4,5]

    4)通过对li列表的切片形成新的列表l4,l4 = [3,'a','b']

    5)通过对li列表的切片形成新的列表l5,l5 = ['c']

    6)通过对li列表的切片形成新的列表l6,l6 = ['b','a',3]

3,写代码,有如下列表,按照要求实现每一个功能。

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

    1)将列表lis中的'tt'变成大写(用两种方式)。

    2)将列表中的数字3变成字符串'100'(用两种方式)。

    3)将列表中的字符串'1'变成数字101(用两种方式)。

4,请用代码实现:

       li = ['alex','eric','rain']

利用下划线将列表的每一个元素拼接成字符串"alex_eric_rain"

5,查找列表li中的元素,移除每个元素的空格,并找出以'A'或者'a'开头,并以'c'结尾的所有元素,并添加到一个新列表中,最后循环打印这个新列表。

li = ['taibai ','alexC','AbC ','egon',' Ritian',' Wusir','  aqc']

6、开发敏感词语过滤程序,提示用户输入评论内容,如果用户输入的内容中包含特殊的字符:

敏感词列表 li = ["苍老师","东京热","武藤兰","波多野结衣"]

则将用户输入的内容中的敏感词汇替换成***,并添加到一个列表中;如果用户输入的内容没有敏感词汇,则直接添加到上述的列表中。

7,有如下列表li = [1,3,4',alex',[3,7,8,'taibai'],5,'ritian']

循环打印列表中的每个元素,遇到列表则再循环打印出它里面的元素。

我想要的结果是(用两种方法实现,其中一种用range做):

1

3

4

'alex'

3

7,

8

'taibai'

5

ritian

明日默写内容

1,将列表的增删改查不同的方法全部写出来,

例如:增:有三种,append:在后面添加。Insert按照索引添加,expend:迭代着添加。

2,默写第七题的两个方法实现的代码。
答案
第一题:
1,写代码,有如下列表,按照要求实现每一个功能

li = ['alex','wusir','eric','rain','alex']

    1)计算列表的长度并输出

li = ['alex','wusir','eric','rain','alex']

s1 = len(li)

    2)列表中追加元素'seven',并输出添加后的列表

li = ['alex','wusir','eric','rain','alex']

s2 = li.append('seven')

print(li)

    3)请在列表的第1个位置插入元素'Tony',并输出添加后的列表

li = ['alex','wusir','eric','rain','alex']

li = ['alex','wusir','eric','rain','alex']

s3 = li.insert(1,'Tony')

print(li)

    4)请修改列表第2个位置的元素为'Kelly',并输出修改后的列表

li = ['alex','wusir','eric','rain','alex']

li[2] = 'Kelly'

print(li)

    5)请将列表l2=[1,'a',3,4,'heart']的每一个元素添加到列表li中,一行代码实现,不允许循环添加。

li = ['alex','wusir','eric','rain','alex']

l2=[1,'a',3,4,'heart']

li.extend(l2)

print(li)

    6)请将字符串s = 'qwert'的每一个元素添加到列表li中,一行代码实现,不允许循环添加。

li = ['alex','wusir','eric','rain','alex']

s = 'qwert'

li.extend(s)

print(li)

    7)请删除列表中的元素'eric',并输出添加后的列表

li = ['alex','wusir','eric','rain','alex']

li.remove('eric')

print(li)

    8)请删除列表中的第2个元素,并输出删除的元素和删除元素后的列表

li = ['alex','wusir','eric','rain','alex']

print(li.pop(2))

print(li)

    9)请删除列表中的第2至4个元素,并输出删除元素后的列表

li = ['alex','wusir','eric','rain','alex']

del li[2:4]

print(li)

    10)请将列表所有得元素反转,并输出反转后的列表

li = ['alex','wusir','eric','rain','alex']

li.reverse()

print(li)

    11)请计算出'alex'元素在列表li中出现的次数,并输出该次数。

li = ['alex','wusir','eric','rain','alex']

print(li.count('alex'))
第2题答案
2,写代码,有如下列表,利用切片实现每一个功能

li = [1,3,2,'a',4,'b',5,'c']

    1)通过对li列表的切片形成新的列表l1,l1 = [1,3,2]

li = [1,3,2,'a',4,'b',5,'c']

li1 = li[:3]

print(li1)

    2)通过对li列表的切片形成新的列表l2,l2 = ['a',4,'b']

li = [1,3,2,'a',4,'b',5,'c']

li2 = li[3:6]

print(li1)

    3)通过对li列表的切片形成新的列表l3,l3 = ['1,2,4,5]

li = [1,3,2,'a',4,'b',5,'c']

li3 = li[::2]

print(li3)

    4)通过对li列表的切片形成新的列表l4,l4 = [3,'a','b']

li = [1,3,2,'a',4,'b',5,'c']

li4 = li[1:6:2]

print(li3)

    5)通过对li列表的切片形成新的列表l5,l5 = ['c']

li = [1,3,2,'a',4,'b',5,'c']

li5 = li[-1]

print(li3)

    6)通过对li列表的切片形成新的列表l6,l6 = ['b','a',3]

li = [1,3,2,'a',4,'b',5,'c']

li6 = li[-3:-8:-2]

print(li6)
第3题答案
3,写代码,有如下列表,按照要求实现每一个功能。

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

    1)将列表lis中的'tt'变成大写(用两种方式)。

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

lis[3][2][1][0] = lis[3][2][1][0].upper()

print(lis)

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

lis[3][2][1][0] = 'TT'

print(lis)

    2)将列表中的数字3变成字符串'100'(用两种方式)。

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

lis[1] = 100

lis[3][2][1][1] = '100'

print(lis)

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

lis[1] = '100'

lis[3][2][1][1] = str(lis[3][2][1][1] + 97)

print(lis)

    3)将列表中的字符串'1'变成数字101(用两种方式)。

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

lis[3][2][1][2] = 101

print(lis)

lis = [2,3,'k',['qwe',20,['k1',['tt',3,'1']],89],'ab','adv']

lis[3][2][1][2] = 1 + 100

print(lis)
第4题答案
4,请用代码实现:

       li = ['alex','eric','rain']

利用下划线将列表的每一个元素拼接成字符串"alex_eric_rain"

li = ['alex','eric','rain']

li_new = '_'.join(li)

print(li_new)
第5题
查找列表li中的元素,移除每个元素的空格,并找出以'A'或者'a'开头,并以'c'结尾的所有元素,并添加到一个新列表中,最后循环打印这个新列表。
li = ['taibai ','alexC','AbC ','egon',' Ritian',' Wusir',' aqc']
分析:
先输出每一个元素,每把每个元素去除空格
li = ['taibai ','alexC','AbC ','egon',' Ritian',' Wusir','  aqc']

for i in li:

    s = i.strip()

    print(s)
执行输出:
taibai
alexC
AbC
egon
Ritian
Wusir
aqc
找到以'A'或者'a'开头的
li = ['taibai ','alexC','AbC ','egon',' Ritian',' Wusir','  aqc']

for i in li:

    s = i.strip()

    if s.startswith("A") or s.startswith("a"):

        print(s)
执行输出:
alexC
AbC
aqc
并以'c'结尾的,使用endswith()方法。打印出匹配的结果
li = ['taibai ','alexC','AbC ','egon',' Ritian',' Wusir','  aqc']

for i in li:

    s = i.strip()

    if s.startswith("A") or s.startswith("a"):

        if s.endswith("c"):

            print(s)
执行输出:
aqc
将匹配的元素添加到一个新列表中,最后循环打印这个新列表,最终代码如下:
li = ['taibai ','alexC','AbC ','egon',' Ritian',' Wusir','  aqc']

#定义新列表

li_new = []

for i in li:

    #去除空格

    s = i.strip()

    #找出以'A'或者'a'开头

    if s.startswith("A") or s.startswith("a"):

        #找出以'c'结尾的所有元素

        if s.endswith("c"):

            #将匹配的元素追加到新列表中

            li_new.append(s)

for j in li_new:

    print(j)
执行输出:
aqc
第6题
开发敏感词语过滤程序,提示用户输入评论内容,如果用户输入的内容中包含特殊的字符:
敏感词列表 li = ["苍老师","东京热","武藤兰","波多野结衣"]
则将用户输入的内容中的敏感词汇替换成***,并添加到一个列表中;如果用户输入的内容没有敏感词汇,则直接添加到上述的列表中。
解题过程
先定义2个变量,一个是敏感词,一个是用户输入内容
并设置一个含有敏感词的内容,判断是否含有敏感词
li = ["苍老师","东京热","武藤兰","波多野结衣"]

comment = "我要苍老师"

for i in li:

    if i in comment:

        print("含有敏感词")
执行输出:
含有敏感词
将敏感词替换成***,使用replace()方法替换,打印出输入内容
li = ["苍老师","东京热","武藤兰","波多野结衣"]

comment = "我要苍老师"

for i in li:

    if i in comment:

        print("含有敏感词")

        comment = comment.replace(i, "***")

print(comment)
执行输出:
含有敏感词
我要***
将输入内容写入到新列表中,打印列表:
li = ["苍老师","东京热","武藤兰","波多野结衣"]

comment = "我要苍老师"

#新列表

comment_list = []

for i in li:

    if i in comment:

        #将敏感词替换成***

        comment = comment.replace(i,"***")

#添加到新列表

comment_list.append(comment)

for j in comment_list:

    print(j)
执行输出:
我要***
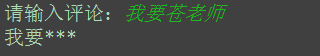
将用户输入替换成input,完整代码如下:
li = ["苍老师","东京热","武藤兰","波多野结衣"]

comment = input("请输入评论:").strip()

#新列表

comment_list = []

for i in li:

    if i in comment:

        #将敏感词替换成***

        comment = comment.replace(i,"***")

#添加到新列表

comment_list.append(comment)

#打印列表

for j in comment_list:

    print(j)
执行输出:
第7题
有如下列表li = [1,3,4',alex',[3,7,8,'taibai'],5,'ritian']
循环打印列表中的每个元素,遇到列表则再循环打印出它里面的元素。
我想要的结果是(用两种方法实现,其中一种用range做):
1
3
4
'alex'
3
7,
8
'taibai'
5
ritian
for循环 代码如下:
li = [1,3,4,'alex',[3,7,8,'taibai'],5,'ritian']

for i in li:

    #判断是否为列表

    if type(i) == list:

        #遍历子列表

        for j in i:

            print(j)

    else:

        print(i)
执行输出:
1
3
4
alex
3
7
8
taibai
5
ritian
range方式,代码如下:
li = [1,3,4,'alex',[3,7,8,'taibai'],5,'ritian']

for i in range(len(li)):

    #判断是否为列表

    if type(li[i]) == list:

        #遍历子列表

        for j in li[i]:

            print(j)

    else:

        print(li[i])
执行程序,效果同上。
明日默写内容
1,将列表的增删改查不同的方法全部写出来,
例如:增:有三种,append:在后面添加。Insert按照索引添加,expend:迭代着添加。
增

append() 追加,在最后一个位置添加元素

insert() 按照索引添加

expend 迭代着添加

删

pop() 按照索引删除

remove() 按照元素删除

clear() 清空列表的所有元素

del 删除列表
改
按照索引修改
切片修改
查
index() 查看索引
根据索引
切片
步长
2,默写第七题的两个方法实现的代码。
for循环 :
li = [1,3,4,'alex',[3,7,8,'taibai'],5,'ritian']

for i in li:

    #判断是否为列表

    if type(i) == list:

        #遍历子列表

        for j in i:

            print(j)

    else:

        print(i)
range方式:
li = [1,3,4,'alex',[3,7,8,'taibai'],5,'ritian']

for i in range(len(li)):

    #判断是否为列表

    if type(li[i]) == list:

        #遍历子列表

        for j in li[i]:

            print(j)

    else:

        print(li[i])
python 全栈开发,Day4(正式)的更多相关文章
- Python全栈开发day4
1.python三元运算 实现方法: result = 值1 if 条件 else 值2 例如: 1 2 3 4 #!/bin/env python #-*- coding:utf-8 -*- nam ...
- python全栈开发-Day4 列表
python全栈开发-Day4 列表 一.首先按照以下几个点展开列表的学习 #一:基本使用 1 用途 2 定义方式 3 常用操作+内置的方法 #二:该类型总结 1 存一个值or存多个值 只能存一个值 ...
- Python全栈开发【面向对象进阶】
Python全栈开发[面向对象进阶] 本节内容: isinstance(obj,cls)和issubclass(sub,super) 反射 __setattr__,__delattr__,__geta ...
- Python全栈开发【面向对象】
Python全栈开发[面向对象] 本节内容: 三大编程范式 面向对象设计与面向对象编程 类和对象 静态属性.类方法.静态方法 类组合 继承 多态 封装 三大编程范式 三大编程范式: 1.面向过程编程 ...
- Python全栈开发【模块】
Python全栈开发[模块] 本节内容: 模块介绍 time random os sys json & picle shelve XML hashlib ConfigParser loggin ...
- Python全栈开发【基础四】
Python全栈开发[基础四] 本节内容: 匿名函数(lambda) 函数式编程(map,filter,reduce) 文件处理 迭代器 三元表达式 列表解析与生成器表达式 生成器 匿名函数 lamb ...
- Python全栈开发【基础三】
Python全栈开发[基础三] 本节内容: 函数(全局与局部变量) 递归 内置函数 函数 一.定义和使用 函数最重要的是减少代码的重用性和增强代码可读性 def 函数名(参数): ... 函数体 . ...
- Python全栈开发【基础二】
Python全栈开发[基础二] 本节内容: Python 运算符(算术运算.比较运算.赋值运算.逻辑运算.成员运算) 基本数据类型(数字.布尔值.字符串.列表.元组.字典) 其他(编码,range,f ...
- Python全栈开发【基础一】
Python全栈开发[第一篇] 本节内容: Python 的种类 Python 的环境 Python 入门(解释器.编码.变量.input输入.if流程控制与缩进.while循环) if流程控制与wh ...
- python 全栈开发之路 day1
python 全栈开发之路 day1 本节内容 计算机发展介绍 计算机硬件组成 计算机基本原理 计算机 计算机(computer)俗称电脑,是一种用于高速计算的电子计算机器,可以进行数值计算,又可 ...
随机推荐
- UVa 11988破损的键盘
这题是很好的学习用数组实现链表的例子. 原题链接 UVa11988 题意 输入一段文本,字符'['表示Home键,']'表示End键.输出屏幕上面的结果. 思路 难点在于在字符串的头和尾插入字符,如果 ...
- Docker系统四:Dcoker的镜像管理
1. Dcoker镜像初识 $ docker images -a //查看当前所有镜像 REPOSITORY TAG IMAGE ID CREATED SIZE cptactionhank/atlas ...
- C语言老司机学Python (五)
今天看的是标准库概览. 操作系统接口: 用os模块实现. 针对文件和目录管理,还有个shutil模块可以用. 例句: import os os.getcwd() # 返回当前的工作目录 os.chdi ...
- win10 , JAVA安装 环境搭建
一.关于下载地址及方式: 1.百度搜索JDK,进入下载官网,具体网址如下: click me!!! 2.根据你电脑的不同系统选择对应的下载,当然首先你要点击Accept License Agreeme ...
- 实战项目:EMOS集成邮件平台
实战项目:EMOS集成邮件平台用户邮箱系统:http://mailAnonymous.cn/邮件服务器管理平台http://mailAnonymous.cn/extman 项目需求:随着公司规模不断扩 ...
- 【前端】Vue和Vux开发WebApp日志二、优化gulp任务
转载请注明出处:http://www.cnblogs.com/shamoyuu/p/vue_vux_2.html 项目github地址:https://github.com/shamoyuu/vue- ...
- 经典卷积神经网络(LeNet、AlexNet、VGG、GoogleNet、ResNet)的实现(MXNet版本)
卷积神经网络(Convolutional Neural Network, CNN)是一种前馈神经网络,它的人工神经元可以响应一部分覆盖范围内的周围单元,对于大型图像处理有出色表现. 其中 文章 详解卷 ...
- 基于LDA的Topic Model变形
转载于: 转:基于LDA的Topic Model变形 最近有想用LDA理论的变形来解决问题,调研中.... 基于LDA的Topic Model变形 基于LDA的Topic Model变形最近几年来,随 ...
- HighCharts中的无主题的2D折线图
HighCharts中的无主题的2D折线图 1.设计源码 <!DOCTYPE html> <html> <head> <meta charset=" ...
- hdu3081 Marriage Match II
新年第一篇,又花了一早上,真是蠢啊! 二分+网络流 之前对于讨论哪些人是朋友的时候复杂度过高 直接n3的暴力虽然看起来复杂度高,其实并不是每次都成立 #include<bits/stdc++.h ...