
Python 学习(1) 简单的小爬虫
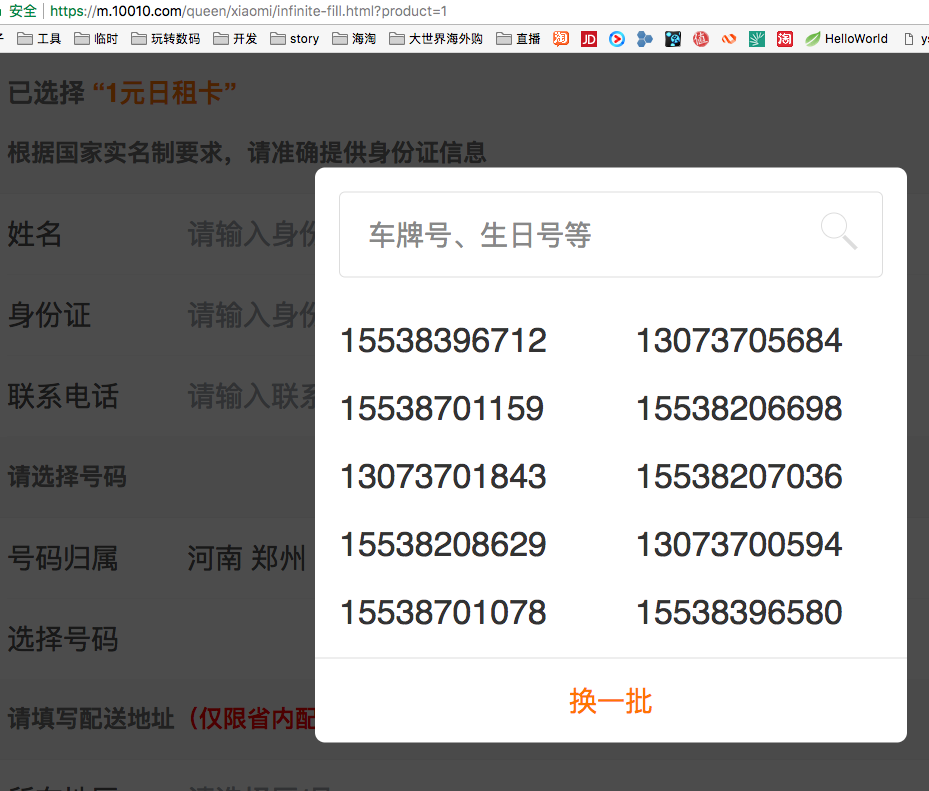
最近抽空学了两天的Python,基础知识都看完了,正好想申请个联通日租卡,就花了2小时写了个小爬虫,爬一下联通日租卡的申请页面,看有没有好记一点的手机号~ 人工挑眼都挑花了。
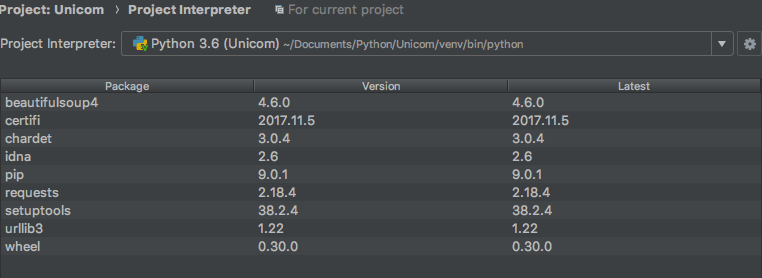
用的IDE是PyCharm,首先下载一些需要用到的包和模块: requests 和 beautifulsoup4。 不过发现请求的url返回的是json数据,就没用beautifulsoup4而是直接用正则提取手机号了。
注释写的还是很详细的,打分的方法非常简陋,一般这种便宜的套餐也没啥好号,今天太晚了,就这样吧,哪天有空了可以在增加些打分的规则。 代码在下面: 困,睡觉去~
 import time

 import random

 import requests

 import socket

 import re

 import http.client

 import sys

 URL = 'https://m.10010.com/NumApp/NumberCenter/qryNum?callback=jsonp_queryMoreNums&provinceCode=76&cityCode=760&monthFeeLimit=0&groupKey=41242783&searchCategory=3&net=01&amounts=200&codeTypeCode=&searchValue=&qryType=02&goodsNet=4&_=1513948237449'

 def get_content(url):

     '''获取url内容'''

     #request header信息

     header = {

         'Accept': 'text/javascript, application/javascript, application/ecmascript, application/x-ecmascript, */*; q=0.01',

         'Accept-Encoding': 'gzip, deflate, br',

         'Accept-Language': 'zh-CN,zh;q=0.9',

         'Connection': 'keep-alive',

         'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36'

     }

     #超时时间

     timeout = random.choice(range(80,180))

     while True:

         try:

             #请求url获取返回的response对象

             rep = requests.get(url, headers=header, timeout=timeout)

             # rep = requests.get(url)

             rep.encoding = 'utf-8'

             break

         except:

             #出错后延迟一段你时间重试

             time.sleep(random.choice(range(5, 20)))

     return rep.text

 def grade(phone):

     '''给手机号打分'''

     if phone[3:7] == phone[7:]:#1--abcdabcd

         return 100

     elif phone[3:5] == phone[7:9] and phone[5:7] == phone[9:]: #1--aabbaabb

         return 95

     elif phone[3:7] == phone[7::-1]: #1--abcddcba

         return 90

     elif phone[7:9] == phone[9:]: #尾号aabb

         return 80

     elif phone[7:9] == phone[9::-1]: #尾号abba

         return 70

     elif phone[3:5] == phone[7:9]: #1--ab--ab--

         return 50

     else:

         return 0

     #可以在加一些其他的判定条件

 def save_resule(result):

     '''把结果保存到result.txt文件'''

     if len(result) > 0:

         with open('result.txt', 'a') as f:

             for x in result:

                 f.write(x + '\n')

 #循环查询次数

 loop = 5

 #结果集合

 result = []

 if len(sys.argv) == 2:

     loop = int(sys.argv[1])

 for i in range(1, loop+1):

     # now = time.strftime('%Y-%m-%d %H:%M:%S', time.localtime(time.time()))

     # print('{}  第{}次查询'.format(now, i))

     html = get_content(URL) #请求url,获取json内容

     # print(html)

     regex_str = r'1\d{10}'

     #提取手机号

     phones = re.findall(regex_str, html)

     for x in phones:

         level = grade(x)

         if level > 0 and x not in result:

             result.append(x)

             print(level, '-', x)

     time.sleep(random.choice(range(1, 5)))#不要请求的太频繁

 save_resule(result)#循环结束保存到result.txt文件
Python 学习(1) 简单的小爬虫的更多相关文章
- 利用python写一个简单的小爬虫 爬虫日记(1)(好好学习)
打开py的IDLE >>>import urllib.request >>>a=urllib.request.urlopen("http://www.ba ...
- 【python】一个简单的贪婪爬虫
这个爬虫的作用是,对于一个给定的url,查找页面里面所有的url连接并依次贪婪爬取 主要需要注意的地方: 1.lxml.html.iterlinks() 可以实现对页面所有url的查找 2.获取页面 ...
- Python学习---抽屉框架分析[小评论分析]0315
注: 此处的小评论涉及数据库操作 初级小评论代码 settings.py INSTALLED_APPS = [ ... 'app01', # 注册app ] STATICFILES_DIRS = (o ...
- Python 用Redis简单实现分布式爬虫
Redis通常被认为是一种持久化的存储器关键字-值型存储,可以用于几台机子之间的数据共享平台. 连接数据库 注意:假设现有几台在同一局域网内的机器分别为Master和几个Slaver Master连接 ...
- Python学习 —— 实现简单的爬虫
为了加快学习python3.x,查了许多资料后写了这个脚本,这个脚本主要是爬取百度图片'东方幻想乡'的图片,但还是有很多问题存在. 下面给出代码: # 更新了一下代码 from urllib impo ...
- python学习:猜数字小游戏
在学习python过程中,没有项目做,就想到哪儿弄到哪儿. 头一发.让机器随机固定一个数字,然后让人去猜. 就这么简单.代码如下: #-*- encoding:utf8 -*- import rand ...
- 用Nodejs做一个简单的小爬虫
Nodejs将JavaScript语言带到了服务器端,作为js主力用户的前端们,因此获得了服务器端的开发能力,但除了用express搭建一个博客外,还有什么好玩的项目可以做呢?不如就做一个网络爬虫吧. ...
- 用python写个简单的小程序,编译成exe跑在win10上
每天的工作其实很无聊,早知道应该去IT公司闯荡的.最近的工作内容是每逢一个整点,从早7点到晚11点,去查一次客流数据,整理到表格中,上交给素未蒙面的上线,由他呈交领导查阅. 人的精力毕竟是有限的,所以 ...
- 用Python做一个简单的小游戏
学习总是枯燥的,对于Python小白的我来讲,更是乏味的.为了提高学习的兴趣,今天我就来写一个小程序练练手. 数字猜谜游戏相信大家都不陌生,A给出最小值最大值,B写一个该范围内的数,A猜测写下的是多少 ...
随机推荐
- 新增加的HTTP状态码 -- 103
IETF公布了新的HTTP状态码-103, 总结一下就是提前预加载(css.js)文档,提升用户的访问速度. Summary: a new status code that lets the serv ...
- 关于史考特证券(scottrade Inc)资金转出的手续费问题
投资美股账户的朋友可能开始的时候并没有关心史考特账户转出的费用,其实,仔细算一下这个费用还是蛮贵的,根据官网的文档可以明确知道,转出史考特账户资金到国内银行的费用由以下几项组成: 1. 国际电汇资金费 ...
- Java的DAO设计模式
用java的DAO模式实现对一个学生实体的增加,查询操作. 1.建立一个学生实体类 Student.java public class Student { private String sid; pr ...
- C/C++程序在main之前执行代码
来源:<周哥教IT.C语言深学活用>https://ke.qq.com/course/242707#tuin=a71606 我们在学习C/C++语言的时候,通常认为main函数是整个程序执 ...
- [转发]读取txt防止读到乱码--自动根据文件编码进行读取
以下是摘抄 /// <summary> /// 获取文件的编码格式 /// </summary> public class EncodingType { /// <sum ...
- httpwebrequest 用GET方法时报无法发送具有此谓词类型的内容正文
如下一段小程序,运行结果报无法发送具有此谓词类型的内容正文的错误,其实原因很简单,因为用的是GET的方式进行提交,而GetRequestStream()是用来在post提交的时候写post的内容的流, ...
- Visual Studio 生成DLL文件
新建一个项目,在菜单栏中选择“项目”/“**属性”选项,该页面中将“输出类型”下拉列表中的选项选择为“类库”,然后重新生成一下该项目,或者在“Visual Studio 2008命令提示”中输入以下命 ...
- [转载] Bitmap的秘密
转载自http://www.infoq.com/cn/articles/the-secret-of-bitmap/ 之前已经参加过几次QCon峰会,不过今年QCon 2014 上海峰会对我来说比较特别 ...
- 阿里Dubbo疯狂更新,关Spring Cloud什么事?
最近,开源社区发生了一件大事,那个全国 Java 开发者使用最广的开源服务框架 Dubbo 低调重启维护,并且 3 个月连续发布了 4 个维护版本. 我上次在写放弃Dubbo,选择最流行的Spring ...
- Python 动态导入模块
动态导入模块 目录结构: zhangsandeMacBook-Air:1110 zhangsan$ tree . . ├── lib │ └── aa.py ├── test1.py lib目录下 ...