
【学习】数据的加载、存储与文件格式【pandas】
输入输出通常可以划分为几个大类:读取文本文件和其他更高效的磁盘存储格式,加载数据库中的数据,利用web API操作网络资源
1、读写文本格式的数据
pandas提供了一些用于将表格型数据读取为DataFrame对象的函数,其中read_csv和read_table为用得最多的
#函数说明

"""

=========函数说明==========

read_csv 从文件、URL、文件型对象中加载带分隔符的数据,默认分隔符为逗号

read_table  从文件、URL、文件型对象中加载带分隔符的数据,默认分隔符为制表符(”\t“)

read_fwf 读取定宽列格式数据(也就是说,没有分隔符)

read_clipboard 读取剪贴板中的数据,可以看到read_table的剪贴板版。在将网页转换为表格时很有用

"""
这些函数的选项可以划分为以下几个大类:
索引:将一个或多个列当作返回的DataFrame处理,以及是否从文件、用户获取列名
类型推断和数据转换:包括用户定义值的转换、缺失值标记列表等
日期解析:包括组合功能,比如将分散在多个列中的日期时间信息组合成结果中的单个列
迭代:支付对大文件进行逐块迭代
不规整数据问题:跳过一些行、页脚、注释或其他一些不重要的东西(比如成千万上万个逗号隔开的数值数据)
类型推断是这些函数中最重要的功能之一,也就是说,你不需要指定列的类型到底是数值、整数、布尔值,还是字符串。
比如有一个文件ex1.csv
#用read_csv读取

df = pd.read_csv('ex1.csv')

#用read_table函数, 但需要指定分隔符而已

df = pd.read_table('ex1.csv', sep = ',')
并不是所有文件都有标题行,有两个办法,一个是默认,另一个是自定义列名
#默认标题名
pd.read_csv('ext1.csv', header=None)

#指定列名
pd.read_csv('ex1.csv', names = ['a', 'b', 'c', 'd', 'message'])

#假设读取出来的df数据内容为以下,为了展示用
"""

"""

#如果你希望将message列做成DataFrame 的索引, 可以明确表示要将该列放在索引4的位置上,也可以通过index_col参数指定“message”
pd.read_csv('ex1.csv', names = ['a', 'b', 'c', 'd', 'message'], index_col = 'message')

#缺失值处理是文件解析任务中的一个重要组成部分
#na_values可以接受一组用于表示缺失值的字符串
pd.read_csv('ext1.csv', na_values = ['NULL'])
#可以用一个字典为各列指定不同的NA标记值
#read_csv/read_table函数的参数
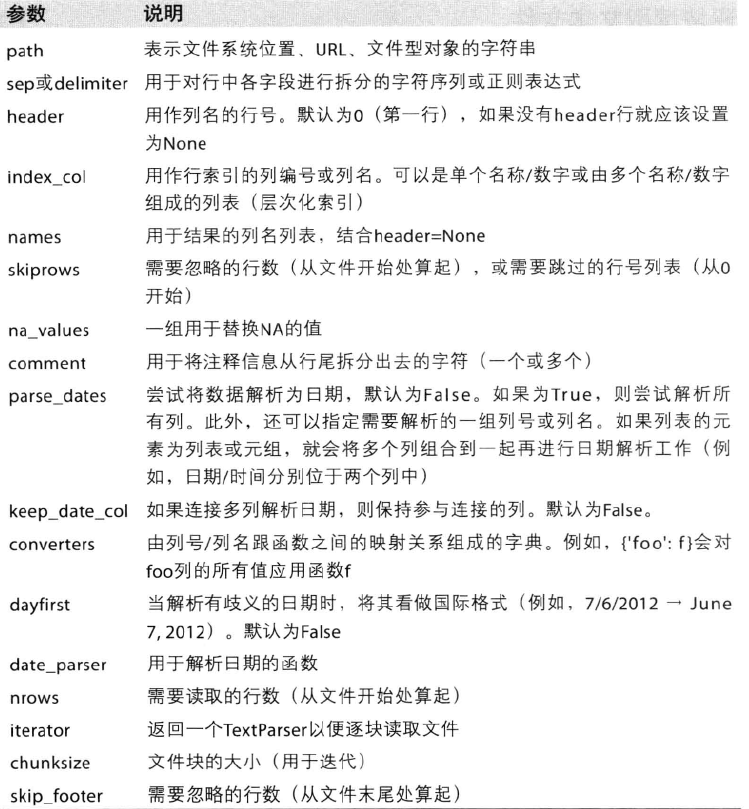
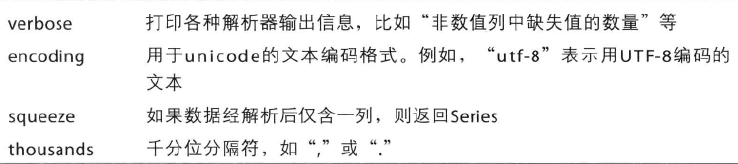
注意:encoding可以规范编码格式,utf-8一般可以防止中文乱码;
nrows需要读取的行数(从文件开始处算起);
data_parser用于解析日期的函数;
parse_dates 尝试将数据解析为日期,默认为False,如果为True,则尝试解析所有列。
names 用于结果的列名列表,结合header = None
chunksize 文件块的大小(用于迭代)
如果用到选项和属性再加上,做好笔记是一个很好的习惯。。。。。。。。。
2、逐块读取文本文件
如果只想读取几行,通过nrows进行指定即可
pd.read_csv('ext1.csv', nrows = 5)
要逐块读取文件,需要设置chunksize(行数):
pd.read_csv('ex.csv', chunksize = 1000)
#返回的这个TextParser对象使你可以根据chunksize对文件进行逐块迭代
tot = Series[]
for piece in chunker:
  tot = tot.add(piece['key'].value_counts(), fill_value = 0)
tot = tot.order(ascending = False)
#TestParser还有一个get_chunk方法,它使你可以读取任意大小的块
3、将数据写出到文本格式
利用DataFrame的to_csv方法,可以将数据写到一个以逗号分隔的文件中,当然也可以使用其他分隔符
也可以只写出一部分的列
#3、将数据写出到文本格式

df = pd.DataFrame(np.random.randn(4,5), columns = ['name1', 'name2', 'name3', 'name4', 'name5'])

df

df.to_csv('out1.csv')

df.to_csv('out2.txt', sep = '|')

#将缺失值在输出结果中被表示为空字符串,也可以表示 为别的标记值, 用na_sep参数

df.to_csv('out2.txt', na_sep = 'NULL')

#如果没有设置其他选项,则会写出行和列的标签,可以禁用标签

df.to_csv('out1.csv', index = False, header = False)

#只写出一部分列,并以指定的顺序排列

df.to_csv('out2.csv', index = False, columns = ['name1', 'name2'])

#将文本读取为Series,但是要无header行,第一列作索引
CSV函数选项
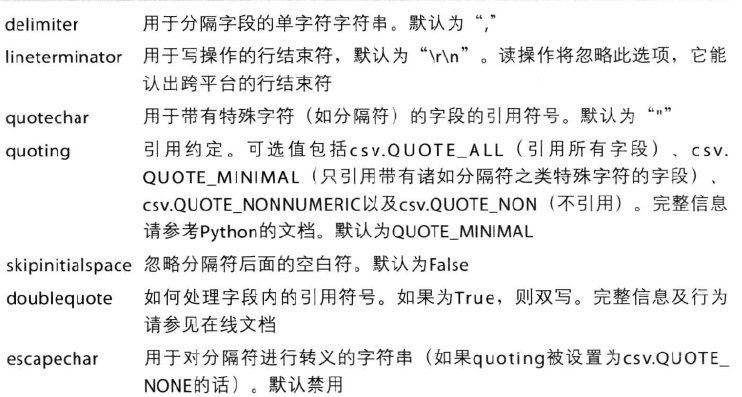
注意:对于那些使用复杂分隔符或多字符分隔符的文件,你就只能使用字符串的split方法或正则表达式方法re.split进行行拆分和其他 整理工作
4、Json数据格式
import json
result = json.loads(obj)
asjson = json.dumps(result)
5、XML数据格式
XML是另一种常见的支持分层、嵌套数据以及元数据的结构化数据格式,这个会有另外一个文档说明,有时候XML非常复杂,但在数据分析过程中也非常常见
【学习】数据的加载、存储与文件格式【pandas】的更多相关文章
- 利用python进行数据分析之数据加载存储与文件格式
在开始学习之前,我们需要安装pandas模块.由于我安装的python的版本是2.7,故我们在https://pypi.python.org/pypi/pandas/0.16.2/#downloads ...
- ARM学习笔记4——加载存储指令
一.字数据传送指令 作用:用于把单一的数据传入或者传出一个寄存器. 1.LDR指令 1.1.作用 根据<addr_mode>所确定的地址模式从内存中将一个32位的字段读取到目标寄存器< ...
- Android学习笔记_36_ListView数据异步加载与AsyncTask
一.界面布局文件: 1.加入sdcard写入和网络权限: <!-- 访问internet权限 --> <uses-permission android:name="andr ...
- Spark在处理数据的时候,会将数据都加载到内存再做处理吗?
对于Spark的初学者,往往会有一个疑问:Spark(如SparkRDD.SparkSQL)在处理数据的时候,会将数据都加载到内存再做处理吗? 很显然,答案是否定的! 对该问题产生疑问的根源还是对Sp ...
- EF如何操作内存中的数据以及加载相关联表的数据:延迟加载、贪婪加载、显示加载
之前的EF Code First系列讲了那么多如何配置实体和数据库表的关系,显然配置只是辅助,使用EF操作数据库才是每天开发中都需要用的,这个系列讲讲如何使用EF操作数据库.老版本的EF主要是通过Ob ...
- Unity3d通用工具类之数据配置加载类
今天,我们来讲讲游戏中的数据配置加载. 什么是游戏数据加载呢?一般来说游戏中会有场景地图. 按照国际惯例,先贴一张游戏场景的地图: 在这张地图上,我们可以看到有很多正六边形,正六边形上有树木.岩石等. ...
- cesium中json,geojson,stk,影像切片等数据的加载
cesium中json.topojson.geojson.stk,影像切片等数据的加载 一.geojson.topojson,json数据的加载 不管是哪种json,都可以通过GeoJsonDataS ...
- Java 爬虫遇上数据异步加载,试试这两种办法!
这是 Java 爬虫系列博文的第三篇,在上一篇 Java 爬虫遇到需要登录的网站,该怎么办? 中,我们简单的讲解了爬虫时遇到登录问题的解决办法,在这篇文章中我们一起来聊一聊爬虫时遇到数据异步加载的问题 ...
- 微信小程序云开发-列表数据分页加载显示
一.准备工作 1.创建数据库nums,向数据库中导入108条数据 2.修改数据库表nums的权限 二.新建页面ListPaginated 1.wxml文件 <!-- 显示列表数据 --> ...
- [Python]-pandas模块-机器学习Python入门《Python机器学习手册》-02-加载数据:加载文件
<Python机器学习手册--从数据预处理到深度学习> 这本书类似于工具书或者字典,对于python具体代码的调用和使用场景写的很清楚,感觉虽然是工具书,但是对照着做一遍应该可以对机器学习 ...
随机推荐
- Ubuntu使用命令行打印文件
Ubuntu使用命令行打印文件 正文 环境: Ubuntu 16.04.3 LTS HP Deskjet InkAdvantage 4648 准备步骤 安装Common UNIX Printing S ...
- AssetBundle-----资源包划分
资源包划分 经常更新的资源放在一个单独的包里面,跟不经常更新的包分离;需要同时加载的资源放在一个包里面;其他包共享的资源放在一个单独的包里面;需要同时加载的小资源打包成一个包;对于一个同一个资源有两个 ...
- window下为kibana安装x-pack时候出现Plugin installation was unsuccessful due to error "No valid url specified."错误的解决方案
在Windows环境下为kibana安装x-pack plugin的时候,按照官网提示的安装步骤执行命令: kibana-plugin install file:///E:/software/ELK/ ...
- centos安装mycat
1.参考前文安装jdk 2.官网 http://www.mycat.io/ 或 http://dl.mycat.io/ 下载mycat 3.解压安装 cd /usr/local cp /home/ta ...
- SDL播放YUV----单帧
用到的项目:Tocy-Android-SDLv2 C中的 入口: main.c as_lesson_XXX.c bmp_main : 在C中定义文件的路径: char *filepath = &quo ...
- c语言希尔排序,并输出结果(不含插入排序)
#include<stdio.h> void shellsort(int* data,int len) { int d=len; int i; ) { d=(d+)/; //增量序列表达方 ...
- How To Add Custom Build Steps and Commands To setup.py
转自:https://jichu4n.com/posts/how-to-add-custom-build-steps-and-commands-to-setuppy/ A setup.py scrip ...
- linux下目录简介——/SElinux
一.前言 安全增强型 Linux(Security-Enhanced Linux)简称 SELinux,它是一个 Linux 内核模块,也是 Linux 的一个安全子系统. SELinux 主要由美国 ...
- 创建一个dynamics 365 CRM online plugin (十一) - Handling Configuration data
Config data 可以在registering step 的时候来配置 配置好的config data 可以使用 constructor 来获取 Secure Config 和 UnSecure ...
- swiper内容滚动
<html> <head> <meta charset="UTF-8"> <meta name="viewport" ...