
《机器学习实战》学习笔记第五章 —— Logistic回归
一.有关笔记:
2.吴恩达机器学习笔记(十一) —— Large Scale Machine Learning
二.Python源码(不带正则项):
 # coding:utf-8

 '''

 Created on Oct 27, 2010

 Logistic Regression Working Module

 @author: Peter

 '''

 from numpy import *

 def sigmoid(inX):

     return 1.0 / (1 + exp(-inX))

 def gradAscent(dataMatIn, classLabels):

     dataMatrix = mat(dataMatIn)  # convert to NumPy matrix

     labelMat = mat(classLabels).transpose()  # convert to NumPy matrix

     m, n = shape(dataMatrix)

     alpha = 0.001

     maxCycles = 500

     weights = ones((n, 1))

     for k in range(maxCycles):  # heavy on matrix operations

         h = sigmoid(dataMatrix * weights)  # matrix mult

         error = (labelMat - h)  # vector subtraction

         weights = weights + alpha * dataMatrix.transpose() * error  # matrix mult

     return weights

 def stocGradAscent0(dataMatrix, classLabels,numIter=150):

     m, n = shape(dataMatrix)

     alpha = 0.01

     weights = ones(n)  # initialize to all ones

     for j in range(numIter):

         for i in range(m):

             h = sigmoid(sum(dataMatrix[i] * weights))

             error = classLabels[i] - h

             weights = weights + alpha * error * dataMatrix[i]

     return weights

 def stocGradAscent1(dataMatrix, classLabels, numIter=150):

     m, n = shape(dataMatrix)

     weights = ones(n)  # initialize to all ones

     for j in range(numIter):

         dataIndex = range(m)

         for i in range(m):

             alpha = 4 / (1.0 + j + i) + 0.0001  # apha decreases with iteration, does not

             randIndex = int(random.uniform(0, len(dataIndex)))  # go to 0 because of the constant

             h = sigmoid(sum(dataMatrix[randIndex] * weights))

             error = classLabels[randIndex] - h

             weights = weights + alpha * error * dataMatrix[randIndex]

             del (dataIndex[randIndex])

     return weights

 def classifyVector(inX, weights):

     prob = sigmoid(sum(inX * weights))

     if prob > 0.5:

         return 1.0

     else:

         return 0.0

 def colicTest():

     frTrain = open('horseColicTraining.txt')

     frTest = open('horseColicTest.txt')

     trainingSet = []

     trainingLabels = []

     for line in frTrain.readlines():

         currLine = line.strip().split('\t')

         lineArr = []

         for i in range(21):

             lineArr.append(float(currLine[i]))

         trainingSet.append(lineArr)

         trainingLabels.append(float(currLine[21]))

     trainWeights = stocGradAscent1(array(trainingSet), trainingLabels,500)

     errorCount = 0; numTestVec = 0.0

     for line in frTest.readlines():

         numTestVec += 1.0

         currLine = line.strip().split('\t')

         lineArr = []

         for i in range(21):

             lineArr.append(float(currLine[i]))

         if int(classifyVector(array(lineArr), trainWeights)) != int(currLine[21]):

             errorCount += 1

     errorRate = (float(errorCount) / numTestVec)

     print "the error rate of this test is: %f" % errorRate

     return errorRate

 def multiTest():

     numTests = 10; errorSum = 0.0

     for k in range(numTests):

         errorSum += colicTest()

     print "after %d iterations the average error rate is: %f" % (numTests, errorSum / float(numTests))

 if __name__=="__main__":

     multiTest()
三.Batch gradient descent、Stochastic gradient descent、Mini-batch gradient descent 的性能比较
1.Batch gradient descent
 def gradAscent(dataMatIn, classLabels):

     dataMatrix = mat(dataMatIn)  # convert to NumPy matrix

     labelMat = mat(classLabels).transpose()  # convert to NumPy matrix

     m, n = shape(dataMatrix)

     alpha = 0.001

     maxCycles = 500

     weights = ones((n, 1))

     for k in range(maxCycles):  # heavy on matrix operations

         h = sigmoid(dataMatrix * weights)  # matrix mult

         error = (labelMat - h)  # vector subtraction

         weights = weights + alpha * dataMatrix.transpose() * error  # matrix mult

     return weights
其运行结果:
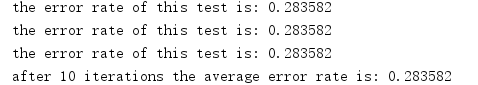
错误率为:28.4%
2.Stochastic gradient descent
 def stocGradAscent0(dataMatrix, classLabels,numIter=150):

     m, n = shape(dataMatrix)

     alpha = 0.01

     weights = ones(n)  # initialize to all ones

     for j in range(numIter):

         for i in range(m):

             h = sigmoid(sum(dataMatrix[i] * weights))

             error = classLabels[i] - h

             weights = weights + alpha * error * dataMatrix[i]

     return weights
迭代次数为150时,错误率为:46.3%
迭代次数为500时,错误率为:32.8%
迭代次数为800时,错误率为:38.8%
3.Mini-batch gradient descent
 def stocGradAscent1(dataMatrix, classLabels, numIter=150):

     m, n = shape(dataMatrix)

     weights = ones(n)  # initialize to all ones

     for j in range(numIter):

         dataIndex = range(m)

         for i in range(m):

             alpha = 4 / (1.0 + j + i) + 0.0001  # apha decreases with iteration, does not

             randIndex = int(random.uniform(0, len(dataIndex)))  # go to 0 because of the constant

             h = sigmoid(sum(dataMatrix[randIndex] * weights))

             error = classLabels[randIndex] - h

             weights = weights + alpha * error * dataMatrix[randIndex]

             del (dataIndex[randIndex])

     return weights
迭代次数为150时,错误率为:37.8%
迭代次数为500时,错误率为:35.2%
迭代次数为800时,错误率为:37.3%
4.综上:
1.在训练数据集较小且特征较少的时候,使用Batch gradient descent的效果是最好的。但如果不能满足这个条件,则可使用Mini-batch gradient descent,并设置合适的迭代次数。
2.对于Stochastic gradient descent 和 Mini-batch gradient descent 而言,并非迭代次数越多效果越好。不知为何?
《机器学习实战》学习笔记第五章 —— Logistic回归的更多相关文章
- Programming Entity Framework-dbContext 学习笔记第五章
### Programming Entity Framework-dbContext 学习笔记 第五章 将图表添加到Context中的方式及容易出现的错误 方法 结果 警告 Add Root 图标中的 ...
- [HeadFrist-HTMLCSS学习笔记]第五章认识媒体:给网页添加图像
[HeadFrist-HTMLCSS学习笔记]第五章认识媒体:给网页添加图像 干货 JPEG.PNG.GIF有何不同 JPEG适合连续色调图像,如照片:不支持透明度:不支持动画:有损格式 PNG适合单 ...
- 第五章 Logistic回归
第五章 Logistic回归 假设现在有一些数据点,我们利用一条直线对这些点进行拟合(该线称为最佳拟合直线),这个拟合过程就称作回归. 为了实现Logistic回归分类器,我们可以在每个特征上都乘以一 ...
- 《Spring实战》学习笔记-第五章:构建Spring web应用
之前一直在看<Spring实战>第三版,看到第五章时发现很多东西已经过时被废弃了,于是现在开始读<Spring实战>第四版了,章节安排与之前不同了,里面应用的应该是最新的技术. ...
- 【马克-to-win】学习笔记—— 第五章 异常Exception
第五章 异常Exception [学习笔记] [参考:JDK中文(类 Exception)] java.lang.Object java.lang.Throwable java.lang.Except ...
- 【机器学习实战学习笔记(2-2)】决策树python3.6实现及简单应用
文章目录 1.ID3及C4.5算法基础 1.1 计算香农熵 1.2 按照给定特征划分数据集 1.3 选择最优特征 1.4 多数表决实现 2.基于ID3.C4.5生成算法创建决策树 3.使用决策树进行分 ...
- 【机器学习实战学习笔记(1-1)】k-近邻算法原理及python实现
笔者本人是个初入机器学习的小白,主要是想把学习过程中的大概知识和自己的一些经验写下来跟大家分享,也可以加强自己的记忆,有不足的地方还望小伙伴们批评指正,点赞评论走起来~ 文章目录 1.k-近邻算法概述 ...
- opencv图像处理基础 (《OpenCV编程入门--毛星云》学习笔记一---五章)
#include <QCoreApplication> #include <opencv2/core/core.hpp> #include <opencv2/highgu ...
- 学习笔记 第五章 使用CSS美化网页文本
第五章 使用CSS美化网页文本 学习重点 定义字体类型.大小.颜色等字体样式: 设计文本样式,如对齐.行高.间距等: 能够灵活设计美观.实用的网页正文版式. 5.1 字体样式 5.1.1 定义字体 ...
随机推荐
- quick-cocos2d-x3.2 scheduler使用注意事项
近期在使用scheduler时发现例如以下问题 调用: local scheduler = require(cc.PACKAGE_NAME .. ".scheduler") fun ...
- 微软“小冰”识狗与人工神经网络(I)
2014年8月21日,微软"小冰"网络机器人推出了一项图像识别技能:"小冰识狗". "小冰"怎么会"识狗"呢? 依据微软 ...
- curl命令测试https
curl -vosa --resolve pic.test.net::222.241.7.179 https://pic.test.net/UploadFiles/201312031744347965 ...
- Android Developer:合并清单文件
使用Android Studio而且基于Gradle构建.每一个App能在多个位置包括清单文件,比如在src/main文件夹下productFlavor.库.Android ARchive(AAR) ...
- ubuntu环境 rake aborted!
错误: rake aborted! Gem::LoadError: You have already activated rake 10.3.2, but your Gemfile requires ...
- webpack 功能大全 【环境配置】
1. webpack简介 webpack 是一个模块打包工具.它使得模块相互依赖并且可构建等价于这些模块的静态资源.相比于已经存在的模块打包器(module bundler),webpack的开发动机 ...
- java多线程之happens-before
1.背景问题 在讲happens-before之前,先引入一个例子: 假定我们有已经被初始化的变量: int counter = 0; 这个 counter 变量被两个线程所共有,也就是说线程A和线程 ...
- ”非常危险“的Linux命令
Linux命令是一种很有趣且有用的东西,但在你不知道会带来什么后果的时候,它又会显得非常危险.所以,在输入某些命令前,请多多检查再敲回车. rm –rf rm –rf是删除文件夹和里面附带内容的一种最 ...
- 刷脸支付真的来啦!华为nova3带你玩转酷时代~
无论是不愿脱离手套的怕冷手. 或是沾满泥土芬芳的勤劳手. 还是挂着水滴的清洁手…… 每当这些时刻,打开支付宝认证支付, 指纹解锁的能力总是光彩尽失. 不过,就在华为nova 3的发布会上, 一项传说已 ...
- justify-content 定义子元素在父元素水平位置排列的顺序
justify-content 定义子元素在父元素水平位置排列的顺序,需要和display:flex使用才会生效. 有五个属性: 1.flex-start(默认值) 左对齐 2.flex-end 右 ...