
CVPR 2019 论文解读 | 小样本域适应的目标检测
引文
最近笔者也在寻找目标检测的其他方向,一般可以继续挖掘的方向是从目标检测的数据入手,困难样本的目标检测,如检测物体被遮挡,极小人脸检测,亦或者数据样本不足的算法。这里笔者介绍一篇小样本(few-shot)数据方向下的域适应(Domain Adaptation)的目标检测算法,这篇新加坡国立大学&华为诺亚方舟实验室的paper《Few-shot Adaptive Faster R-CNN》被收录于CVPR2019,解决的具体问题场景是我们有在普通常见场景下的汽车目标检测,我们只有少量雾天暴雨极劣天气环境下的汽车样本,那么我们可以使用成对采样(pairing-sampling)的方法,源域(source domain)即普通场景下的汽车样本\(Car_{s}\)和目标域(target domain)即恶劣天气下的汽车样本\(Car_{t}\)成对\((Car_s,Car_t)\)组成负样本,另一方面源域下成对组成正样本\((Car_s,Car_s)\),使用GAN的结构,判别器(discriminator)尽可能去分辨正负样本的不同,也就是分辨出源域和目标域的样本,生成器(generator)是尝试去迷惑判别器。这就是这个算法的主要思想,主要是把域适应的思想应用到了目标检测上。
论文源码还没完全开源,只找到了个官方的repo:https://github.com/twangnh/FAFRCNN
思考
在介绍文章具体网络设计和损失函数的设计之前,我们可以带着一个问题去思考。
- 用GAN的结构,数据样本使用\(Car_s\)作为正样本、\(Car_t\)作为负样本也可以使判别器(discriminator)分辨出源域和目标域的样本,为什么这里要组成对的去训练?
算法设计
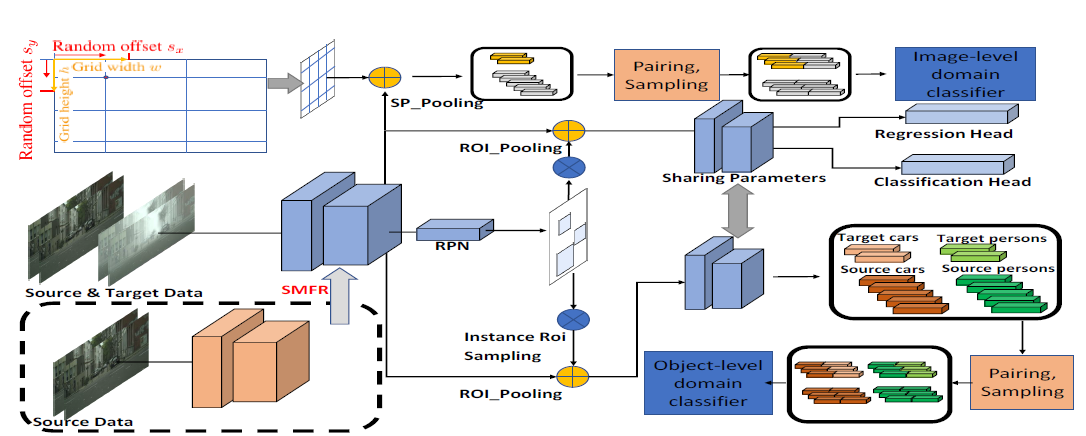
Fig 1. Few-shot Adaptive Faster R-CNN (FAFRCNN)的整体网络结构(其中的SMFR模块后面会介绍到)
在目标检测的任务中,论文作者把域适应问题分成**两个层次**:
- 图像级别的域适应
- 实例级别的域适应
具体可以看下面Fig2的第一行和第三行,图像级别下的域迁移是整体图像各个像素组成的域迁移,实例级别的域迁移是汽车样本下的域迁移。
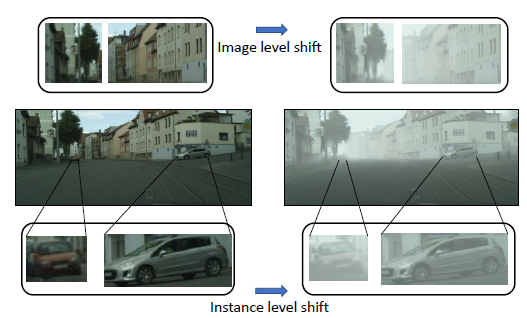
Fig 2. 中间为两张来自Cityspaces和Foggy Cityspaces的图片。第一行为图像级别的域迁移,第三行为实例级别的域迁移。
图像级别的域适应
图像级别的域适应(Image-level Adaptation) 是为了完成image-to-image的转换,论文提出了split pooling(SP)的方法,作用是为了随机放置grid,做法也是十分简单,grid cell的宽为w,高为h,然后随机生成sx和xy,grid根据sx和sy调整位置。
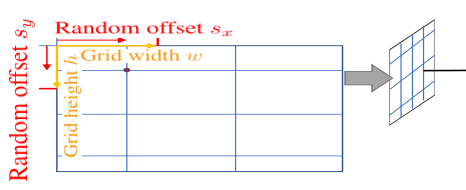
Fig 3. grid的选择
得到grid之后,论文把grid与Faster R-CNN中选取anchor boxes一样,采取了三种scale和三种ratio,split pooling对应在提取的特征$f(x)$中也是有大(l)、中(m)、小(s)三种scale: $sp_l(f(x)),sp_m(f(x)),sp_s(f(x))$。
后面就可以用对抗训练的方式训练生成器和判别器了,但是因为目标域的样本是小样本数据,所以这里提出了成对训练的方式,即源域对\(G_{s_1}={(g_s,g_s)}\)和源域-目标域对\(G_{s_2}={(g_s,g_t)}\)。判别器判断样本来源,生成器是特征提取器器目标是混淆判别器。
\]
\]
\]
另外论文在图像级别的域适应用了三个GAN,实用性不知道如何。
实例级别的域适应
跟Faster R-CNN中不同的是:foreground ROIs要求更高的IOU阈值(比如原本IOU要求是0.5的,现在可能要0.7)。获得了ROI特征之后会根据ROI的label分组,源域目标特征是\(O_{is}\),目标域目标特征为\(O_{it}\),如果一共有C类,\(i\in[0,C]\),第0类为背景,其实跟图像级别的成对方式一样,源域对\(N_{i1}=\{(n_{is},n_{is})\}\)和源域目标域对\(N_{i2}=\{(n_{is},n_{it})\}\),其中\(n_{is}\sim O_{is},n_{it}\sim O_{it}\),以下为域判别器的损失函数:
\]
以下为feature generator的损失函数:
\]
源域模型特征正则化
这个部分就是Fig 1中的SMFR模块,全称为Source Model Feature Regularization,他的作用是正则化源域模型,具体来说,就是源域样本\(x_s\)经过论文的域适应adaptation之后的特征提取器\(f_t\)和初始时拥有的仅有源域样本训练的特征提取器\(f_s\)要尽可能的一致,这样才能使模型更加鲁棒,文章用了L2正则。
\]
但是因为是目标检测模型,我们更关注的是图片的前景目标本身,所以我们要求的是源域样本\(x_s\)经过特征提取器之后的前景部分变化不大。
\]
其中\(M\)为前景的mask,k为正例掩码位置的个数。
实验结果
实验中数据集采用以下5种:
- Scenario-1: SIM10K to Udacity (\(S\rightarrow U\));
- Scenario-2: SIM10K to Cityscapes (\(S\rightarrow C\));
- Scenario-3: Cityscapes to Udacity (\(C\rightarrow U\));
- Scenario-4: Udacity to Cityscapes (\(U\rightarrow C\));
- Scenario-5: Cityscapes to Foggy Cityscapes (\(C\rightarrow F\)).
以下都是采用AP作为对比评价指标。
 |
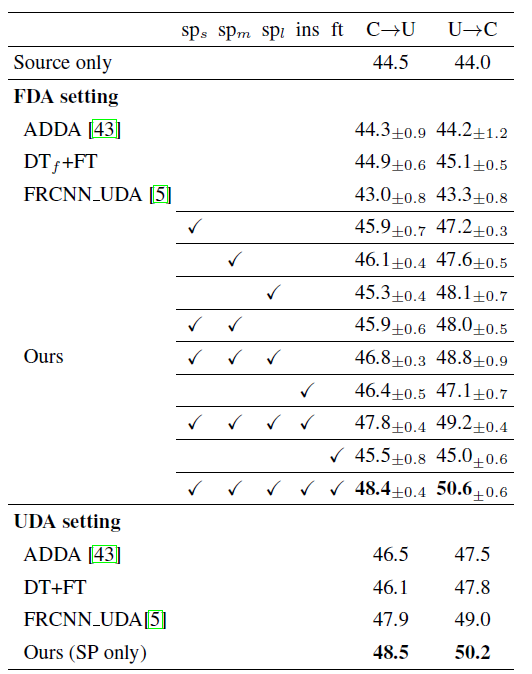 |
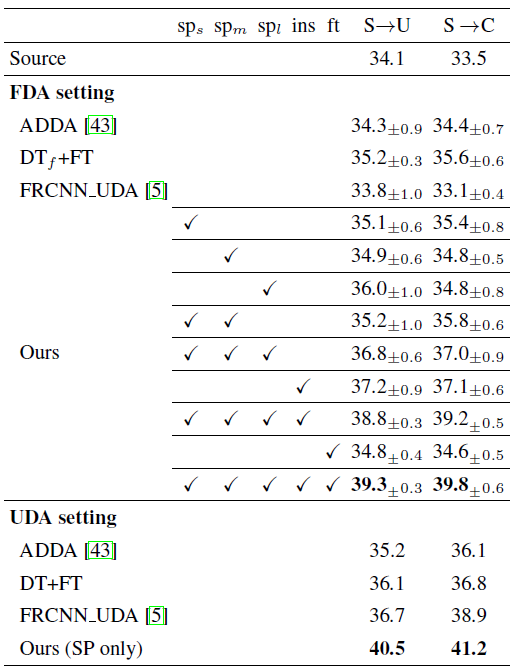
Fig 4. 左边是SP技术在Scenario-1和Scenario-2的效果。右边是SP技术在Scenario-3和Scenario-4的效果。sp表示的是split pooling,ins表示加入实例级别的域适应,ft表示加入fine-tunning loss。
可以看出,在加入SP技术之后AP得到明显的提高,比**ADDA [1]**高了5个点。
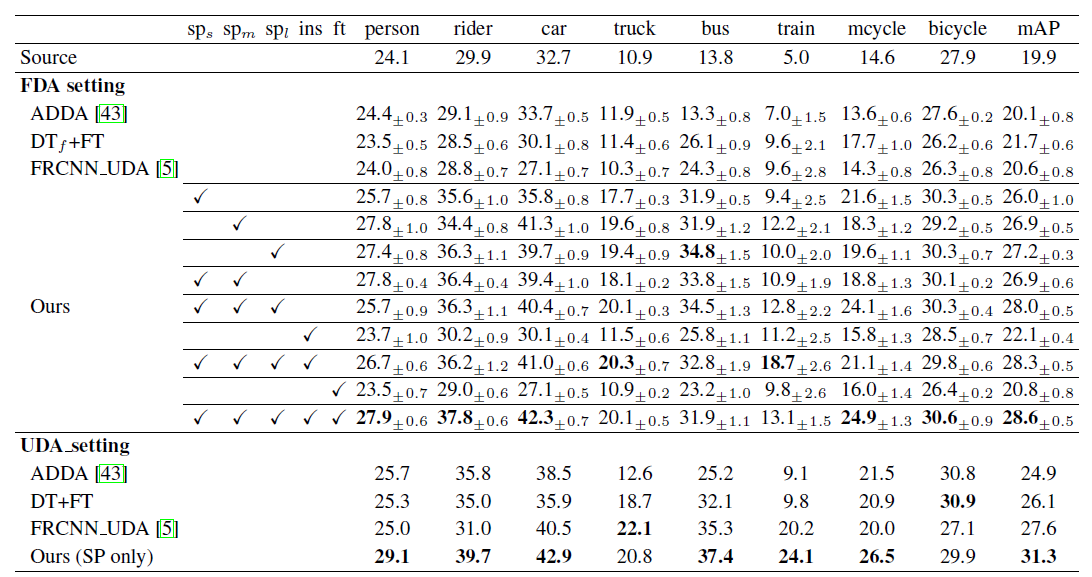
Fig 5. 论文提出的方法在Scenario-5中的各个实例的AP指标对比
从UDA_setting中看到其实并不是全部都能取到最优成绩。
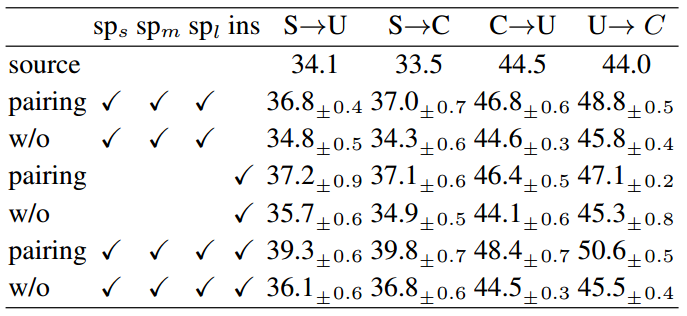
Fig 6. 引入pairing理论的效果
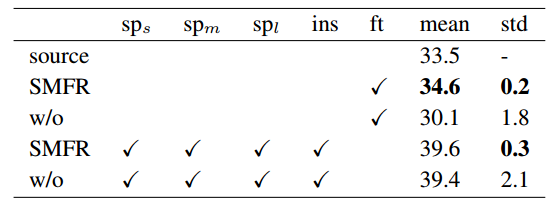
Fig 7. SMFR的效果
总结思考
回答文首的问题,相信很多读者读完全文之后肯定也知道答案了,paper题目就是基于小样本学习方向的,其实需要成对训练的目的就是增加训练样本,如果源域样本\(Car_s\)有n个,目标域样本\(Car_t\)有m个(n>m),那么最后负样本的个数仅仅只有m个,因为是小样本,训练出来的效果也会十分的差。但是如果成对训练(pairing-sampling),正样本为\((Car_s,Car_s)\),理论上样本数量为\(n^2\),为s负样本为\((Car_s,Car_t)\),理论上样本数量为\(n*m\),虽然经过这样笛卡尔积之后的正负样本比没有变,但是负样本数量却是增多了。这也是整篇文章的主要思想,pairing-sampling的去训练。
参考文献
- [1]. Eric Tzeng, Judy Hoffman, Kate Saenko, and Trevor Darrell. Adversarial discriminative domain adaptation. In Computer Vision and Pattern Recognition (CVPR), volume 1, page 4, 2017.
CVPR 2019 论文解读 | 小样本域适应的目标检测的更多相关文章
- CVPR 2019|PoolNet:基于池化技术的显著性检测 论文解读
作者 | 文永亮 研究方向 | 目标检测.GAN 研究动机 这是一篇发表于CVPR2019的关于显著性目标检测的paper,在U型结构的特征网络中,高层富含语义特征捕获的位置信息在自底向上的传播过 ...
- 医学AI论文解读 |Circulation|2018| 超声心动图的全自动检测在临床上的应用
文章来自微信公众号:机器学习炼丹术.号主炼丹兄WX:cyx645016617.文章有问题或者想交流的话欢迎- 参考目录: @ 目录 0 论文 1 概述 2 pipeline 3 技术细节 3.1 预处 ...
- CVPR 2019 行人检测新思路:
CVPR 2019 行人检测新思路:高级语义特征检测取得精度新突破 原创: CV君 我爱计算机视觉 今天 点击我爱计算机视觉置顶或标星,更快获取CVML新技术 今天跟大家分享一篇昨天新出的CVPR 2 ...
- 经典论文系列 | 目标检测--CornerNet & 又名 anchor boxes的缺陷
前言: 目标检测的预测框经过了滑动窗口.selective search.RPN.anchor based等一系列生成方法的发展,到18年开始,开始流行anchor free系列,CornerNe ...
- 腾讯推出超强少样本目标检测算法,公开千类少样本检测训练集FSOD | CVPR 2020
论文提出了新的少样本目标检测算法,创新点包括Attention-RPN.多关系检测器以及对比训练策略,另外还构建了包含1000类的少样本检测数据集FSOD,在FSOD上训练得到的论文模型能够直接迁移到 ...
- 增量学习不只有finetune,三星AI提出增量式少样本目标检测算法ONCE | CVPR 2020
论文提出增量式少样本目标检测算法ONCE,与主流的少样本目标检测算法不太一样,目前很多性能高的方法大都基于比对的方式进行有目标的检测,并且需要大量的数据进行模型训练再应用到新类中,要检测所有的类别则需 ...
- 【论文解读】行人检测:What Can Help Pedestrian Detection?(CVPR'17)
前言 本篇文章出自CVPR2017,四名作者为Tsinghua University,Peking University, 外加两名来自Megvii(旷视科技)的大佬. 文章中对能够帮助行人检测的ex ...
- Object Detection · RCNN论文解读
转载请注明作者:梦里茶 Object Detection,顾名思义就是从图像中检测出目标对象,具体而言是找到对象的位置,常见的数据集是PASCAL VOC系列.2010年-2012年,Object D ...
- CVPR2020论文解读:CNN合成的图片鉴别
CVPR2020论文解读:CNN合成的图片鉴别 <CNN-generated images are surprisingly easy to spot... for now> 论文链接:h ...
随机推荐
- PHP学习—了解篇
了解PHP 了解神器:PhpStudy 一键搭建PHP环境 语法: PHP是一种可以嵌套在HTML页面的脚本语言 嵌套HTML文件: <!DOCTYPE html> <html& ...
- Maximum Product UVA - 11059
Given a sequence of integers S = {S1, S2, . . . , Sn}, you should determine what is the value of the ...
- 271.已正确安装证书,但https显示连接不安全(此页面的部分内容不安全)
1.问题描述 成功安装证书,但是显示连接不安全 此页面的部分内容(例如图像)不安全 如下图 2.问题原因 页面引用(含有)http资源的文件.图片.脚本 如:图片引自其他http资源的网站 我的是引自 ...
- Erlang模块erl翻译
命令: erl 概述: Erlang模拟器 描述: erl程序启动一个Erlang运行时系统.准确的信息是依赖于系统的(举例,erl是否是脚本或程序,其它程序调用). ...
- Go语言基础之单元测试
不写测试的开发不是好程序员.我个人非常崇尚TDD(Test Driven Development)的,然而可惜的是国内的程序员都不太关注测试这一部分. 这篇文章主要介绍下在Go语言中如何做单元测试和基 ...
- Map四种获取key和value值的方法,以及对map中的元素排序(转)
获取map的值主要有四种方法,这四种方法又分为两类,一类是调用map.keySet()方法来获取key和value的值,另一类则是通过map.entrySet()方法来取值,两者的区别在于,前者主要是 ...
- eclipse中离线安装activit插件
离线安装activiti教程: 1.先下载压缩包和jar包 链接:https://pan.baidu.com/s/1hSToZt_4A262rUxc8KToCw 密码:j5r1 2.将下载好的jars ...
- Spring boot 集成 Druid 数据源
Druid是阿里开源的一个JDBC应用组件,其中包括三部分: DruidDriver:代理Driver,能够提供基于Filter-Chain模式的插件体系. DruidDataSource:高效可管理 ...
- zookeeper学习(一)_简介
上篇文章 我们已经安装上了zookeeper,也简单的体验了一把,但是如果让你给别人介绍下zookeeper,可能也是说不出来.本篇文章就参考了网上各位优秀博主的文章,整理出自己更能理解的内容 优秀博 ...
- kubernetes部署高可用Harbor
前言 本文Harbor高可用依照Harbor官网部署,主要思路如下,大家可以根据具体情况选择搭建. 部署Postgresql高可用集群.(本文选用Stolon进行管理,请查看文章<kuberne ...