
Nvidia Tensor Core初探
1 背景
2 硬件单元
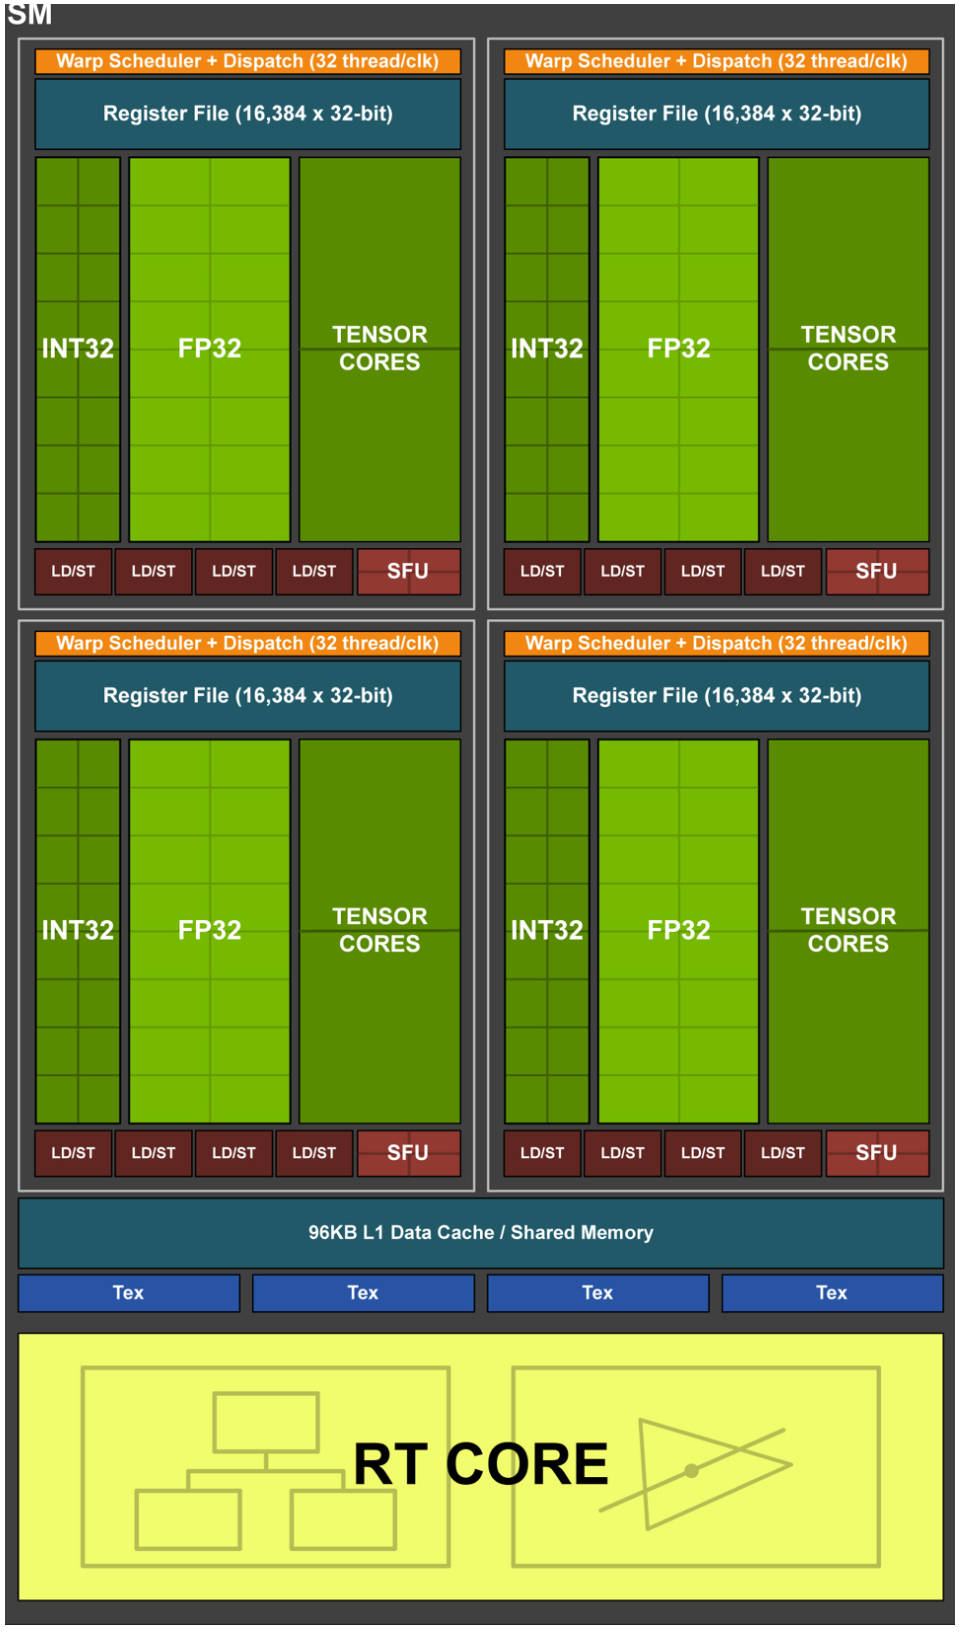
3 架构
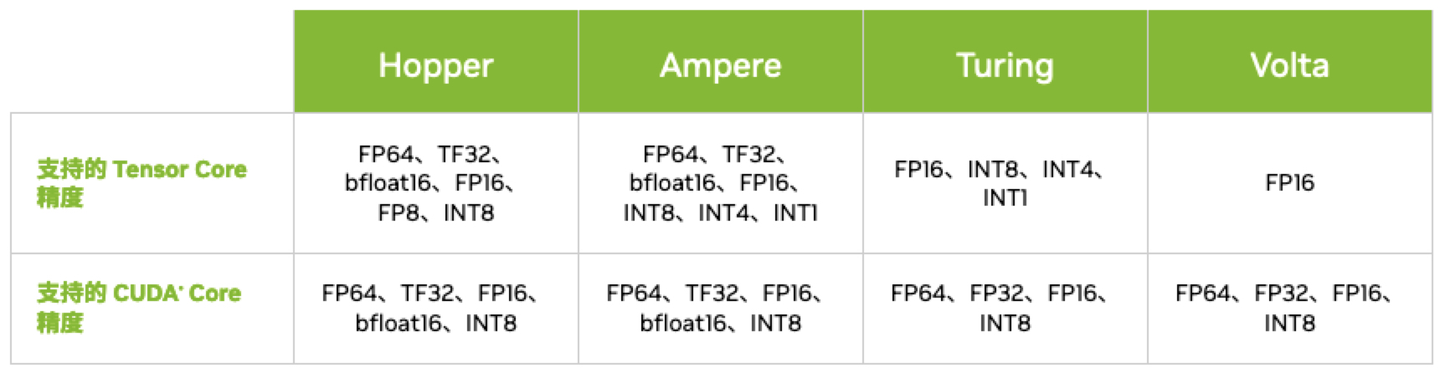
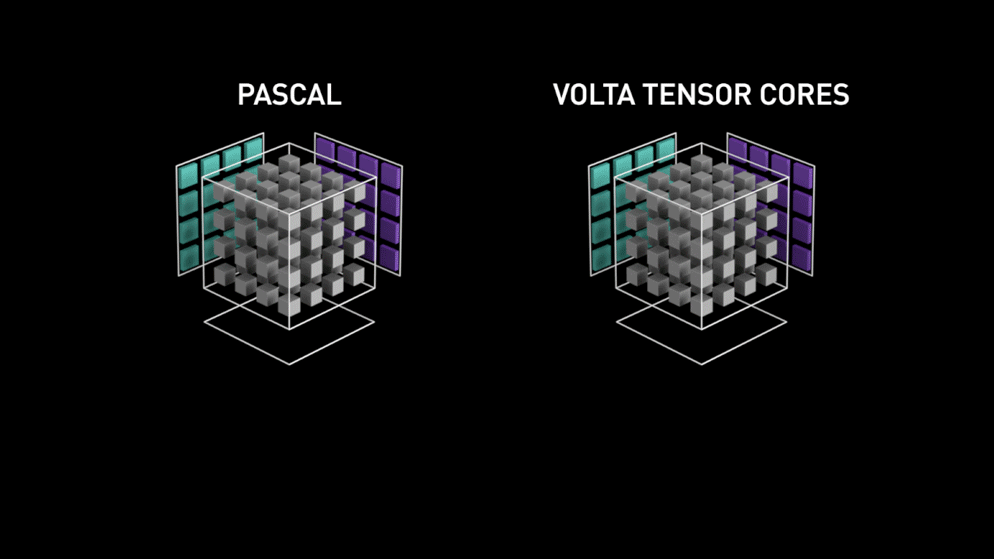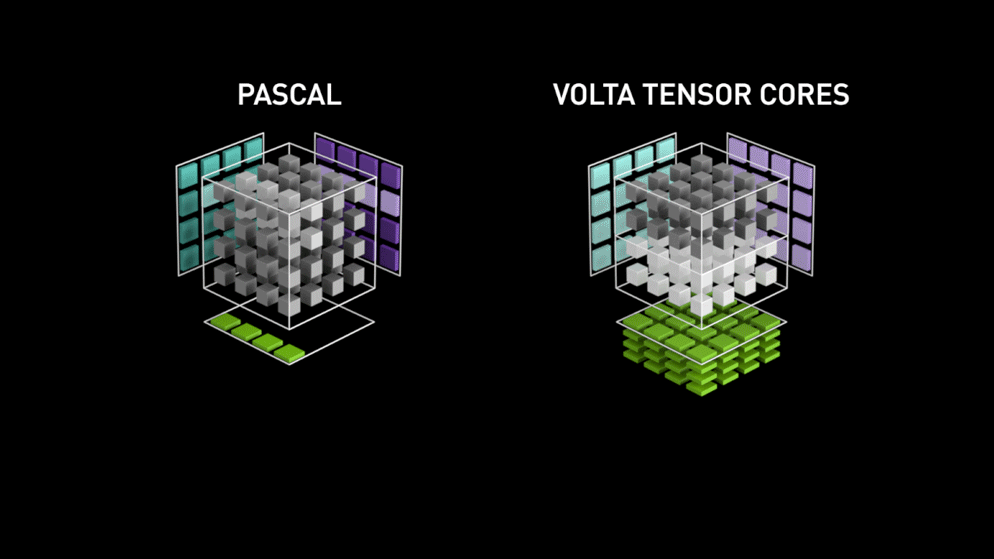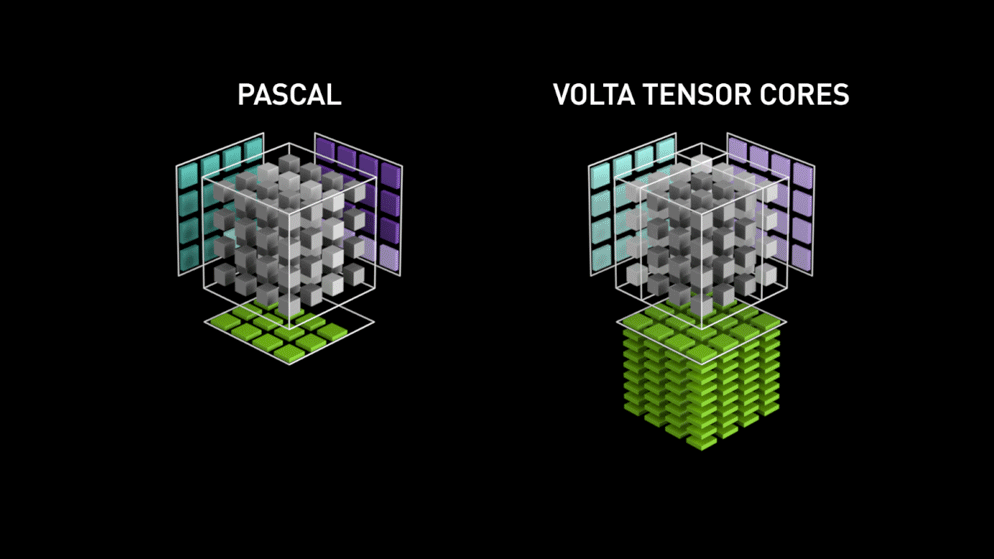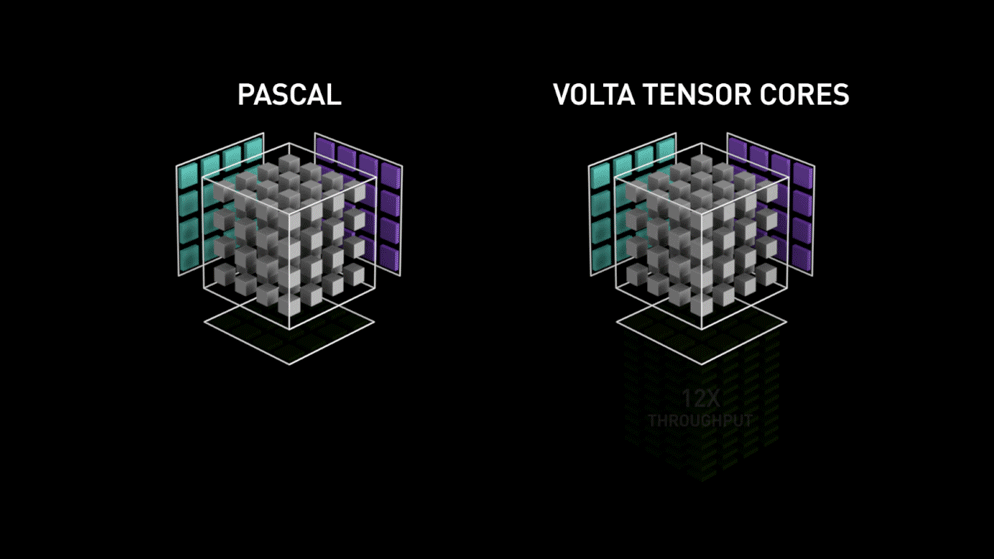
3.1 Volta Tensor Core
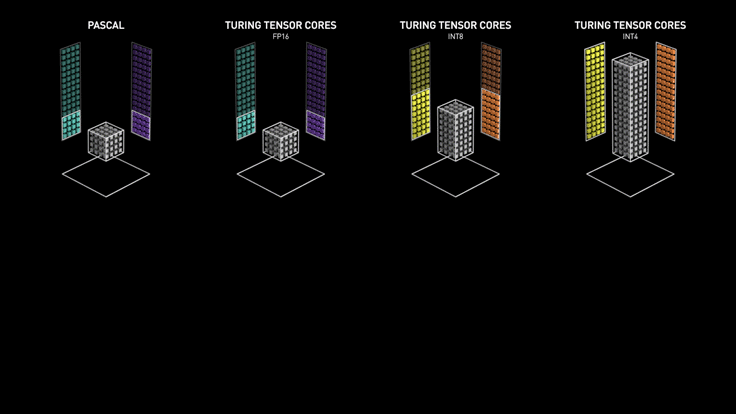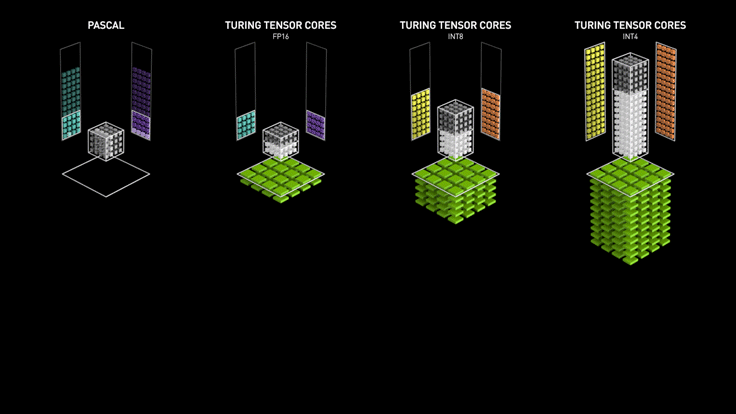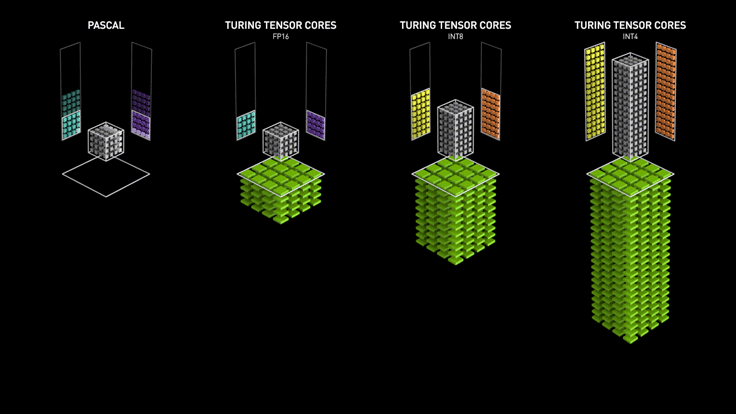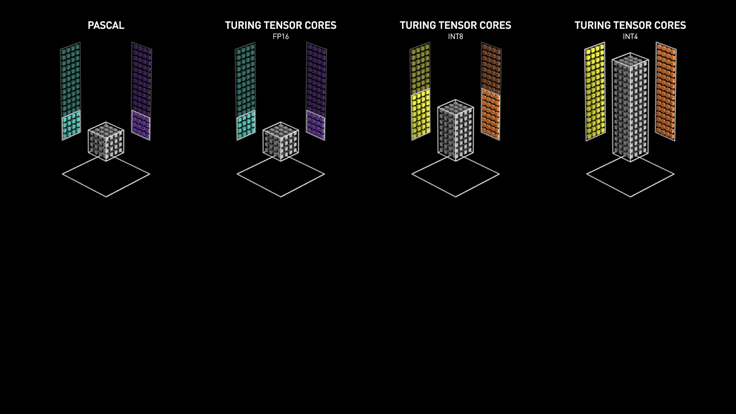
3.2 Turing Tensor Core
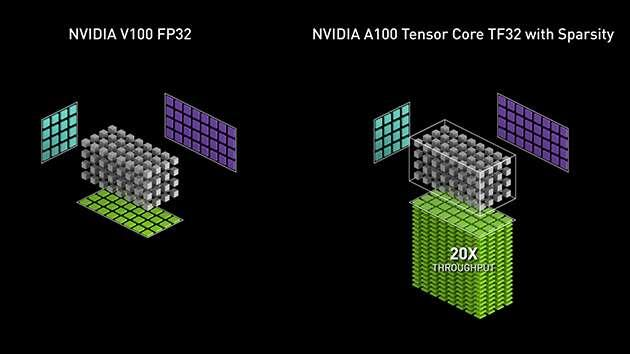
3.3 Ampere Tensor Core
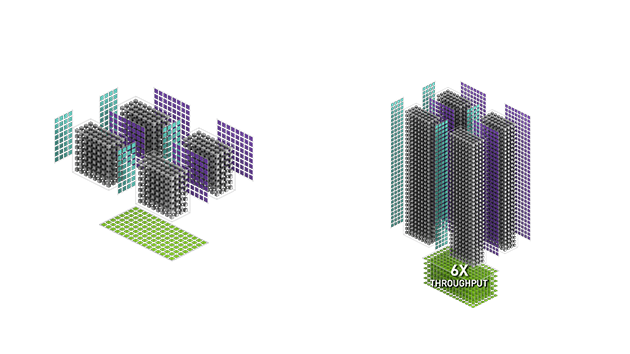
3.4 Hopper Tensor Core
4 调用
4.1 WMMA (Warp-level Matrix Multiply Accumulate) API
template<typename Use, int m, int n, int k, typename T, typename Layout=void> class fragment;

void load_matrix_sync(fragment<...> &a, const T* mptr, unsigned ldm);

void load_matrix_sync(fragment<...> &a, const T* mptr, unsigned ldm, layout_t layout);

void store_matrix_sync(T* mptr, const fragment<...> &a, unsigned ldm, layout_t layout);

void fill_fragment(fragment<...> &a, const T& v);

void mma_sync(fragment<...> &d, const fragment<...> &a, const fragment<...> &b, const fragment<...> &c, bool satf=false);
- fragment:Tensor Core数据存储类,支持matrix_a、matrix_b和accumulator
- load_matrix_sync:Tensor Core数据加载API,支持将矩阵数据从global memory或shared memory加载到fragment
- store_matrix_sync:Tensor Core结果存储API,支持将计算结果从fragment存储到global memory或shared memory
- fill_fragment:fragment填充API,支持常数值填充
- mma_sync:Tensor Core矩阵乘计算API,支持D = AB + C或者C = AB + C
4.2 WMMA PTX (Parallel Thread Execution)
wmma.load.a.sync.aligned.layout.shape{.ss}.atype r, [p] {, stride};

wmma.load.b.sync.aligned.layout.shape{.ss}.btype r, [p] {, stride};

wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride};

wmma.store.d.sync.aligned.layout.shape{.ss}.type [p], r {, stride};

wmma.mma.sync.aligned.alayout.blayout.shape.dtype.ctype d, a, b, c;
- wmma.load:Tensor Core数据加载指令,支持将矩阵数据从global memory或shared memory加载到Tensor Core寄存器
- wmma.store:Tensor Core结果存储指令,支持将计算结果从Tensor Core寄存器存储到global memory或shared memory
- wmma.mma:Tensor Core矩阵乘计算指令,支持D = AB + C或者C = AB + C
4.3 MMA (Matrix Multiply Accumulate) PTX
ldmatrix.sync.aligned.shape.num{.trans}{.ss}.type r, [p];

mma.sync.aligned.m8n8k4.alayout.blayout.dtype.f16.f16.ctype  d, a, b, c;

mma.sync.aligned.m16n8k8.row.col.dtype.f16.f16.ctype  d, a, b, c;

mma.sync.aligned.m16n8k16.row.col.dtype.f16.f16.ctype d, a, b, c;
- ldmatrix:Tensor Core数据加载指令,支持将矩阵数据从shared memory加载到Tensor Core寄存器
- mma:Tensor Core矩阵乘计算指令,支持D = AB + C或者C = AB + C
4.4 SASS
Nvidia Tensor Core初探的更多相关文章
- NVIDIA Tensor Cores解析
NVIDIA Tensor Cores解析 高性能计算机和人工智能前所未有的加速 Tensor Cores支持混合精度计算,动态调整计算以加快吞吐量,同时保持精度.最新一代将这些加速功能扩展到各种工作 ...
- NVIDIA深度学习Tensor Core性能解析(下)
NVIDIA深度学习Tensor Core性能解析(下) DeepBench推理测试之RNN和Sparse GEMM DeepBench的最后一项推理测试是RNN和Sparse GEMM,虽然测试中可 ...
- NVIDIA深度学习Tensor Core性能解析(上)
NVIDIA深度学习Tensor Core性能解析(上) 本篇将通过多项测试来考验Volta架构,利用各种深度学习框架来了解Tensor Core的性能. 很多时候,深度学习这样的新领域会让人难以理解 ...
- Tensor Core技术解析(下)
Tensor Core技术解析(下) 让FP16适用于深度学习 Volta的深度学习能力是建立在利用半精度浮点(IEEE-754 FP16)而非单精度浮点(FP32)进行深度学习训练的基础之上. 该能 ...
- Tensor Core技术解析(上)
Tensor Core技术解析(上) NVIDIA在SIGGRAPH 2018上正式发布了新一代GPU架构--Turing(图灵),黄仁勋称Turing架构是自2006年CUDA GPU发明以来最大的 ...
- 用NVIDIA Tensor Cores和TensorFlow 2加速医学图像分割
用NVIDIA Tensor Cores和TensorFlow 2加速医学图像分割 Accelerating Medical Image Segmentation with NVIDIA Tensor ...
- Asp.net Core 初探(发布和部署Linux)
前言 俗话说三天不学习,赶不上刘少奇.Asp.net Core更新这么长时间一直观望,周末帝都小雨,宅在家看了下Core Web App,顺便搭建了个HelloWorld环境来尝尝鲜,第一次看到.Ne ...
- jenkins部署net core初探
一步一步,小心翼翼吖.看了好几个博客,摸索了两天了,才搭建成功,不容易,先写篇文章记下来,hhhhhhhhhhhh 相关环境配置 服务器:centos7 源代码管理器:git 技术选型:net cor ...
- ASPNET CORE初探
ASP.NET Core 开发-中间件(Middleware) ASP.NET Core开发,开发并使用中间件(Middleware). 中间件是被组装成一个应用程序管道来处理请求和响应的软件组件 ...
- linux环境上运行.net core 初探
1.安装 .net core 环境 rpm --import https://packages.microsoft.com/keys/microsoft.ascsh -c 'echo -e " ...
随机推荐
- 【C++小程序】《我要抽签》b1.0做好了~
也许是的,得横空出世了 如你所见 这款基于\(C++\)能模仿Mrs. Yao抽签系统的cpp终于做完了啦~ 初期功能很少.\(BUG\)极多. 所以为了您的体验:) 请遵守格式 代码: #inclu ...
- 20181224《网络攻防技术》Exp7 网络欺诈防范
20181224<网络攻防技术>Exp7 网络欺诈防范 目录 20181224<网络攻防技术>Exp7 网络欺诈防范 相关知识点总结 ARP Spoofing IP源地址欺骗 ...
- Java的由来
Java 发展史 1.1.起源 20 世纪 90 年代,单片式计算机系统诞生,单片式计算机系统不仅廉价,而且功能强大,使用它 可以大幅度提升消费性电子产品的智能化程度. SUN 公司为了抢占市场先机, ...
- FCC 高级算法题 库存更新
Inventory Update 依照一个存着新进货物的二维数组,更新存着现有库存(在 arr1 中)的二维数组. 如果货物已存在则更新数量 . 如果没有对应货物则把其加入到数组中,更新最新的数量. ...
- element的el-table使用模板插槽在火狐和IE无法显示tooltip(浏览器兼容)
el-table中使用show-overflow-tooltip属性,配合tooltip出现的浏览器兼容性问题 el-table中使用show-overflow-tooltip属性内容过长被隐藏时显示 ...
- 7、jmeter配置元件-HTTP信息头配置元件
根据对方服务器的要求来配置消息头 (重点)Gzip:发送给你压缩包 提高速度 性能等等 同样的数据 只要页面没有变更 就不会重新压缩 节省带宽
- 【BFS】算法模板与思路
1.BFS算法的基础理论是什么? BFS算法名叫宽度优先搜索,虽然我能理解深度优先搜索,但我却不是很能理解宽度优先搜索. 一个很关键的点在于:宽度优先搜索是一个迭代的算法,不是递归的算法. 与DFS之 ...
- python学习记录(五)-文件操作
open()参数说明 ''' 参数1:路径 ./当前目录 ../上一级目录 参数2: 基础模式:w r x a w:写入,不存在则创建,存在则打开,清空文件内容,光标指向最前面 r:只读,不存在则报错 ...
- 2.javaweb-begin
1.回顾前端知识 1.CSS 1) CSS的角色:页面显示的美观风格 2) CSS的基础语法:标签样式:类样式:ID样式:组合样式:嵌入式样式表:内部样式表:外部样式表 3) 盒子模型:border. ...
- jenkins脚本
1.统计代码 pipeline { agent any parameters { choice( description: '你需要选择当前哪个分支进行统计 ?', name: 'branchNow' ...