
Hive笔记之Fetch Task
在使用Hive的时候,有时候只是想取表中某个分区的前几条的记录看下数据格式,比如一个很常用的查询:
select * from foo where partition_column=bar limit 10;
这种对数据基本没什么要求,随便来点就行,既然如此为什么不直接读取本地存储的数据作为结果集呢。
Hive命令都要转换为MapReduce任务去执行,但是因为启动MapReduce需要消耗资源,然后速度还很慢(相比较于直接从本地文件中读取而言),所以Hive对于查询做了优化,对于某些查询可以不启动MapReduce任务的就尽量不去启动MapReduce任务,而是直接从本地文件读取。
个人理解: fetch task = 不启动MapReduce,直接读取本地文件输出结果。
在hive-site.xml中有三个fetch task相关的值:
hive.fetch.task.conversion
hive.fetch.task.conversion.threshold
hive.fetch.task.aggr
hive.fetch.task.conversion
这个属性有三个可选的值:
none:关闭fetch task优化
minimal:只在select *、使用分区列过滤、带有limit的语句上进行优化
more:在minimal的基础上更加强大了,select不仅仅可以是*,还可以单独选择几列,并且filter也不再局限于分区字段,同时支持虚拟列(别名)
<property>

  <name>hive.fetch.task.conversion</name>

  <value>more</value>

  <description>

    Expects one of [none, minimal, more].

    Some select queries can be converted to single FETCH task minimizing latency.

    Currently the query should be single sourced not having any subquery and should not have

    any aggregations or distincts (which incurs RS), lateral views and joins.

    0. none : disable hive.fetch.task.conversion

    1. minimal : SELECT STAR, FILTER on partition columns, LIMIT only

    2. more    : SELECT, FILTER, LIMIT only (support TABLESAMPLE and virtual columns)

  </description>

</property>
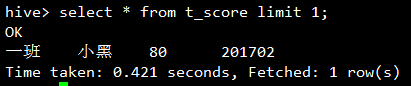
对于查询所有列的情况,会使用fetch task:
如果是查询部分列呢?
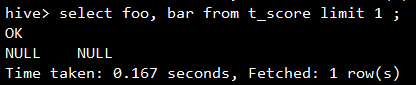
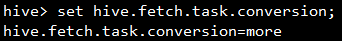
为什么查询部分列也使用了Fetch Task?查看一下当前的set hive.fetch.task.conversion的值:
尝试将hive.fetch.task.conversion设置为none,再查询:
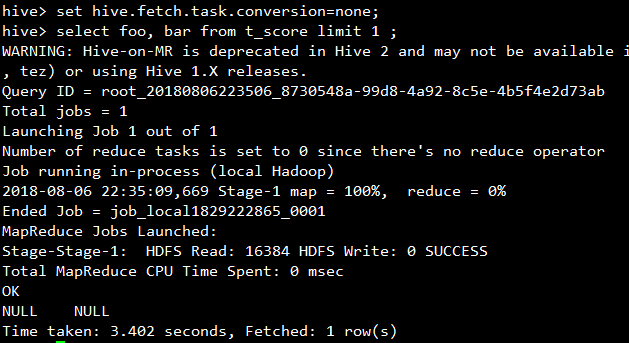
启动了MapReduce任务。
hive.fetch.task.conversion.threshold
在输入大小为多少以内的时候fetch task生效,默认1073741824 byte = 1G。
<property>

  <name>hive.fetch.task.conversion.threshold</name>

  <value>1073741824</value>

  <description>

    Input threshold for applying hive.fetch.task.conversion. If target table is native, input length

    is calculated by summation of file lengths. If it's not native, storage handler for the table

    can optionally implement org.apache.hadoop.hive.ql.metadata.InputEstimator interface.

  </description>

</property>
hive.fetch.task.aggr
对于没有group by的聚合查询,比如select count(*) from src,这种最终都会在一个reduce中执行,像这种查询,可以把这个置为true将将其转换为fetch task,这可能会节约一些时间。
<property>

  <name>hive.fetch.task.aggr</name>

  <value>false</value>

  <description>

    Aggregation queries with no group-by clause (for example, select count(*) from src) execute

    final aggregations in single reduce task. If this is set true, Hive delegates final aggregation

    stage to fetch task, possibly decreasing the query time.

  </description>

</property>
.
Hive笔记之Fetch Task的更多相关文章
- [转]Hive:简单查询不启用Mapreduce job而启用Fetch task
转自:http://www.iteblog.com/archives/831 如果你想查询某个表的某一列,Hive默认是会启用MapReduce Job来完成这个任务,如下: hive> SEL ...
- Hive基础(3)---Fetch Task(转)
我们在执行hive代码的时候,一条简单的命令大部分都会转换成为mr代码在后台执行,但是有时候我们仅仅只是想获取一部分数据而已,仅仅是获取数据,还需要转化成为mr去执行吗?那个也太浪费时间和内存啦,所以 ...
- Hive快捷查询:不启用Mapreduce job启用Fetch task三种方式介绍
如果查询表的某一列,Hive中默认会启用MapReduce job来完成这个任务,如下: hive>select id,name from m limit 10;--执行时hive会启用MapR ...
- Hive快捷查询:不启用Mapreduce job启用Fetch task
启用MapReduce Job是会消耗系统开销的.对于这个问题,从Hive0.10.0版本开始,对于简单的不需要聚合的类似SELECT <col> from <table> L ...
- 011-HQL中级1-Hive快捷查询:不启用Mapreduce job启用Fetch task三种方式介绍
如果你想查询某个表的某一列,Hive默认是会启用MapReduce Job来完成这个任务,如下: hive; Total MapReduce jobs Launching Job out since ...
- Hive笔记——技术点汇总
目录 · 概况 · 手工安装 · 引言 · 创建HDFS目录 · 创建元数据库 · 配置文件 · 测试 · 原理 · 架构 · 与关系型数据库对比 · API · WordCount · 命令 · 数 ...
- Hive笔记--sql语法详解及JavaAPI
Hive SQL 语法详解:http://blog.csdn.net/hguisu/article/details/7256833Hive SQL 学习笔记(常用):http://blog.sina. ...
- 【Hive】Hive笔记:Hive调优总结——数据倾斜,join表连接优化
数据倾斜即为数据在节点上分布不均,是常见的优化过程中常见的需要解决的问题.常见的Hive调优的方法:列剪裁.Map Join操作. Group By操作.合并小文件. 一.表现 1.任务进度长度为99 ...
- Hive 笔记
DESCRIBE EXTENDED mydb.employees DESCRIBE EXTENDED mydb.employees DESCRIBE EXTENDED mydb.employees ...
随机推荐
- 甲题题解-1116. Come on! Let’s C (20)-(素数筛选法)
用vis标记出现过的id,checked标记询问过的id.至于如何判断排名为素数,用素数筛选法预处理一下即可,水题. #include <iostream> #include <cs ...
- msgpack生成lib,vs新建lib等
记录导师交给的任务 新建一个c++项目,运行老师的msgpack的cpp文件,然后会生成相应的lib,我做的东西需要调用到它(这是老师改写后的msgpack的lib) 我的任务是建一个静态库,将客户端 ...
- PAT 甲级 1096 Consecutive Factors
https://pintia.cn/problem-sets/994805342720868352/problems/994805370650738688 Among all the factors ...
- Mybatis 从入门到精通一:mybatis的入门
1.Mybatis简介 MyBatis 本是apache的一个开源项目iBatis, 2010年这个项目由apache software foundation(阿帕奇软件基金会) 迁移到了google ...
- 群里提到的IE设置问题 ---B/S 下页面刷新问题
这里面四个选项的含义 下面是每个选项的作用和意义: 1. “每次访问此页时检查”选项表示浏览器每次访问一个页面时,不管浏览器是否缓存过此页面,都要向服务器发出访问请求.这种设置的优点是实时性很强,肯定 ...
- FuelPHP 系列(三) ------ Model 模型
框架封装好的 model 类有几个,按需继承就好. 有:/fuel/core/classes/model/crud.php /fuel/packages/orm/classes/model.php / ...
- [你必须知道的异步编程]C# 5.0 新特性——Async和Await使异步编程更简单
本专题概要: 引言 同步代码存在的问题 传统的异步编程改善程序的响应 C# 5.0 提供的async和await使异步编程更简单 async和await关键字剖析 小结 一.引言 在之前的C#基础知 ...
- BZOJ 3174 拯救小矮人(贪心+DP)
题意 一群小矮人掉进了一个很深的陷阱里,由于太矮爬不上来,于是他们决定搭一个人梯.即:一个小矮人站在另一小矮人的 肩膀上,知道最顶端的小矮人伸直胳膊可以碰到陷阱口.对于每一个小矮人,我们知道他从脚到肩 ...
- 【大数据】SparkCore学习笔记
第1章 RDD概述 1.1 什么是RDD RDD(Resilient Distributed Dataset)叫做分布式数据集,是Spark中最基本的数据抽象.代码中是一个抽象类,它代表一个不可变.可 ...
- Linux_MySql_tar_安装(转)
系统版本:CentOs 7.* Mysql版本:5.7.17(自己测试版本) 根据博主[大大的橙子]博文转载记录(大部分照搬了,只修改少许部分) 一.基本环境部署 #卸载系统自带的Mariadb [r ...