
deeplearning.ai课程学习(3)
第三周:浅层神经网络(Shallow neural networks)
1、激活函数(Activation functions)
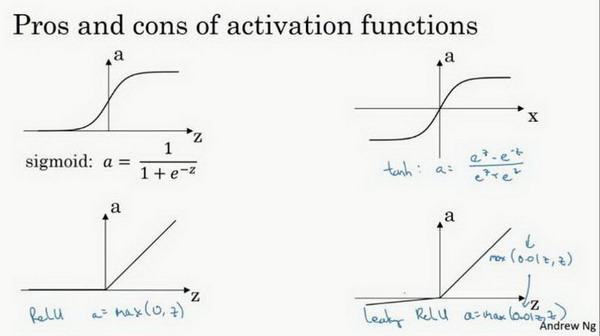
sigmoid函数和tanh函数两者共同的缺点是,在z特别大或者特别小的情况下,导数的梯度或者函数的斜率会变得特别小,最后就会接近于0,导致降低梯度下降的速度。
Relu和Leaky ReLu相对于Sigmoid和tanh函数的优点如下:
第一,在的区间变动很大的情况下,激活函数的导数或者激活函数的斜率都会远大于0,在程序实现就是一个if-else语句,而sigmoid函数需要进行浮点四则运算,在实践中,使用ReLu激活函数神经网络通常会比使用sigmoid或者tanh激活函数学习的更快。
第二,sigmoid和tanh函数的导数在正负饱和区的梯度都会接近于0,这会造成梯度弥散,而Relu和Leaky ReLu函数大于0部分都为常熟,不会产生梯度弥散现象。(同时应该注意到的是,Relu进入负半区的时候,梯度为0,神经元此时不会训练,产生所谓的稀疏性,而Leaky ReLu不会有这问题)
不同激活函数的过程和结论:
sigmoid激活函数:除了输出层是一个二分类问题基本不会用它。
tanh激活函数:tanh是非常优秀的,几乎适合所有场合。
ReLu激活函数:最常用的默认函数,如果不确定用哪个激活函数,就使用ReLu或者Leaky ReLu。
总结:如果不确定哪一个激活函数效果更好,可以把它们都试试,然后在验证集或者发展集上进行评价。
2、为什么需要非线性激活函数?(why need a nonlinear activation function?)
如果使用线性激活函数或者没有使用一个激活函数,那么无论你的神经网络有多少层一直在做的只是计算线性函数,所以不如直接去掉全部隐藏层。
3、随机初始化(Random+Initialization)
对于逻辑回归,把权重初始化为0当然也是可以的。但是对于一个神经网络,如果把权重或者参数都初始化为0,那么梯度下降将不会起作用。
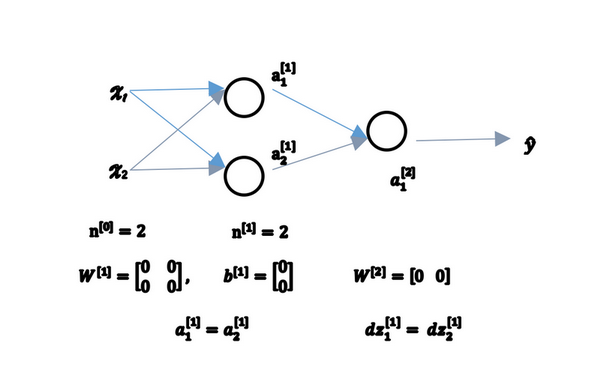
如上图,假设有两个输入特征n0,两个隐藏单元n1,初始化权重矩阵W1为0,b1=0。
前向传播时,a11和a12总是会相等,两个激活单元就会相同。
因为两个隐含单元计算同样的函数,当你做反向传播计算时,这会导致dz1和dz2,使得W2也将为0
deeplearning.ai课程学习(3)的更多相关文章
- deeplearning.ai课程学习(1)
本系列主要是我对吴恩达的deeplearning.ai课程的理解和记录,完整的课程笔记已经有很多了,因此只记录我认为重要的东西和自己的一些理解. 第一门课 神经网络和深度学习(Neural Netwo ...
- deeplearning.ai课程学习(2)
第二周:神经网络的编程基础(Basics of Neural Network programming) 1.逻辑回归的代价函数(Logistic Regression Cost Function) 逻 ...
- deeplearning.ai课程学习(4)
第四周:深层神经网络(Deep Neural Networks) 1.深层神经网络(Deep L-layer neural network) 在打算使用深层神经网络之前,先去尝试逻辑回归,尝试一层然后 ...
- Deeplearning.ai课程笔记--汇总
从接触机器学习就了解到Andrew Ng的机器学习课程,后来发现又出来深度学习课程,就开始在网易云课堂上学习deeplearning.ai的课程,Andrew 的课真是的把深入浅出.当然学习这些课程还 ...
- Deeplearning.ai课程笔记-神经网络和深度学习
神经网络和深度学习这一块内容与机器学习课程里Week4+5内容差不多. 这篇笔记记录了Week4+5中没有的内容. 参考笔记:深度学习笔记 神经网络和深度学习 结构化数据:如数据库里的数据 非结构化数 ...
- Deeplearning.ai课程笔记-改善深层神经网络
目录 一. 改善过拟合问题 Bias/Variance 正则化Regularization 1. L2 regularization 2. Dropout正则化 其他方法 1. 数据变形 2. Ear ...
- 机器学习策略——DeepLearning.AI课程总结
一.什么是ML策略 假设你正在训练一个分类器,你的系统已经达到了90%准确率,但是对于你的应用程序来说还不够好,此时你有很多的想法去继续改善你的系统: 收集更多训练数据 训练集的多样性不够,收集更多的 ...
- Deeplearning.ai课程笔记-结构化机器学习项目
目录 一. 正交化 二. 指标 1. 单一数字评估指标 2. 优化指标.满足指标 三. 训练集.验证集.测试集 1. 数据集划分 2. 验证集.测试集分布 3. 验证集.测试集大小 四. 比较人类表现 ...
- Coursera深度学习(DeepLearning.ai)编程题&笔记
因为是Jupyter Notebook的形式,所以不方便在博客中展示,具体可在我的github上查看. 第一章 Neural Network & DeepLearning week2 Logi ...
随机推荐
- pv与单广告位曝光统计优化
上一篇文章<巧用域名发散,缓解单广告位并发请求限制>中提到了我已经将广告的数据请求写成了单广告位请求.既然数据请求都已经是单广告位的了,那么曝光统计也理所应当是单广告位的. pv是什么? ...
- 自定义App首次启动引导页
代码如下 #import"ZBGuidePageView.h" @interfaceZBGuidePageView()<UIScrollViewDelegate> @p ...
- 从$emit 到 父子组件通信 再到 eventBus
故事还是得从$emit说起,某一天翻文档的时候看到$emit的说明 触发当前实例上的事件?就是自身组件上的事件呗,在父子组件通信中,父组件通过props传递给子组件数据(高阶组件可以用provide和 ...
- oracle的事务隔离级别和读一致性
oracle提供了三个隔离级别: 1.读提交 ,简而言之只能读取语句开始执行前提交的数据 2.串行,这个好理解,就是事务串行运行,避免经典的三个场景-脏读.不可重复读.幻读. 3.只读,oracle已 ...
- 【原创】从 列表的重复 到 用sum展开二层嵌套列表将子元素合并
转载请注明出处:https://www.cnblogs.com/oceanicstar/p/9517159.html ★像R语言里头有rep函数可以让向量的值重复,在python里面可以直 ...
- Linux下通过uptime判断负载情况
[root@localhost ~]# uptime 18:34:12 up 5:30, 1 user, load average: 0.00, 0.01, 0.05 load average后面的三 ...
- js 节点
var chils= s.childNodes; //得到s的全部子节点 var par=s.parentNode; //得到s的父节点 var ns=s.nextSbiling; //获得s的下 ...
- YII2 不通过composer安装Ueditor编辑器
今天用composer安装Ueditor,一直下载失败,不知道为什么,所以就手动安装了一下.记录一下安装步骤 GitHub地址 https://github.com/BigKuCha/yii2-ued ...
- Python学习:运算符
简单运算符: +(加) 两个对象相加 -(减) 从一个数中减去另一个数,如果第一个操作数不存在,则假定为零 *(乘) 给出两个数的乘积,或返回字符串重复指定次数后的结果 Eg.'haha' * 3 ...
- python正则表达式+正则大量实例
正则表达式 正则表达式内部函数详解http://www.runoob.com/python/python-reg-expressions.html 正则表达式是一个特殊的字符序列,它能帮助你方便的检查 ...