
记一次SqlServer大表查询语句优化和执行计划分析
数据库: sqlserver2008r2
表: device_data
数据量:2000w行左右
表结构
CREATE TABLE [dbo].[device_data](

    [Id] [int] IDENTITY(1,1) NOT NULL,

    [DeviceId] [nvarchar](30) NOT NULL,

    [CollectCycle] [int] NOT NULL,

    [BroadcastCycle] [int] NOT NULL,

    [Behavior] [tinyint] NOT NULL,

    [SystemTick] [int] NOT NULL,

    [Sport] [int] NOT NULL,

    [SportTime] [int] NOT NULL,

    [SleepTime] [int] NOT NULL,

    [Temperature] [int] NOT NULL,

    [Voltage] [int] NOT NULL,

    [DeviceSatatus] [int] NOT NULL,

    [DeviceType] [int] NOT NULL,

    [FireVersion] [int] NOT NULL,

    [SportRange] [int] NOT NULL,

    [UploadTime] [datetime] NOT NULL,

    [DataFlag] [tinyint] NOT NULL,

    [TagType] [tinyint] NOT NULL,

    [RSSI] [tinyint] NOT NULL,

    [CollectorMac] [nvarchar](20) NOT NULL,

 CONSTRAINT [PK__device_d__3214EC0770FDBF69] PRIMARY KEY CLUSTERED

(

    [Id] ASC

)WITH (PAD_INDEX  = OFF, STATISTICS_NORECOMPUTE  = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS  = ON, ALLOW_PAGE_LOCKS  = ON) ON [PRIMARY]

) ON [PRIMARY]
索引情况:分别有两个联合索引
idx_deviceid(DeviceId,UploadTime)
idx_collector(CollectorMac,UploadTime)
问题:这张表上传的数据都是随上传时间递增,批量有序插入进去。但是 最近几天日志经常出现插入数据超时,然后去分析了一下数据库,发现对外接口出现了慢 sql导致了死锁,
慢sql是where条件在某些情况下没有加上时间筛选过滤,2000万的表导致非常慢,于是进行了优化,优化的时候变出现了下面的两条sql语句
这两个索引对应着两个接口 查询语句分别是:
 select top 100 Id,DeviceId,Sport,Temperature,CollectorMac,UploadTime from device_data

 where [DeviceId]='C9C810B18272' and UploadTime>'2020-12-01 15:16:55.000' order by UploadTime desc;

和

 select top 100 Id,DeviceId,Sport,Temperature,CollectorMac,UploadTime from device_data

 where [CollectorMac]='95DE5F0B' and UploadTime>'2020-12-01 15:16:55.000' order by UploadTime desc;
现在遇到一个情况是 相同的where条件下 如果我Order by Id Desc 就会发现返回结果中会比order by UploadTime desc慢一点,我一开始不太理解为啥会出现这个情况。
于是想到了sqlserver的查询分析器来分析一下具体的sql执行计划
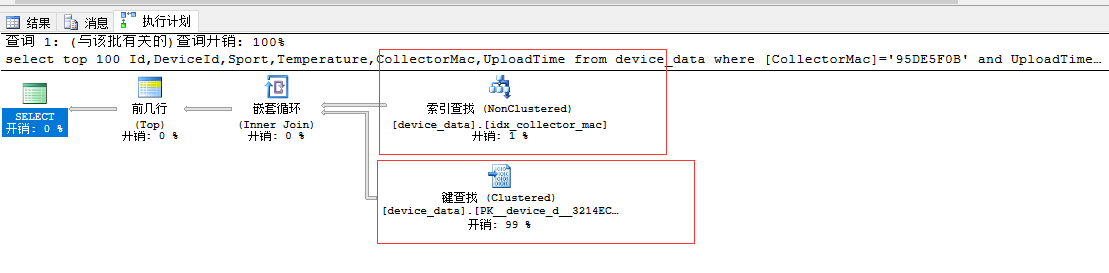
1,首先我来执行order by UploadTime desc的语句来看一下具体的执行计划
dbcc dropcleanbuffers

set statistics io on

select top 100 Id,DeviceId,Sport,Temperature,CollectorMac,UploadTime from device_data

where [CollectorMac]='95DE5F0B' and UploadTime>'2020-12-01 15:16:55.000' order by UploadTime desc;

set statistics io off
具体执行计划为:
DBCC 执行完毕。如果 DBCC 输出了错误信息,请与系统管理员联系。

(100 行受影响)

表 'device_data'。扫描计数 1,逻辑读取 1899 次,物理读取 5 次,预读 24 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。

(1 行受影响)
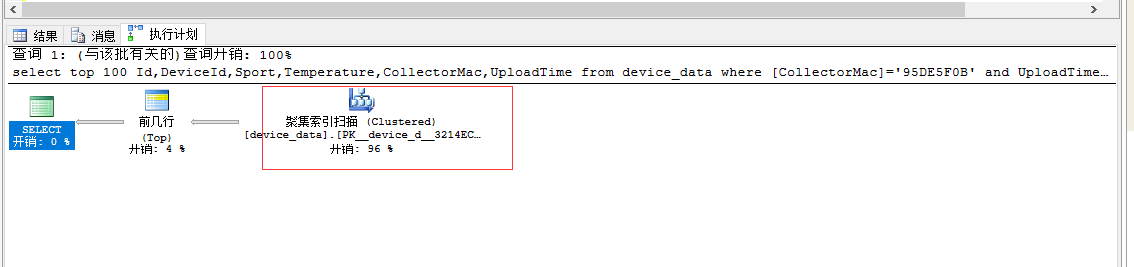
2,再来看一下order by Id desc的具体执行计划
dbcc dropcleanbuffers

set statistics io on

select top 100 Id,DeviceId,Sport,Temperature,CollectorMac,UploadTime from device_data

where [CollectorMac]='95DE5F0B' and UploadTime>'2020-12-01 15:16:55.000' order by Id desc;

set statistics io off
具体执行计划为:
DBCC 执行完毕。如果 DBCC 输出了错误信息,请与系统管理员联系。

(100 行受影响)

表 'device_data'。扫描计数 1,逻辑读取 40 次,物理读取 36 次,预读 4942 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。

(1 行受影响)
这里先说一下逻辑读取和物理读取等区别
那么,这几个词语代表什么意思呢?我们怎么根据这些来了解SQL语句或者存储过程的I/O过程呢?
预读:用于估计信息,去硬盘读取数据到缓存。
物理读:查询计划生成以后,如果发现缓存缺少所需要的数据,让缓存再次去读硬盘数据。如果内存里没有缓存数据或者执行计划(如果SQL语句发生了改变,
那么执行计划将不能重用,需要重新生成新的执行计划),那么SQLSERVER就要去硬盘读取这些数据,这个时候就是物理读取,我们大家都知道,硬盘速度
与内存速度根本不在一个数量级上,所以物理读是比较慢的。
逻辑读:SQLSERVER去内存里的缓存取数据或者执行计划,所以逻辑读是比较快的。
SQLSERVER存储的最小单位是页,每一页大小为8K,即8*1024=8192字节,SQLSERVER对页的读取是原子性的,即要么读完一页,要么完全不读。即使
仅仅要获得一条数据,也要读完该页,而页之间的数据组织结构为B树结构。所以SQLSERVER对于逻辑读,物理读,预读的单位是页。
可以看到bytime 走的是索引查找和键查找 并且大部分读取走的是逻辑读取
byid 走的是聚集索引扫描,并且大部分读取走的是预读取
看上面的介绍我们发现 逻辑读取走的是内存缓存,预读取是去硬盘读取数据到缓存然后再逻辑读取,在这一步我们基本确定了 byid慢的原因是读取了硬盘数据。
那么上图出现的索引查找和索引扫描这两者又有什么区别呢
查看了相关资料发现
Clustered Index Scan(聚集索引扫描)、Index Scan(非聚集索引扫描)

聚集索引扫描:聚集索引的数据体积实际是就是表本身,也就是说表有多少行多少列,聚集所有就有多少行多少列,那么聚集索引扫描就跟表扫描差不多,也要进行全表扫描,遍历所有表数据,查找出你想要的数据。
非聚集索引扫描:非聚集索引的体积是根据你的索引创建情况而定的,可以只包含你要查询的列。那么进行非聚集索引扫描,便是你非聚集中包含的列的所有行进行遍历,查找出你想要的数据。
Clustered Index Seek(聚集索引查找)、Index Seek(非聚集索引查找)

聚集索引查找和非聚集索引查找都是使用该图标。
聚集索引查找:聚集索引包含整个表的数据,也就是在聚集索引的数据上根据键值取数据。
非聚集索引查找:非聚集索引包含创建索引时所包含列的数据,在这些非聚集索引的数据上根据键值取数据。
Key Lookup(键值查找)

首先需要说的是查找,查找与扫描在性能上完全不是一个级别的,扫描需要遍历整张表,而查找只需要通过键值直接提取数据,返回结果,性能要好。
当你查找的列没有完全被非聚集索引包含,就需要使用键值查找在聚集索引上查找非聚集索引不包含的列。
我们发现byid引起全量扫描了 所以会慢很多
疑问:我的理解是既然我已经加了where条件去筛选数据了 order by Id还是 order by Uploadtime 是不是应该在我where筛选出来的数据中再去排序,为啥只是因为Orderby的不同,最终的执行计划差别这么大
我对理论方面不深入,只能从现象来解决问题,还请大佬们赐教
参考资料:
T-SQL查询高级--理解SQL SERVER中非聚集索引的覆盖,连接,交叉和过滤
MSSQLSERVER执行计划详解
记一次SqlServer大表查询语句优化和执行计划分析的更多相关文章
- MySQL 表查询语句练习题
MySQL 表查询语句练习题: 一. 设有一数据库,包括四个表:学生表(Student).课程表(Course).成绩表(Score)以及教师信息表(Teacher).四个表的结构分别如表1-1的表 ...
- sql查询语句优化
http://www.cnblogs.com/dubing/archive/2011/12/09/2278090.html 最近公司来一个非常虎的dba 10几年的经验 这里就称之为蔡老师吧 在征得 ...
- 转载《mysql 一》:mysql的select查询语句内在逻辑执行顺序
原文:http://www.jellythink.com/archives/924 我的抱怨 我一个搞应用开发的,非要会数据库,这不是专门的数据库开发人员干的事么?话说,小公司也没有数 据库开发人员这 ...
- mysql数据库系统学习(一)---一条SQL查询语句是如何执行的?
本文基于----MySQL实战45讲(极客时间----林晓斌 )整理----->https://time.geekbang.org/column/article/68319 一.第一节:一条sq ...
- php面试专题---MYSQL查询语句优化
php面试专题---MYSQL查询语句优化 一.总结 一句话总结: mysql的性能优化包罗甚广: 索引优化,查询优化,查询缓存,服务器设置优化,操作系统和硬件优化,应用层面优化(web服务器,缓存) ...
- 一文读懂一条 SQL 查询语句是如何执行的
2001 年 MySQL 发布 3.23 版本,自此便开始获得广泛应用,随着不断地升级迭代,至今 MySQL 已经走过了 20 个年头. 为了充分发挥 MySQL 的性能并顺利地使用,就必须正确理解其 ...
- 当程序执行一条查询语句时,MySQL内部到底发生了什么? (说一下 MySQL 执行一条查询语句的内部执行过程?
先来个最基本的总结阐述,希望各位小伙伴认真的读一下,哈哈: 1)客户端(运行程序)先通过连接器连接到MySql服务器. 2)连接器通过数据库权限身份验证后,会先查询数据库缓存是否存在(之前执行过相同条 ...
- SQLServer查询执行计划分析 - 案例
SQLServer查询执行计划分析 - 案例 http://pan.baidu.com/s/1pJ0gLjP 包括学习笔记.书.样例库
- mysql大表设计以及优化
MYSQL千万级数据量的优化方法积累https://m.toutiao.com/group/6583260372269007374/?iid=6583260372269007374 MySQL 千万级 ...
随机推荐
- 第8.24节 使用__subclasses__查看类的直接子类
在<第8.9节 Python类中内置的__bases__属性>中介绍了__bases__这个类的特殊变量可以查看类的直接父类,而__subclasses__() 方法的使用则与__base ...
- git 常用命令 command
git config --list //查看配置信息 git config user.name //查看用户名 git config user.email //查看用户邮箱 从远程克隆到本地仓库 ...
- 谈谈 javascript的 call 和 apply用法
定义: ECMAScript规范为所有函数都包含两个方法(这两个方法非继承而来),call和apply,这两个函数都是在特定的作用域中调用函数,能改变函数的作用域,实际上是改变函数体内 this 的值 ...
- ThreadLocal原理记录,别被坑了!!
简介 ThreadLocal的用处 ThreadLocal是为了将数据记录一份到某个线程里,确保该数据线程安全 例如数据库的Connection放入ThreadLocal,一个事务会用到很多DAO,但 ...
- AcWing 317. 陨石的秘密
1 -> {} 2 -> [] 3 -> () \(f[d][a][b][c]\) 表示 \([i * 2 - 1, j * 2]\) 这段区间 深度为 d \(1\) 有 \(a\ ...
- 在虚拟机中安装Linux系统CentOS7详细教程!!!超详细!!!!一看就会!!!手把手教学!!!
一.CentOS的下载 CentOS是免费版,推荐在官网上直接下载.https://www.centos.org/download/ DVD ISO:普通光盘完整安装版镜像,可离线安装到计算机硬盘上, ...
- 架构师基础技能-搭建gitLab
前言 想要成为一名架构师,一定要有从无到有搭建环境的能力,这是作为架构师的基础技能,而gitLab服务器的搭建一定又是重中之重. 相信很多小伙伴的公司也在使用gitLab,但都是你们公司的架构师搭建好 ...
- 2. 使用Shell能做什么
批处理 在批处理的过程中,能够实现脚步自动化,比GUI自动化速度高效 日常工作场景 服务端测试 移动端测试 持续集成与自动化部署,这是最最场景的场景,可以说离开了shell,持续集成和自动化部署也会遇 ...
- k8s第二回之k8s集群的安装
1. k8s集群的安装 目录 1. k8s集群的安装 1.架构: 2.环境准备 3.master节点安装etcd 4. master节点安装kubernetes 5.node节点安装kubernete ...
- Acunetix 11手动导入Burp suite抓取的网页
设置爬取 因为Burp的代理默认配置拦截所有请求,需要先来关闭这个功能,在Proxy标签页面中,选择Intercept子标签页面,点击 Intercept is on按钮. 使用配置好代理服务器的浏览 ...