
数据湖-Apache Hudi
Hudi特性
数据湖处理非结构化数据、日志数据、结构化数据
支持较快upsert/delete, 可插入索引
Table Schema
小文件管理Compaction
ACID语义保证,多版本保证 并具有回滚功能
savepoint 用户数据恢复的保存点
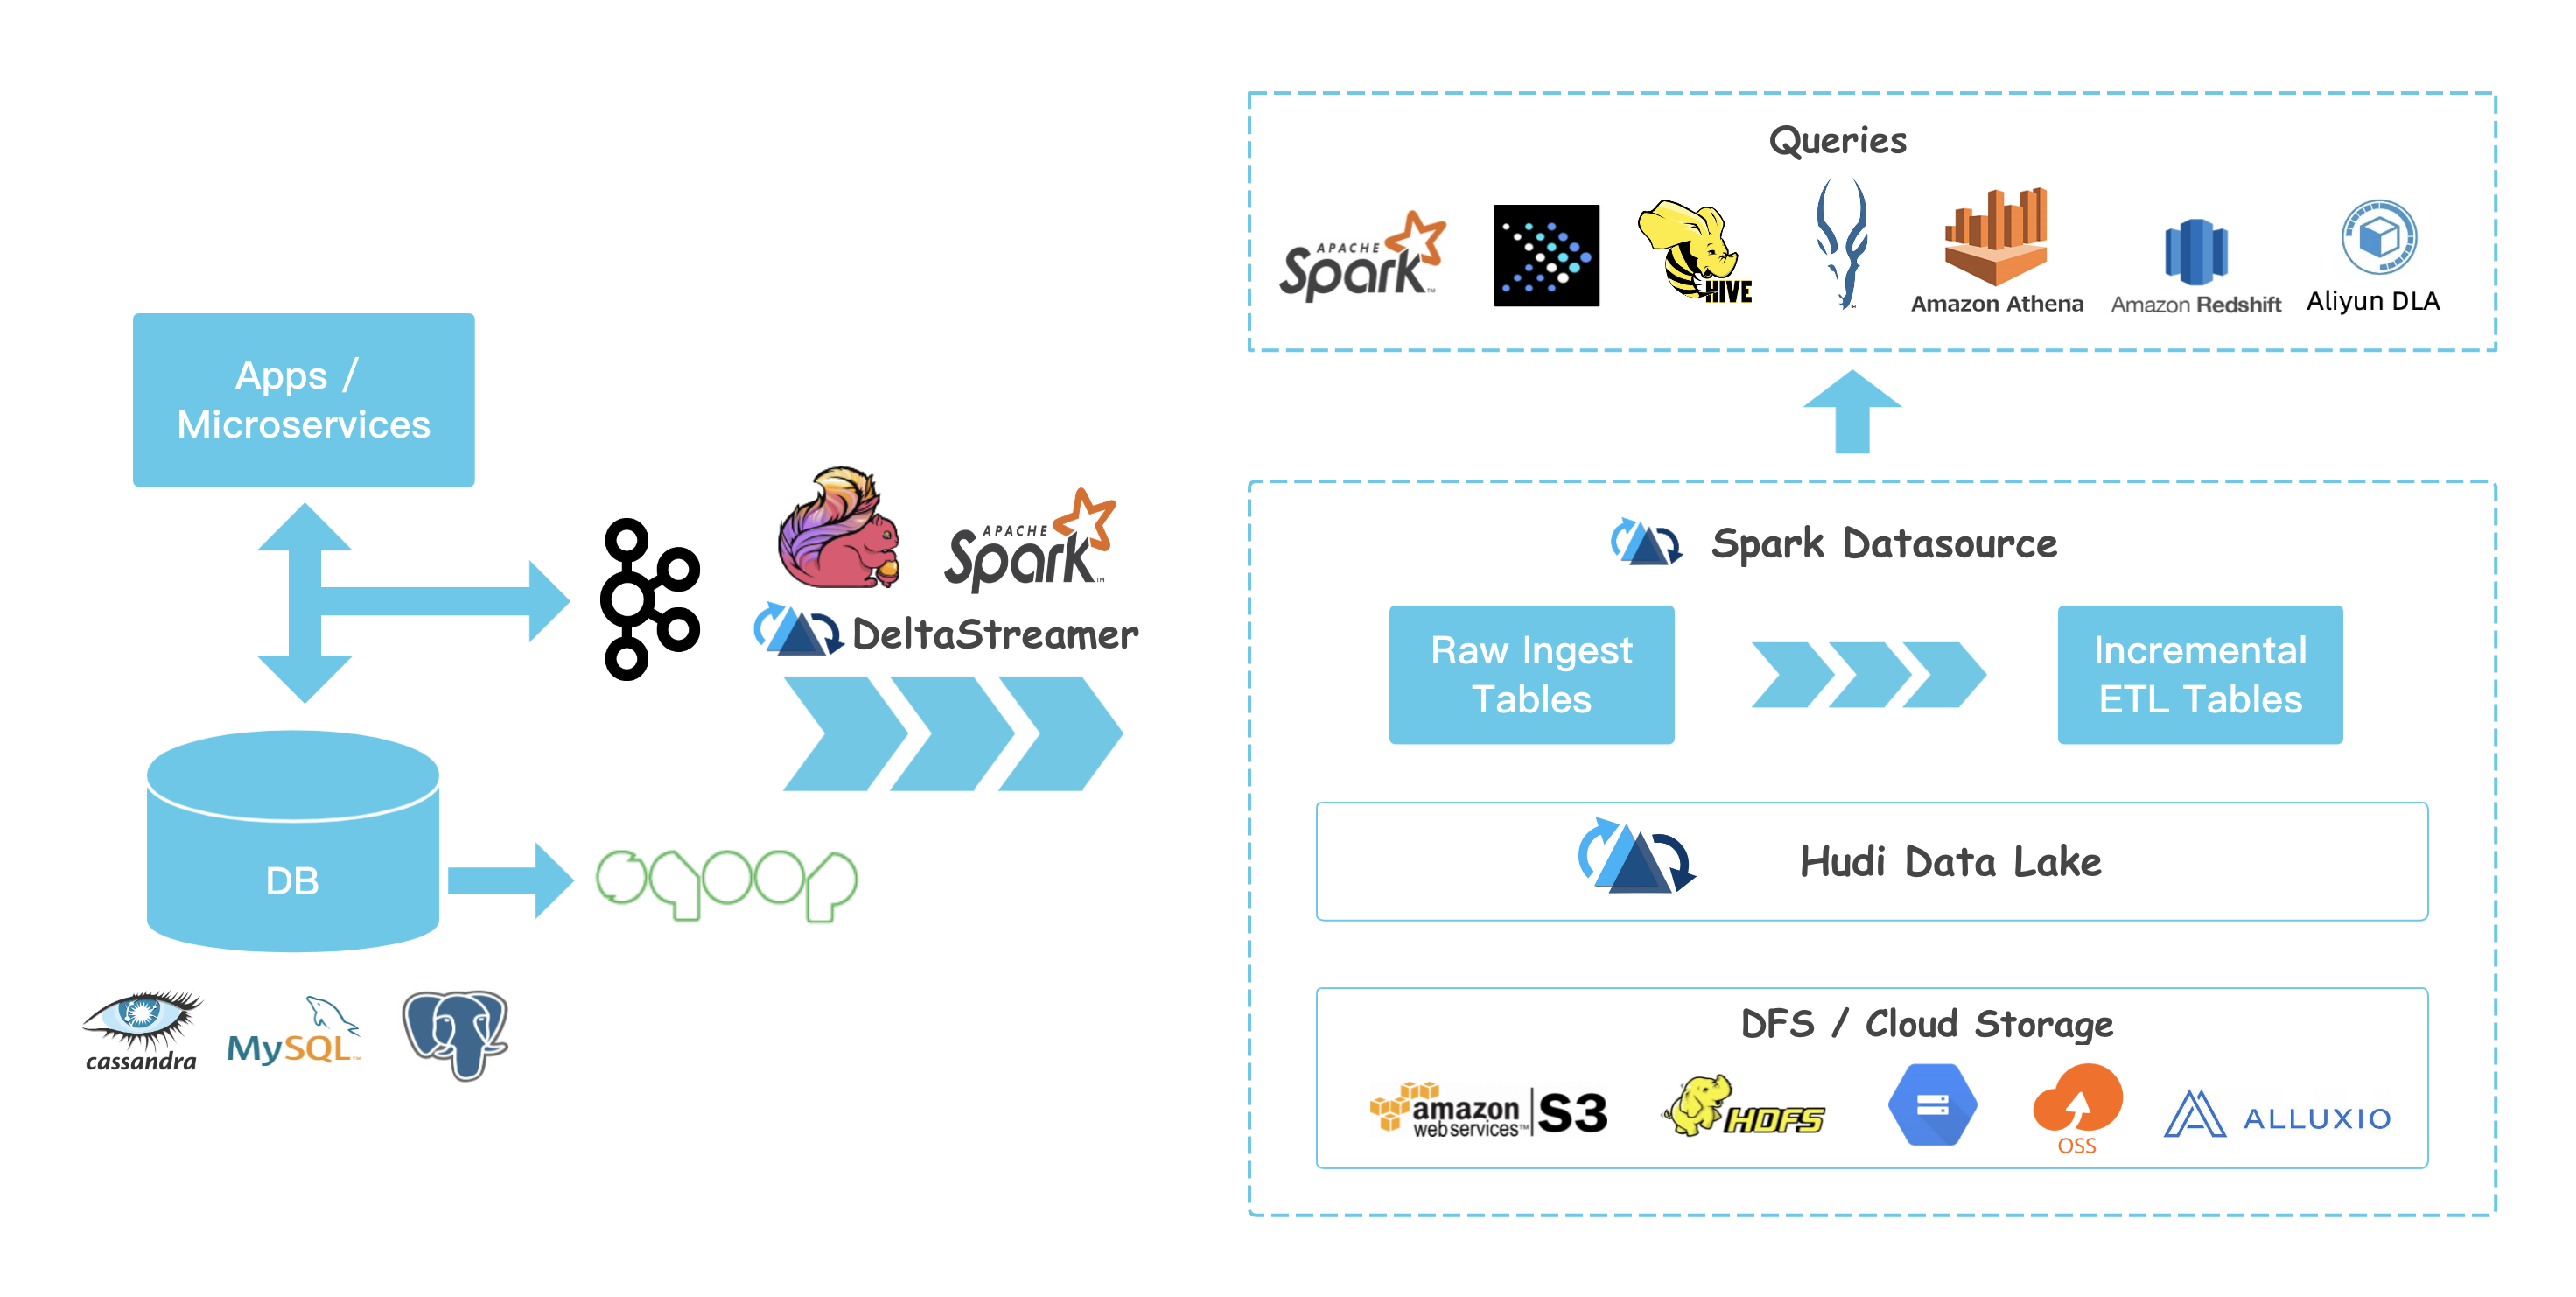
支持多种分析引擎 spark、hive、presto
编译Hudi
git clone https://github.com/apache/hudi.git && cd hudi
mvn clean package -DskipTests
hudi 高度耦合spark
执行spark-shell测试Hudi
bin/spark-shell --packages org.apache.spark:spark-avro_2.11:2.4.5 --conf 'spark.serializer=org.apache.spark.serializer.KryoSerializer' --jars /Users/macwei/IdeaProjects/hudi-master/packaging/hudi-spark-bundle/target/hudi-spark-bundle_2.11-0.6.1-SNAPSHOT.jar
hudi 写入数据
// spark-shell

import org.apache.hudi.QuickstartUtils._

import scala.collection.JavaConversions._

import org.apache.spark.sql.SaveMode._

import org.apache.hudi.DataSourceReadOptions._

import org.apache.hudi.DataSourceWriteOptions._

import org.apache.hudi.config.HoodieWriteConfig._

val tableName = "hudi_trips_cow"

val basePath = "file:///tmp/hudi_trips_cow"

val dataGen = new DataGenerator

// spark-shell

val inserts = convertToStringList(dataGen.generateInserts(10))

val df = spark.read.json(spark.sparkContext.parallelize(inserts, 2))

df.write.format("hudi").

  options(getQuickstartWriteConfigs).

  option(PRECOMBINE_FIELD_OPT_KEY, "ts").

  option(RECORDKEY_FIELD_OPT_KEY, "uuid").

  option(PARTITIONPATH_FIELD_OPT_KEY, "partitionpath").

  option(TABLE_NAME, tableName).

  mode(Overwrite).

  save(basePath)
读取hudi数据:
  val tripsSnapshotDF = spark.

  read.

  format("hudi").

  load(basePath + "/*/*/*/*")

  tripsSnapshotDF.createOrReplaceTempView("hudi_trips_snapshot")

  spark.sql("select fare, begin_lon, begin_lat, ts from  hudi_trips_snapshot where fare > 20.0").show()

  +------------------+-------------------+-------------------+-------------+

|              fare|          begin_lon|          begin_lat|           ts|

+------------------+-------------------+-------------------+-------------+

| 64.27696295884016| 0.4923479652912024| 0.5731835407930634|1609771934700|

| 93.56018115236618|0.14285051259466197|0.21624150367601136|1610087553306|

| 33.92216483948643| 0.9694586417848392| 0.1856488085068272|1609982888463|

| 27.79478688582596| 0.6273212202489661|0.11488393157088261|1610187369637|

|34.158284716382845|0.46157858450465483| 0.4726905879569653|1610017361855|

|  43.4923811219014| 0.8779402295427752| 0.6100070562136587|1609795685223|

| 66.62084366450246|0.03844104444445928| 0.0750588760043035|1609923236735|

| 41.06290929046368| 0.8192868687714224|  0.651058505660742|1609838517703|

+------------------+-------------------+-------------------+-------------+

spark.sql("select _hoodie_commit_time, _hoodie_record_key, _hoodie_partition_path, rider, driver, fare from  hudi_trips_snapshot").show()

+-------------------+--------------------+----------------------+---------+----------+------------------+

|_hoodie_commit_time|  _hoodie_record_key|_hoodie_partition_path|    rider|    driver|              fare|

+-------------------+--------------------+----------------------+---------+----------+------------------+

|     20210110225218|3c7ef0e7-86fb-444...|  americas/united_s...|rider-213|driver-213| 64.27696295884016|

|     20210110225218|222db9ca-018b-46e...|  americas/united_s...|rider-213|driver-213| 93.56018115236618|

|     20210110225218|3fc72d76-f903-4ca...|  americas/united_s...|rider-213|driver-213|19.179139106643607|

|     20210110225218|512b0741-e54d-426...|  americas/united_s...|rider-213|driver-213| 33.92216483948643|

|     20210110225218|ace81918-0e79-41a...|  americas/united_s...|rider-213|driver-213| 27.79478688582596|

|     20210110225218|c76f82a1-d964-4db...|  americas/brazil/s...|rider-213|driver-213|34.158284716382845|

|     20210110225218|73145bfc-bcb2-424...|  americas/brazil/s...|rider-213|driver-213|  43.4923811219014|

|     20210110225218|9e0b1d58-a1c4-47f...|  americas/brazil/s...|rider-213|driver-213| 66.62084366450246|

|     20210110225218|b8fccca1-9c28-444...|    asia/india/chennai|rider-213|driver-213|17.851135255091155|

|     20210110225218|6144be56-cef9-43c...|    asia/india/chennai|rider-213|driver-213| 41.06290929046368|

+-------------------+--------------------+----------------------+---------+----------+------------------+
对比
数据导入至hadoop方案: maxwell、canal、flume、sqoop
hudi是通用方案
hudi 支持presto、spark sql下游查询
hudi存储依赖hdfs
hudi可以当作数据源或数据库,支持PB级别
概念
Timeline: 时间戳
state:即时状态
原子写入操作
compaction: 后台协调hudi中差异数据
rollback: 回滚
savepoint: 数据还原
任何操作都有以下状态:
- Requested 已安排操作行为,但是没有开始
- Inflight 正在执行当前操作
- Completed 已完成操作
hudi提供两种表类型:
- CopyOnWrite 适用全量数据,列式存储,写入过程执行同步合并重写文件
- MergeOnRead 增量数据,基于列式(parquet)和行式(avro)存储,更新记录到增量文件(日志文件),压缩同步和异步生成新版本文件,延迟更低
hudi查询类型:
- 快照查询 查询最新快照表数据,如果是MergeOnRead表,动态合并最新版本基本数据和增量数据用于显示查询;如果是CopyOnWrite,直接查询Parquet表,同时提供upsert、delete操作
- 增量查询 只能看到写入表的新数据
- 优化读查询 给定时间段的一个查询
资料参考
- Docker Demo: https://hudi.apache.org/docs/docker_demo.html Hudi 官方建议代码测试可在Docker进行, 如果在Docker运行有问题也可以进行Remote Debugger
- Hudi 目前代码写的很多实现其实有点不太好, 如果有想贡献提交PR的可参考: 如何进行开源贡献
数据湖-Apache Hudi的更多相关文章
- 使用Apache Hudi构建大规模、事务性数据湖
一个近期由Hudi PMC & Uber Senior Engineering Manager Nishith Agarwal分享的Talk 关于Nishith Agarwal更详细的介绍,主 ...
- 基于Apache Hudi构建分析型数据湖
为了有机地发展业务,每个组织都在迅速采用分析. 在分析过程的帮助下,产品团队正在接收来自用户的反馈,并能够以更快的速度交付新功能. 通过分析提供的对用户的更深入了解,营销团队能够调整他们的活动以针对特 ...
- Apache Hudi助力nClouds加速数据交付
1. 概述 在nClouds上,当客户的业务决策取决于对近实时数据的访问时,客户通常会向我们寻求有关数据和分析平台的解决方案.但随着每天创建和收集的数据量都在增加,这使得使用传统技术进行数据分析成为一 ...
- 官宣!ASF官方正式宣布Apache Hudi成为顶级项目
马萨诸塞州韦克菲尔德(Wakefield,MA)- 2020年6月 - Apache软件基金会(ASF).350多个开源项目和全职开发人员.管理人员和孵化器宣布:Apache Hudi正式成为Apac ...
- Apache Hudi和Presto的前世今生
一篇由Apache Hudi PMC Bhavani Sudha Saktheeswaran和AWS Presto团队工程师Brandon Scheller分享Apache Hudi和Presto集成 ...
- 划重点!AWS的湖仓一体使用哪种数据湖格式进行衔接?
此前Apache Hudi社区一直有小伙伴询问能否使用Amazon Redshift查询Hudi表,现在它终于来了. 现在您可以使用Amazon Redshift查询Amazon S3 数据湖中Apa ...
- Halodoc使用 Apache Hudi 构建 Lakehouse的关键经验
Halodoc 数据工程已经从传统的数据平台 1.0 发展到使用 LakeHouse 架构的现代数据平台 2.0 的改造.在我们之前的博客中,我们提到了我们如何在 Halodoc 实施 Lakehou ...
- 使用 Apache Hudi 实现 SCD-2(渐变维度)
数据是当今分析世界的宝贵资产. 在向最终用户提供数据时,跟踪数据在一段时间内的变化非常重要. 渐变维度 (SCD) 是随时间推移存储和管理当前和历史数据的维度. 在 SCD 的类型中,我们将特别关注类 ...
- 华为云 MRS 基于 Apache Hudi 极致查询优化的探索实践
背景 湖仓一体(LakeHouse)是一种新的开放式架构,它结合了数据湖和数据仓库的最佳元素,是当下大数据领域的重要发展方向. 华为云早在2020年就开始着手相关技术的预研,并落地在华为云 Fusio ...
随机推荐
- 磁盘IO工作机制
磁盘IO工作机制 ref: <深入分析java web 技术内幕> by:许令波 几种访问文件的方式 文件读取和写入的 IO 操作都是调用操作系统提供的接口,因为磁盘设备是由操作系统管理的 ...
- Spring AOP 实战运用
Spring AOP 实战 看了上面这么多的理论知识, 不知道大家有没有觉得枯燥哈. 不过不要急, 俗话说理论是实践的基础, 对 Spring AOP 有了基本的理论认识后, 我们来看一下下面几个具体 ...
- Echarts数据可视化,easyshu图表集成。
介绍: ECharts,一个使用 JavaScript 实现的开源可视化库,可以流畅的运行在 PC 和移动设备上,兼容当前绝大部分浏览器(IE8/9/10/11,Chrome,Firefox,Sa ...
- Class的一些使用技巧?
1.forName和newInstance结合起来使用,可以根据存储在字符串中的类名创建对象.例如 Object obj = Class.forName(s).newInstance(); 2.虚拟机 ...
- RocketMQ踩坑记
一.前言 现在的主流消息队列基本都是kafka.RabbitMQ和RocketMQ,只有了解各自的优缺点才能在不同的场景选择合适的MQ,对比图如下: MQ对比图 本篇文章主要介绍我自己在跑官方demo ...
- ADO.NET对SqlServer进行简单的增删改查
对数据库进行增删改查,首先想到的应该就是连接字符串了. 我们的连接字符串是由"Server=地址(本机=local);Database=数据库名称;User Id=登陆用户名;Passwor ...
- Vue——监听器watch
使用watch来侦听data中数据的变化,watch中的属性(watch是对象格式)一定是data 中已经存在的数据. 使用场景:数据变化时执行异步或开销比较大的操作. 典型应用:http://www ...
- linux系统Vsftpd搭建FTP
安装vsftp 使用yum命令安装vsftp #yum install vsftpd -y 添加ftp帐号和目录 先检查下nologin的位置,通常在/usr/sbin/nologin下 (*no ...
- linux服务开机自启动&注册系统服务
首先先看下linux系统开机启动顺序,如下图 对,要解决Linux CentOS 和 Red Hat Linux 系统中设置服务自启动有两种方式,就是从图中圈出的两个步骤下手. 一.修改 /etc/r ...
- 【Linux】使用grep快速比较两个文件不同
两个文件的比较,会有同学说使用diff,和vimdiff就可以快速比较,为什么还要使用grep呢? 有些时候,diff和vimdiff的时候环境不符合,这样的情况,就可以使用grep来解决这个问题. ...