
L1-027 出租
下面是新浪微博上曾经很火的一张图:
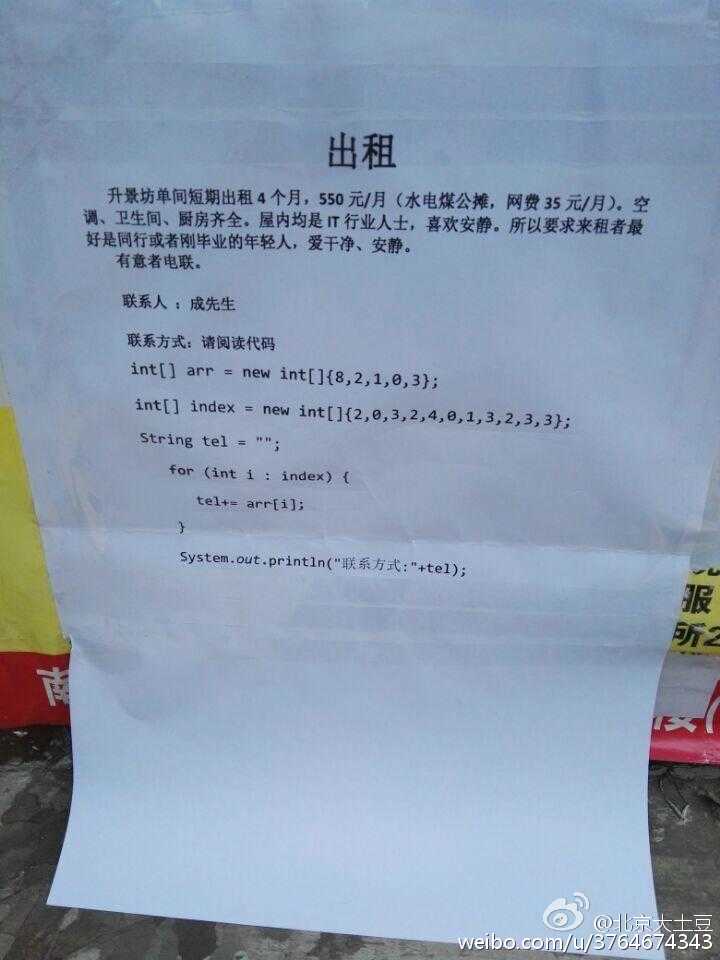
一时间网上一片求救声,急问这个怎么破。其实这段代码很简单,index数组就是arr数组的下标,index[0]=2 对应 arr[2]=1,index[1]=0 对应 arr[0]=8,index[2]=3 对应 arr[3]=0,以此类推…… 很容易得到电话号码是18013820100。
本题要求你编写一个程序,为任何一个电话号码生成这段代码 —— 事实上,只要生成最前面两行就可以了,后面内容是不变的。
输入格式:
输入在一行中给出一个由11位数字组成的手机号码。
输出格式:
为输入的号码生成代码的前两行,其中arr中的数字必须按递减顺序给出。
输入样例:
18013820100
输出样例:
int[] arr = new int[]{8,3,2,1,0};

int[] index = new int[]{3,0,4,3,1,0,2,4,3,4,4};
 #include<iostream>

 #include<cstring>

 using namespace std;

 int main()

 {

     int book[];

     memset(book,,sizeof(book));

     char number[];

     cin>>number;

     for(int i=;i<;i++)

         book[number[i]-'']=;

     cout<<"int[] arr = new int[]{";

     int count;

     int t=;

     int num[];

     for(int i=;i<=;i++)

     {

     if(book[i])

     {

         count=i;

         break;

     }

     }

     for(int i=;i>=;i--)

     {

         if(book[i])

         {

             num[t++]=i;

         count==i?cout<<i:cout<<i<<",";

         }

     }

     cout<<"};"<<endl<<"int[] index = new int[]{";

     for(int i=;i<;i++)

     {

         for(int j=;j<t;j++)

         {

             if((number[i]-'')==num[j])

             {

             cout<<j<<",";

             continue;

             }

         }

     }

     for(int j=;j<t;j++)

     {

         if((number[]-'')==num[j])

         {

             cout<<j<<"};";

             return ;

         }

     }

     return ;

 }
L1-027 出租的更多相关文章
- paper 126:[转载] 机器学习中的范数规则化之(一)L0、L1与L2范数
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
- 正则化方法:L1和L2 regularization、数据集扩增、dropout
正则化方法:防止过拟合,提高泛化能力 在训练数据不够多时,或者overtraining时,常常会导致overfitting(过拟合).其直观的表现如下图所示,随着训练过程的进行,模型复杂度增加,在tr ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数
L1正则会产生稀疏解,让很多无用的特征的系数变为0,只留下一些有用的特征 L2正则不让某些特征的系数变为0,即不产生稀疏解,只让他们接近于0.即L2正则倾向于让权重w变小.见第二篇的推导. 所以,样本 ...
- Proximal Gradient Descent for L1 Regularization
[本文链接:http://www.cnblogs.com/breezedeus/p/3426757.html,转载请注明出处] 假设我们要求解以下的最小化问题: ...
- 一种利用 Cumulative Penalty 训练 L1 正则 Log-linear 模型的随机梯度下降法
Log-Linear 模型(也叫做最大熵模型)是 NLP 领域中使用最为广泛的模型之一,其训练常采用最大似然准则,且为防止过拟合,往往在目标函数中加入(可以产生稀疏性的) L1 正则.但对于这种带 L ...
- 浅谈压缩感知(三十):压缩感知重构算法之L1最小二乘
主要内容: l1_ls的算法流程 l1_ls的MATLAB实现 一维信号的实验与结果 前言 前面所介绍的算法都是在匹配追踪算法MP基础上延伸的贪心算法,从本节开始,介绍基于凸优化的压缩感知重构算法. ...
- The L1 Median (Weber 1909)
The L1 Median (Weber 1909) 链接网址 Derived from a transportation cost minimization problem, the L1 medi ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数(转)
http://blog.csdn.net/zouxy09/article/details/24971995 机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http: ...
- L0/L1/L2范数的联系与区别
L0/L1/L2范数的联系与区别 标签(空格分隔): 机器学习 最近快被各大公司的笔试题淹没了,其中有一道题是从贝叶斯先验,优化等各个方面比较L0.L1.L2范数的联系与区别. L0范数 L0范数表示 ...
- L1 - 闭包和原型链
先来一炮尝尝: var i = 10; function myFunc(){ var i = 20; function innerFunc(){ alert(i); } return innerFun ...
随机推荐
- 风景区的面积及道路状况分析问题 test
参考文献: https://wenku.baidu.com/view/b6aed86baf1ffc4ffe47ac92.html #include <bits/stdc++.h> us ...
- 3、CommonChunkPlugin提取公共js-以提取一个jquery为例
cnpm install css-loader --save-dev //css-loader 是将css打包进js cnpm install style-loader --save-dev ...
- BZOJ 1003: [ZJOI2006]物流运输(spfa+dp)
http://www.lydsy.com/JudgeOnline/problem.php?id=1003 题意: 思路: 首先用spfa计算一下任意两天之内的最短路,dis[a][b]表示的就是在第a ...
- Oncomine: 一个肿瘤相关基因研究的数据库--转载
如果你获得了一个肿瘤差异表达基因,想研究其是否可作为某种肿瘤的潜在标志物和靶点,又怕做实验会得到阴性结果,浪费时间和金钱,这时候你就应该想到Oncomine数据库了(www.oncomine.org) ...
- GRASP (职责分配原则)
要学习设计模式,有些基础知识是我们必须要先知道的,设计模式是关于类和对象的一种高效.灵活的使用方式,也就是说,必须先有类和对象,才能有设计模式的用武之地,否则一切都是空谈,那么类和对象是从那冒出来的呢 ...
- TinyXml节点查找及修改
参考:http://blog.csdn.net/zww0815/article/details/8083550 // 读者对象:对TinyXml有一定了解的人.本文是对TinyXml工具的一些知识点的 ...
- threejs和3d各种效果的学习
写给即将开始threejs学习的自己,各种尝试,各种记忆.不要怕,灰色的年华终会过去. 一个技术学习的快慢,以及你的深刻程度,还有你的以后遇到这个东西的时候的反应速度,很大程度上,取决于你的博客的深刻 ...
- SqlServer和Oracle判断表和列是否存在
SqlServer .判断表Users是否存在 if object_id(N'Users',N'U') is not null print '存在' else print '不存在' .判断表User ...
- 百度echart如何动态生成图表
百度echart如何动态生成图表 一.总结 一句话总结: clear hideloading setOption 主要是下面三行代码: myChart.clear(); //清空画布myChart.h ...
- vue.js选择if(条件渲染)详解
vue.js选择if(条件渲染)详解 一.总结 一句话总结: v-if <!DOCTYPE html> <html lang="en"> <head& ...