
C#学习笔记(12)——三种方法操作XML
说明(2017-7-11 16:56:13):
原文地址:
C#中常用的几种读取XML文件的方法
XML文件是一种常用的文件格式,例如WinForm里面的app.config以及Web程序中的web.config文件,还有许多重要的场所都有它的身影。Xml是Internet环境中跨平台的,依赖于内容的技术,是当前处理结构化文档信息的有力工具。XML是一种简单的数据存储语言,使用一系列简单的标记描述数据,而这些标记可以用方便的方式建立,虽然XML占用的空间比二进制数据要占用更多的空间,但XML极其简单易于掌握和使用。微软也提供了一系列类库来倒帮助我们在应用程序中存储XML文件。
“在程序中访问进而操作XML文件一般有两种模型,分别是使用DOM(文档对象模型)和流模型,使用DOM的好处在于它允许编辑和更新XML文档,可以随机访问文档中的数据,可以使用XPath查询,但是,DOM的缺点在于它需要一次性的加载整个文档到内存中,对于大型的文档,这会造成资源问题。流模型很好的解决了这个问题,因为它对XML文件的访问采用的是流的概念,也就是说,任何时候在内存中只有当前节点,但它也有它的不足,它是只读的,仅向前的,不能在文档中执行向后导航操作。”具体参见在Visual C#中使用XML指南之读取XML
下面我将介绍三种常用的读取XML文件的方法。分别是
1: 使用 XmlDocument
2: 使用 XmlTextReader
3: 使用 Linq to Xml
这里我先创建一个XML文件,名为Book.xml下面所有的方法都是基于这个XML文件的,文件内容如下:
1: <?xml version="1.0" encoding="utf-8"?>
2: <bookstore>
3: <!--记录书本的信息-->
4: <book Type="必修课" ISBN="7-111-19149-2">
5: <title>数据结构</title>
6: <author>严蔚敏</author>
7: <price>30.00</price>
8: </book>
9: <book Type="必修课" ISBN="7-111-19149-3">
10: <title>路由型与交换型互联网基础</title>
11: <author>程庆梅</author>
12: <price>27.00</price>
13: </book>
14: <book Type="必修课" ISBN="7-111-19149-4">
15: <title>计算机硬件技术基础</title>
16: <author>李继灿</author>
17: <price>25.00</price>
18: </book>
19: <book Type="必修课" ISBN="7-111-19149-5">
20: <title>软件质量保证与管理</title>
21: <author>朱少民</author>
22: <price>39.00</price>
23: </book>
24: <book Type="必修课" ISBN="7-111-19149-6">
25: <title>算法设计与分析</title>
26: <author>王红梅</author>
27: <price>23.00</price>
28: </book>
29: <book Type="选修课" ISBN="7-111-19149-1">
30: <title>计算机操作系统</title>
31: <author>7-111-19149-1</author>
32: <price>28</price>
33: </book>
34: </bookstore>
为了方便读取,我还定义一个书的实体类,名为BookModel,具体内容如下:
1: using System;
2: using System.Collections.Generic;
3: using System.Linq;
4: using System.Text;
5:
6: namespace 使用XmlDocument
7: {
8: public class BookModel
9: {
10: public BookModel()
11: { }
12: /// <summary>
13: /// 所对应的课程类型
14: /// </summary>
15: private string bookType;
16:
17: public string BookType
18: {
19: get { return bookType; }
20: set { bookType = value; }
21: }
22:
23: /// <summary>
24: /// 书所对应的ISBN号
25: /// </summary>
26: private string bookISBN;
27:
28: public string BookISBN
29: {
30: get { return bookISBN; }
31: set { bookISBN = value; }
32: }
33:
34: /// <summary>
35: /// 书名
36: /// </summary>
37: private string bookName;
38:
39: public string BookName
40: {
41: get { return bookName; }
42: set { bookName = value; }
43: }
44:
45: /// <summary>
46: /// 作者
47: /// </summary>
48: private string bookAuthor;
49:
50: public string BookAuthor
51: {
52: get { return bookAuthor; }
53: set { bookAuthor = value; }
54: }
55:
56: /// <summary>
57: /// 价格
58: /// </summary>
59: private double bookPrice;
60:
61: public double BookPrice
62: {
63: get { return bookPrice; }
64: set { bookPrice = value; }
65: }
66: }
67: }
1.使用XmlDocument.
使用XmlDocument是一种基于文档结构模型的方式来读取XML文件.在XML文件中,我们可以把XML看作是由文档声明(Declare),元素(Element),属性(Attribute),文本(Text)等构成的一个树.最开始的一个结点叫作根结点,每个结点都可以有自己的子结点.得到一个结点后,可以通过一系列属性或方法得到这个结点的值或其它的一些属性.例如:
1: xn 代表一个结点
2: xn.Name;//这个结点的名称
3: xn.Value;//这个结点的值
4: xn.ChildNodes;//这个结点的所有子结点
5: xn.ParentNode;//这个结点的父结点
6: .......
1: XmlDocument doc = new XmlDocument();
2: doc.Load(@"..\..\Book.xml");
然后可以通过调用SelectSingleNode得到指定的结点,通过GetAttribute得到具体的属性值.参看下面的代码
1: // 得到根节点bookstore
2: XmlNode xn = xmlDoc.SelectSingleNode("bookstore");
3:
4:
5: // 得到根节点的所有子节点
6: XmlNodeList xnl = xn.ChildNodes;
7:
8: foreach (XmlNode xn1 in xnl)
9: {
10: BookModel bookModel = new BookModel();
11: // 将节点转换为元素,便于得到节点的属性值
12: XmlElement xe = (XmlElement)xn1;
13: // 得到Type和ISBN两个属性的属性值
14: bookModel.BookISBN = xe.GetAttribute("ISBN").ToString();
15: bookModel.BookType = xe.GetAttribute("Type").ToString();
16: // 得到Book节点的所有子节点
17: XmlNodeList xnl0 = xe.ChildNodes;
18: bookModel.BookName=xnl0.Item(0).InnerText;
19: bookModel.BookAuthor=xnl0.Item(1).InnerText;
20: bookModel.BookPrice=Convert.ToDouble(xnl0.Item(2).InnerText);
21: bookModeList.Add(bookModel);
22: }
23: dgvBookInfo.DataSource = bookModeList;
在正常情况下,上面的代码好像没有什么问题,但是对于读取上面的XML文件,则会出错,原因就是因为我上面的XML文件里面有注释,大家可以参看Book.xml文件中的第三行,我随便加的一句注释.注释也是一种结点类型,在没有特别说明的情况下,会默认它也是一个结点(Node).所以在把结点转换成元素的时候就会报错."无法将类型为“System.Xml.XmlComment”的对象强制转换为类型“System.Xml.XmlElement”。"
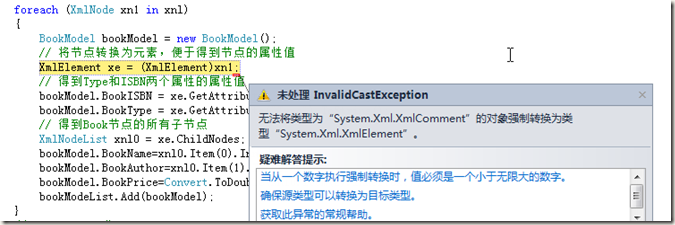
幸亏它里面自带了解决办法,那就是在读取的时候,告诉编译器让它忽略掉里面的注释信息.修改如下:
1: XmlDocument xmlDoc = new XmlDocument();
2: XmlReaderSettings settings = new XmlReaderSettings();
3: settings.IgnoreComments = true;//忽略文档里面的注释
4: XmlReader reader = XmlReader.Create(@"..\..\Book.xml", settings);
5: xmlDoc.Load(reader);
最后读取完毕后,记得要关掉reader.
1: reader.Close();
这样它就不会出现错误.
最后运行结果如下:
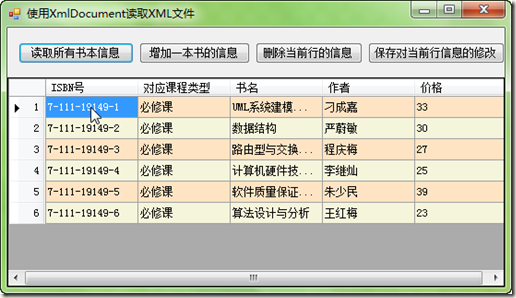
1.2 增加一本书的信息.
向文件中添加新的数据的时候,首先也是通过XmlDocument加载整个文档,然后通过调用SelectSingleNode方法获得根结点,通过CreateElement方法创建元素,用CreateAttribute创建属性,用AppendChild把当前结点挂接在其它结点上,用SetAttributeNode设置结点的属性.具体代码如下:
加载文件并选出要结点:
1: XmlDocument doc = new XmlDocument();
2: doc.Load(@"..\..\Book.xml");
3: XmlNode root = doc.SelectSingleNode("bookstore");
创建一个结点,并设置结点的属性:
1: XmlElement xelKey = doc.CreateElement("book");
2: XmlAttribute xelType = doc.CreateAttribute("Type");
3: xelType.InnerText = "adfdsf";
4: xelKey.SetAttributeNode(xelType);
创建子结点:
1: XmlElement xelAuthor = doc.CreateElement("author");
2: xelAuthor.InnerText = "dfdsa";
3: xelKey.AppendChild(xelAuthor);
1: root.AppendChild(xelKey);
2: doc.Save(@"..\..\Book.xml");
用上面的方法,是向已有的文件上追加数据,如果想覆盖原有的所有数据,可以更改一下,使用LoadXml方法:
1: XmlDocument doc = new XmlDocument();
2: doc.LoadXml("<bookstore></bookstore>");//用这句话,会把以前的数据全部覆盖掉,只有你增加的数据
直接把根结点选择出来了,后面不用SelectSingleNode方法选择根结点,直接创建结点即可,代码同上.
1.3 删除某一个数据
想要删除某一个结点,直接找到其父结点,然后调用RemoveChild方法即可,现在关键的问题是如何找到这个结点,上面的SelectSingleNode可以传入一个Xpath表,我们通过书的ISBN号来找到这本书所在的结点.如下:
1: XmlElement xe = xmlDoc.DocumentElement; // DocumentElement 获取xml文档对象的根XmlElement.
2: string strPath = string.Format("/bookstore/book[@ISBN=\"{0}\"]", dgvBookInfo.CurrentRow.Cells[1].Value.ToString());
3: XmlElement selectXe = (XmlElement)xe.SelectSingleNode(strPath); //selectSingleNode 根据XPath表达式,获得符合条件的第一个节点.
4: selectXe.ParentNode.RemoveChild(selectXe);
"/bookstore/book[@ISBN=\"{0}\"]"是一个Xpath表达式,找到ISBN号为所选那一行ISBN号的那本书,有关Xpath的知识请参考:XPath 语法
1.4 修改某要条数据
修改某 条数据的话,首先也是用Xpath表达式找到所需要修改的那一个结点,然后如果是元素的话,就直接对这个元素赋值,如果是属性的话,就用SetAttribute方法设置即可.如下:
1: XmlElement xe = xmlDoc.DocumentElement; // DocumentElement 获取xml文档对象的根XmlElement.
2: string strPath = string.Format("/bookstore/book[@ISBN=\"{0}\"]", dgvBookInfo.CurrentRow.Cells[1].Value.ToString());
3: XmlElement selectXe = (XmlElement)xe.SelectSingleNode(strPath); //selectSingleNode 根据XPath表达式,获得符合条件的第一个节点.
4: selectXe.SetAttribute("Type", dgvBookInfo.CurrentRow.Cells[0].Value.ToString());//也可以通过SetAttribute来增加一个属性
5: selectXe.GetElementsByTagName("title").Item(0).InnerText = dgvBookInfo.CurrentRow.Cells[2].Value.ToString();
6: selectXe.GetElementsByTagName("author").Item(0).InnerText = dgvBookInfo.CurrentRow.Cells[3].Value.ToString();
7: selectXe.GetElementsByTagName("price").Item(0).InnerText = dgvBookInfo.CurrentRow.Cells[4].Value.ToString();
8: xmlDoc.Save(@"..\..\Book.xml");
2.使用XmlTextReader和XmlTextWriter
XmlTextReader和XmlTextWriter是以流的形式来读写XML文件.
2.1XmlTextReader
使用XmlTextReader读取数据的时候,首先创建一个流,然后用read()方法来不断的向下读,根据读取的结点的类型来进行相应的操作.如下:
1: XmlTextReader reader = new XmlTextReader(@"..\..\Book.xml");
2: List<BookModel> modelList = new List<BookModel>();
3: BookModel model = new BookModel();
4: while (reader.Read())
5: {
6:
7: if (reader.NodeType == XmlNodeType.Element)
8: {
9: if (reader.Name == "book")
10: {
11: model.BookType = reader.GetAttribute(0);
12: model.BookISBN = reader.GetAttribute(1);
13: }
14: if (reader.Name == "title")
15: {
16: model.BookName=reader.ReadElementString().Trim();
17: }
18: if (reader.Name == "author")
19: {
20: model.BookAuthor = reader.ReadElementString().Trim();
21: }
22: if (reader.Name == "price")
23: {
24: model.BookPrice = Convert.ToDouble(reader.ReadElementString().Trim());
25: }
26: }
27:
28: if (reader.NodeType == XmlNodeType.EndElement)
29: {
30: modelList.Add(model);
31: model = new BookModel();
32: }
33:
34:
35: }
36: modelList.RemoveAt(modelList.Count-1);
37: this.dgvBookInfo.DataSource = modelList;
关键是读取属性的时候,你要先知道哪一个结点具有几个属性,然后通过GetAttribute方法来读取.读取属性还可以用另外一种方法,就是用MoveToAttribute方法.可参见下面的代码:
1: if (reader.Name == "book")
2: {
3: for (int i = 0; i < reader.AttributeCount; i++)
4: {
5: reader.MoveToAttribute(i);
6: string str = "属性:" + reader.Name + "=" + reader.Value;
7: }
8: model.BookType = reader.GetAttribute(0);
9: model.BookISBN = reader.GetAttribute(1);
10: }
效果如下:
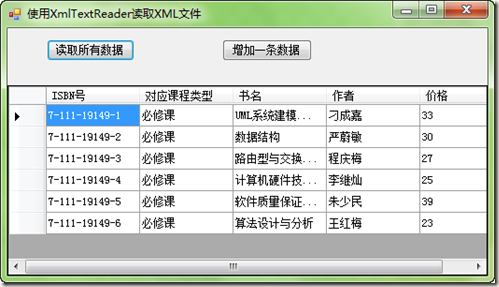
2.2XmlTextWriter
XmlTextWriter写文件的时候,默认是覆盖以前的文件,如果此文件名不存在,它将创建此文件.首先设置一下,你要创建的XML文件格式,
1: XmlTextWriter myXmlTextWriter = new XmlTextWriter(@"..\..\Book1.xml", null);
2: //使用 Formatting 属性指定希望将 XML 设定为何种格式。 这样,子元素就可以通过使用 Indentation 和 IndentChar 属性来缩进。
3: myXmlTextWriter.Formatting = Formatting.Indented;
然后可以通过WriteStartElement和WriteElementString方法来创建元素,这两者的区别就是如果有子结点的元素,那么创建的时候就用WriteStartElement,然后去创建子元素,创建完毕后,要调用相应的WriteEndElement来告诉编译器,创建完毕,用WriteElementString来创建单个的元素,用WriteAttributeString来创建属性.如下:
1: XmlTextWriter myXmlTextWriter = new XmlTextWriter(@"..\..\Book1.xml", null);
2: //使用 Formatting 属性指定希望将 XML 设定为何种格式。 这样,子元素就可以通过使用 Indentation 和 IndentChar 属性来缩进。
3: myXmlTextWriter.Formatting = Formatting.Indented;
4:
5: myXmlTextWriter.WriteStartDocument(false);
6: myXmlTextWriter.WriteStartElement("bookstore");
7:
8: myXmlTextWriter.WriteComment("记录书本的信息");
9: myXmlTextWriter.WriteStartElement("book");
10:
11: myXmlTextWriter.WriteAttributeString("Type", "选修课");
12: myXmlTextWriter.WriteAttributeString("ISBN", "111111111");
13:
14: myXmlTextWriter.WriteElementString("author","张三");
15: myXmlTextWriter.WriteElementString("title", "职业生涯规划");
16: myXmlTextWriter.WriteElementString("price", "16.00");
17:
18: myXmlTextWriter.WriteEndElement();
19: myXmlTextWriter.WriteEndElement();
20:
21: myXmlTextWriter.Flush();
22: myXmlTextWriter.Close();
3.使用Linq to XML.
Linq是C#3.0中出现的一个新特性,使用它可以方便的操作许多数据源,也包括XML文件.使用Linq操作XML文件非常的方便,而且也比较简单.下面直接看代码,
1: private void showInfoByElements(IEnumerable<XElement> elements)
2: {
3: List<BookModel> modelList = new List<BookModel>();
4: foreach (var ele in elements)
5: {
6: BookModel model = new BookModel();
7: model.BookAuthor = ele.Element("author").Value;
8: model.BookName = ele.Element("title").Value;
9: model.BookPrice = Convert.ToDouble(ele.Element("price").Value);
10: model.BookISBN=ele.Attribute("ISBN").Value;
11: model.BookType=ele.Attribute("Type").Value;
12:
13: modelList.Add(model);
14: }
15: dgvBookInfo.DataSource = modelList;
16: }
3.1读取所有的数据
直接找到元素为book的这个结点,然后遍历读取所有的结果.
1: private void btnReadAll_Click(object sender, EventArgs e)
2: {
3: XElement xe = XElement.Load(@"..\..\Book.xml");
4: IEnumerable<XElement> elements = from ele in xe.Elements("book")
5: select ele;
6: showInfoByElements(elements);
7: }
3.2插入一条数据
1: private void btnInsert_Click(object sender, EventArgs e)
2: {
3: XElement xe = XElement.Load(@"..\..\Book.xml");
4: XElement record = new XElement(
5: new XElement("book",
6: new XAttribute("Type", "选修课"),
7: new XAttribute("ISBN","7-111-19149-1"),
8: new XElement("title", "计算机操作系统"),
9: new XElement("author", "7-111-19149-1"),
10: new XElement("price", 28.00)));
11: xe.Add(record);
12: xe.Save(@"..\..\Book.xml");
13: MessageBox.Show("插入成功!");
14: btnReadAll_Click(sender, e);
15: }
3.3 删除选中的数据
首先得到选中的那一行,通过ISBN号来找到这个元素,然后用Remove方法直接删除,如下:
1: private void btnDelete_Click(object sender, EventArgs e)
2: {
3: if (dgvBookInfo.CurrentRow != null)
4: {
5: //dgvBookInfo.CurrentRow.Cells[1]对应着ISBN号
6: string id = dgvBookInfo.CurrentRow.Cells[1].Value.ToString();
7: XElement xe = XElement.Load(@"..\..\Book.xml");
8: IEnumerable<XElement> elements = from ele in xe.Elements("book")
9: where (string)ele.Attribute("ISBN") == id
10: select ele;
12: {
11: if (elements.Count() > 0)
13: elements.First().Remove();
14: }
15: xe.Save(@"..\..\Book.xml");
16: MessageBox.Show("删除成功!");
17: btnReadAll_Click(sender, e);
18:
19: }
20: }
3.4 删除所有的数据
与上面的类似,选出所有的数据,然后用Remove方法,如下:
1: private void btnDeleteAll_Click(object sender, EventArgs e)
2: {
3: XElement xe = XElement.Load(@"..\..\Book.xml");
4: IEnumerable<XElement> elements = from ele in xe.Elements("book")
5: select ele;
6: if (elements.Count() > 0)
7: {
8: elements.Remove();
9: }
10: xe.Save(@"..\..\Book.xml");
11: MessageBox.Show("删除成功!");
12: btnReadAll_Click(sender, e);
13: }
3.5 修改某一记录
首先得到所要修改的某一个结点,然后用SetAttributeValue来修改属性,用ReplaceNodes来修改结点元素。如下:
1: private void btnSave_Click(object sender, EventArgs e)
2: {
3: XElement xe = XElement.Load(@"..\..\Book.xml");
4: if (dgvBookInfo.CurrentRow != null)
5: {
6: //dgvBookInfo.CurrentRow.Cells[1]对应着ISBN号
7: string id = dgvBookInfo.CurrentRow.Cells[1].Value.ToString();
8: IEnumerable<XElement> element = from ele in xe.Elements("book")
9: where ele.Attribute("ISBN").Value == id
10: select ele;
11: if (element.Count() > 0)
12: {
13: XElement first = element.First();
14: ///设置新的属性
15: first.SetAttributeValue("Type", dgvBookInfo.CurrentRow.Cells[0].Value.ToString());
16: ///替换新的节点
17: first.ReplaceNodes(
18: new XElement("title", dgvBookInfo.CurrentRow.Cells[2].Value.ToString()),
19: new XElement("author", dgvBookInfo.CurrentRow.Cells[3].Value.ToString()),
20: new XElement("price", (double)dgvBookInfo.CurrentRow.Cells[4].Value)
21: );
22: }
23: xe.Save(@"..\..\Book.xml");
24:
25: MessageBox.Show("修改成功!");
26: btnReadAll_Click(sender, e);
27: }
28: }
最终效果如下:
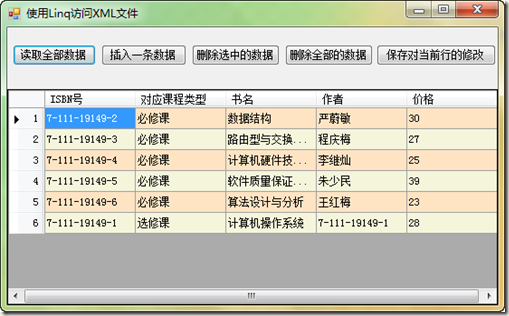
有关Linq to XML的知识大家可以参考LINQ国人首创LINQ专著——《精通LINQ数据访问技术》
这次就写到这了,我个人也在学习,所以如果大家发现错误,敬请批评指正,共同学习。
C#学习笔记(12)——三种方法操作XML的更多相关文章
- MySQL学习笔记:三种组内排序方法
由于MySQ没有提供像Oracle的dense_rank()或者row_number() over(partition by)等函数,来实现组内排序,想实现这个功能,还是得自己想想办法,最终通过创建行 ...
- python学习笔记(三)— 文件操作
对文件的操作分三步: 1.打开文件获取文件的句柄,句柄就理解为这个文件 2.通过文件句柄操作文件 3.关闭文件. 现有以下文件a.txt: 登鹳雀楼 唐代:王之涣 白日依山尽,黄河入海流. 一.文件基 ...
- JavaScript新手学习笔记3——三种排序方式(冒泡排序、插入排序、快速排序)
每种编程语言学到数组的时候,都会讲到排序算法,当时学C语言的时候,卡在排序算法.今天来总结一下javascript中如何实现三种排序算法. 1.冒泡排序(默认升序排列哦) 原理: 冒泡排序的原理,顾名 ...
- TypeScript学习笔记(三) - 方法
本篇将介绍在TypeScript里如何定义和使用方法. 一.方法标准声明和使用 // 方法声明 function func(x: number, y: number): number { return ...
- python学习笔记(三)字典操作和元组操作
字典: 字典也是我们开发过程中最常用的一种数据类型:具有极快的查找速度:字典是一种key-value的数据类型,比如说要存每个人的信息,那么每个人的编号就是key,value就是每个人的信息,这样的话 ...
- Java8学习笔记(三)--方法引入
基本概念 格式 实例变量名 | 类名 :: 静态方法 | 实例方法 作用 简化Lambda表达式 示例 a -> System.out.println(a); <=> System. ...
- java使用Selenium操作谷歌浏览器学习笔记(三)键盘操作
我们用Selenium打开网页后,可能需要在输入框输入一些内容等等,这时候就需要键盘操作了 使用sendKEys进行键盘操作,在bing的搜索框中输入内容并点击跳转 1 import org.open ...
- python学习笔记——(三)文件操作
·集合操作及其相应的操作符表示集合中没有插入,只有添加,因为毕竟无序 #!/usr/bin/env python # -*- coding:utf-8 -*- # Author:Vergil Zhan ...
- Scala学习笔记(三)—— 方法和函数
1. 方法 方法使用 def 定义: def 方法名(参数名:参数列表,…) :返回值类型 = { 方法结构体 } scala> def add(x : Int ,y : Int):Int = ...
随机推荐
- Linux操作系统中文件结构stat中st_size的说明以及对于文件中洞(Holes)的理解
文件stat结构体中st_size成员 对于所有的文件类型,st_size成员对其中的普通文件.目录以及符号链接有实在的意义.其中,对于普通文件而言,st_size记录了该文件的实际大小:对于目录而言 ...
- JAVA RSA私钥 加密(签名) 对应 C# RSA私钥 加密(签名)
非对称密钥RSA算法加解密在C#和Java之间交互的问题,这两天看了很多其他人写的文章,碰到了几个问题,最终解决问题. 参考地址:http://xw-z1985.iteye.com/blog/1837 ...
- Easy APNs Provider 消息推送测试工具
1.Easy APNs Provider 简介 Easy APNs Provider 是一款为 iOS.Mac App 提供推送测试的小工具. App Store 下载地址 Easy APNs Pro ...
- php mysql procedure获取多个结果集
protected function getRs($id) { $db = new mysqli(C("DB_HOST"), C("DB_USER"), C(& ...
- ORA-65179: cannot keep datafiles for a pluggable database that is not unplugged
SQL> drop pluggable database pdb2; drop pluggable database pdb2 * ERROR at line : ORA-: cannot ke ...
- 【转】Google 的眼光
Google 的眼光 你知道吗,Google(Alphabet)要卖掉 Boston Dynamics,一个它收购才没多久的机器人公司.这也意味着,Google 准备完全退出机器人的领域.新闻传言说, ...
- Html5 canvas 绘制彩票走势图
因须要 要实现一个类似彩票走势图的功能,初次学Html5 ,非常多地方不明白,前段时间也发帖请教过这个问题.也是没给个明白说话,在网上搜了非常多,也没有实现的样例,今天细致研究了下.发现事实上也不是非 ...
- 跟我学SharePoint 2013视频培训课程—— 版本控制以及内容审批(14)
课程简介 第14天,怎样在SharePoint 2013中启用版本控制以及内容审批 视频 SharePoint 2013 交流群 41032413
- 手把手教你ranorex_android源码instrument
话说ranorex能把android程序看的透彻,关键是在潜伏,他使用instrumentation,在每个界面(activity)里面,准确的说是onresume,也就是页面显示的时候,都给安装了个 ...
- MIUI 们的发展蓝图:“罪恶”秘密背后的金钱和机遇
(原文来自 AllThingsD) 听起来有点唬人,但是移动变革的确是这个时代最大的一次技术平台升级事件.这场趋势实在太浩大,不断地循环往复,对于创业者(还有像我这样的投资人来说),则意味着令人激 ...