
Elasticsearch IK分词器
Elasticsearch-IK分词器
一、简介
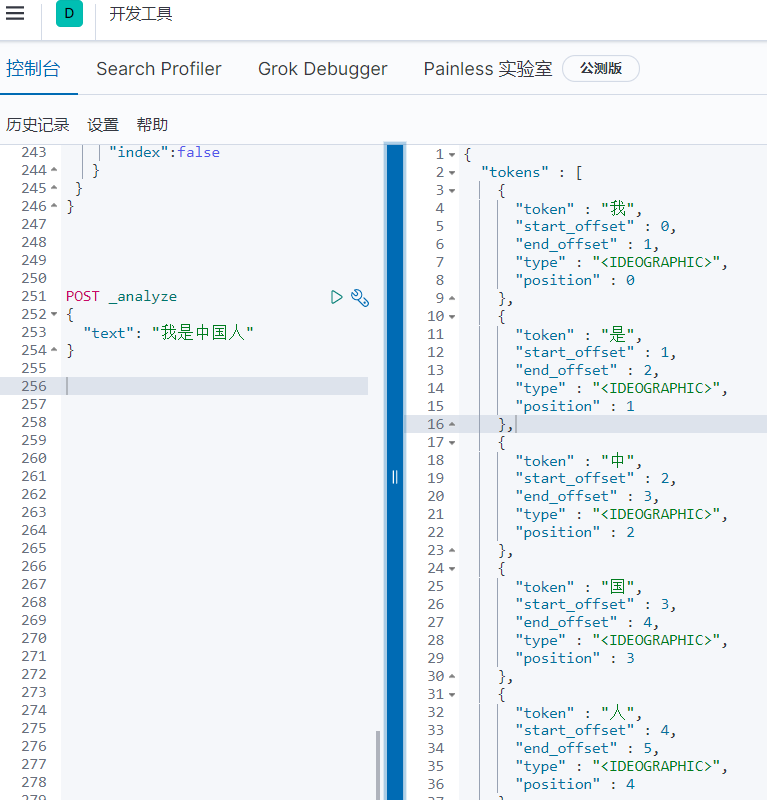
因为Elasticsearch中默认的标准分词器(analyze)对中文分词不是很友好,会将中文词语拆分成一个一个中文的汉字,所以引入中文分词器-IK。
使用默认
二、安装IK分词器
1.先下载ik分词器
注意 一定要下载和Elastic版本相同的IK分词器
2.我们将ik分词器上传到我们的es的plugins/ik目录下,ik文件夹需要我们自己创建
cd /usr/local/elasticsearch/plugins/ik/

unzip elasticsearch-analysis-ik-XX.zip

# windos下安装也是一样的操作
3.重启
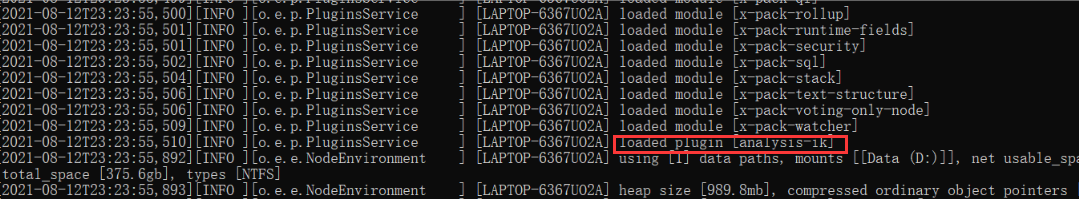
重启的时候在日志中就可以看到关于IK分词器已经被加载进去了
三、测试分词器
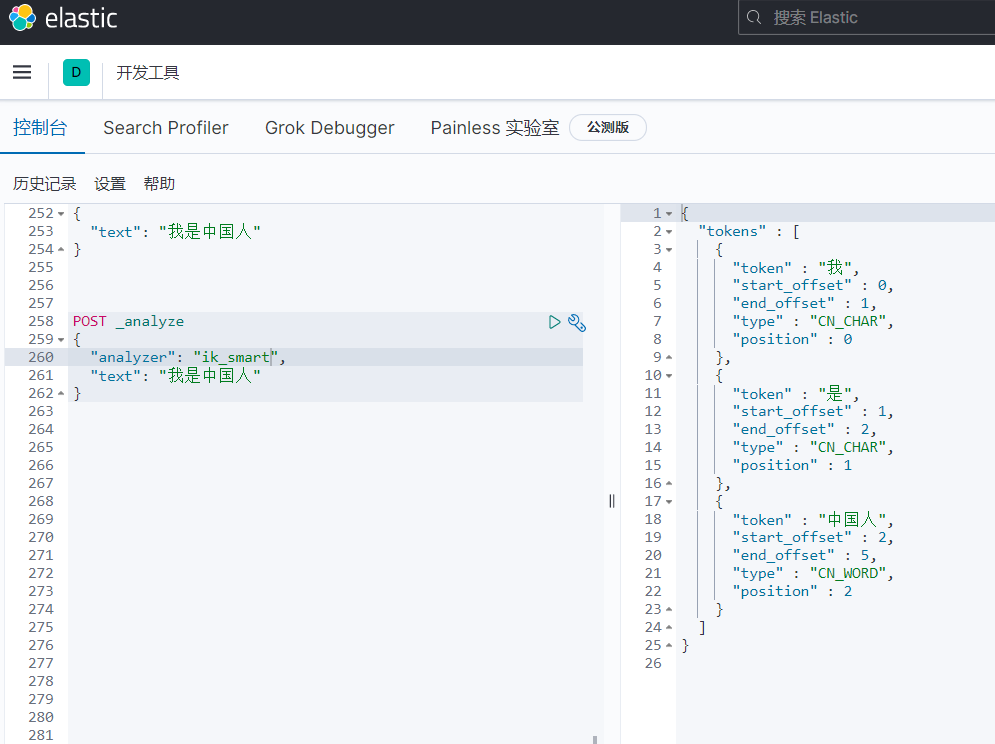
1.ik_smart
会做最粗粒度的拆分,比如会将“我是中国人”拆分为我、是、中国人。
POST _analyze

{

  "analyzer": "ik_smart",

  "text": "我是中国人"

}
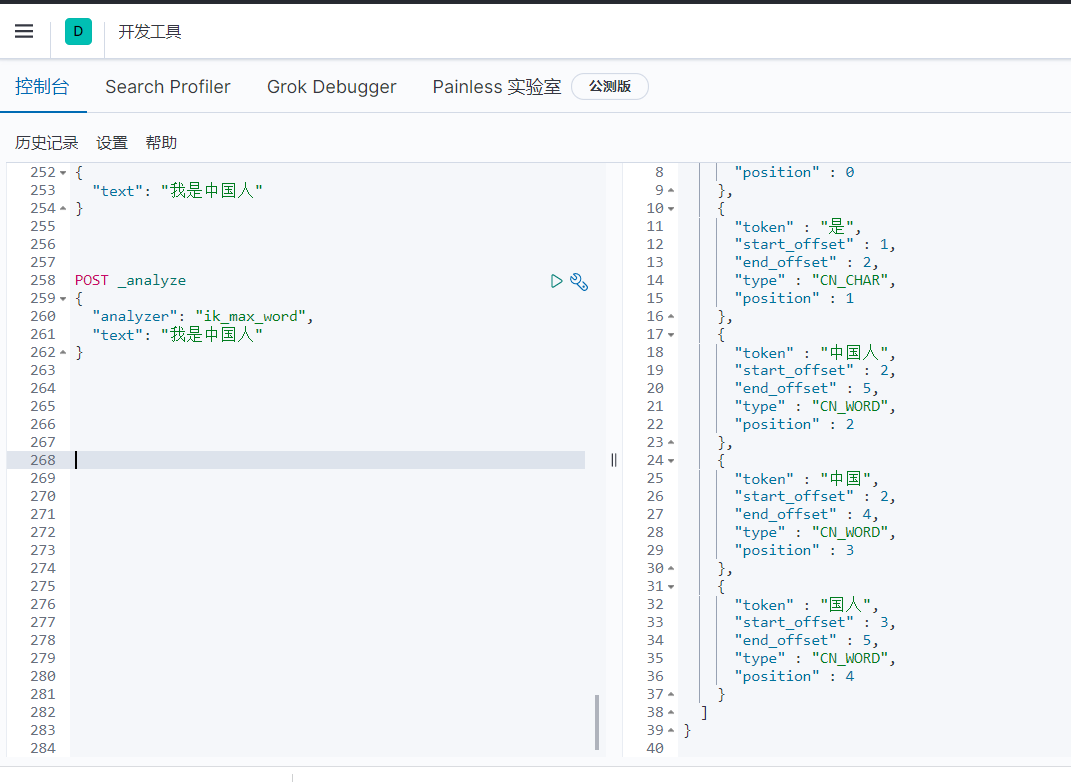
2.ik_max_word
会将文本做最细粒度的拆分,比如会将“我是中国人”拆分为“我、是、中华、中国人、中国、国人
POST _analyze

{

  "analyzer": "ik_max_word",

  "text": "我是中国人"

}
四、自定义词库
使用场景
在利用ik分词的过程中,当ik的分词规则不满足我们的需求了,这个时候就可以利用ik的自定义词库进行匹配,比如最火的常用的网络用语;我们输入乔碧罗殿下正常的情况下,是不会识别整个词语的,返回的都是分开的。我们识别整个词语就需要自定义词库
1、自定义词库方式一(新建dic文件)
(1)到elasticsearch/plugins中寻找ik插件所在的目录
(2)在ik中的config文件中添加词库
创建目录    mkdir ciku

创建文件    vim test.dic

#编辑test.dic 注意每个词语一行
(3)修改ik配置
vim /**/elasticsearch/plugins/ik/config/IKAnalyzer.cfg.xml
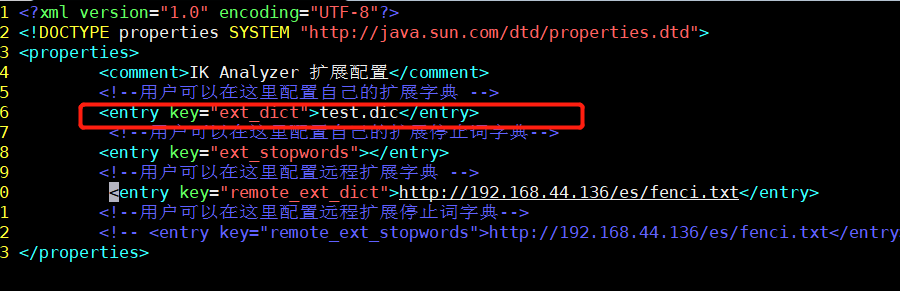
(4)重启ElasticSearch
2、通过Nginx配置自定义词库
(1)安装好nginx,到nginx的html目录下创建分词文件
vim fenci.txt

#每个词语一行
(2)修改ik配置
vim /**/elasticsearch/plugins/ik/config/IKAnalyzer.cfg.xml
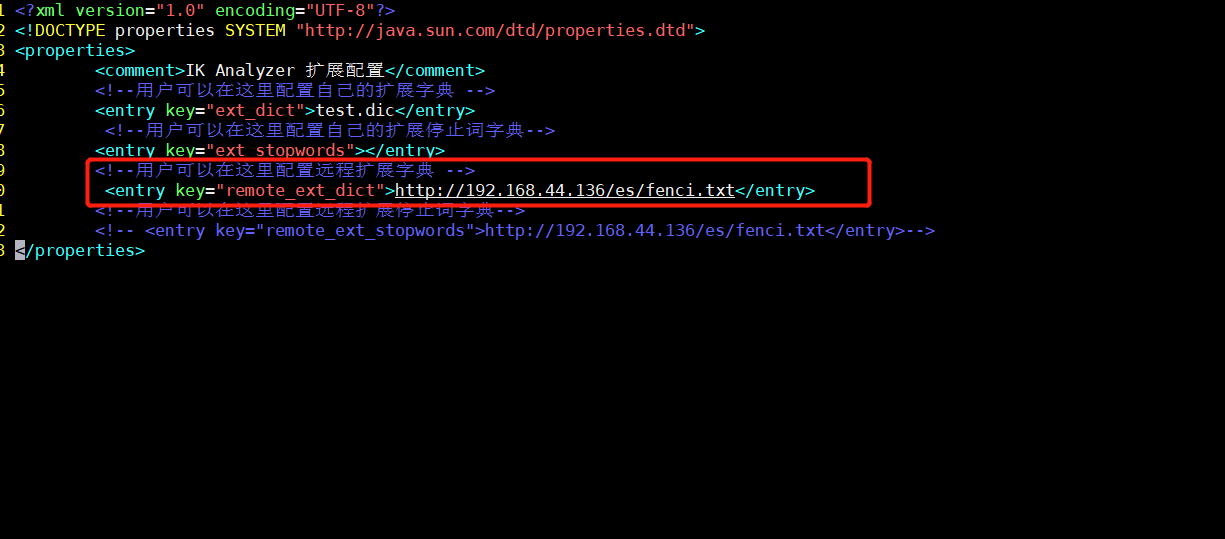
(3)重启ElasticSearch
效果
我们输入乔碧罗殿下正常的情况下,是不会识别整个词语的,返回的都是分开的。当我们在词库文件中写上乔碧罗殿下就会返回下面的效果

Elasticsearch IK分词器的更多相关文章
- SpringBoot整合Elasticsearch+ik分词器+kibana
话不多说直接开整 首先是版本对应,SpringBoot和ES之间的版本必须要按照官方给的对照表进行安装,最新版本对照表如下: (官网链接:https://docs.spring.io/spring-d ...
- 七、Elasticsearch+elasticsearch-head的安装+Kibana环境搭建+ik分词器安装
一.安装JDK1.8 二.安装ES 三个节点:master.slave01.slave02 1.这里下载的是elasticsearch-6.3.1.rpm版本包 https://www.elastic ...
- IK 分词器
目录 IK 分词器-介绍 IK 分词器-安装 环境准备:Maven 安装 IK 分词器 IK 分词器-使用 IK 分词器-介绍 现有问题:ES 默认对中文分词并不友好,实际上是把中文进行了每个字的分词 ...
- Elasticsearch入门之从零开始安装ik分词器
起因 需要在ES中使用聚合进行统计分析,但是聚合字段值为中文,ES的默认分词器对于中文支持非常不友好:会把完整的中文词语拆分为一系列独立的汉字进行聚合,显然这并不是我的初衷.我们来看个实例: POST ...
- docker上安装elasticsearch和ik分词器插件和header,实现分词功能
docker run -di --name=tensquare_es -p 9200: -p 9300:9300 elasticsearch:5.6.8 创建elasticsearch容器(如果版本不 ...
- Elasticsearch下安装ik分词器
安装ik分词器(必须安装maven) 上传相应jar包 解压到相应目录 unzip elasticsearch-analysis-ik-master.zip(zip包) cp -r elasticse ...
- elasticsearch安装ik分词器(极速版)
简介:下面讲有我已经打包并且编辑过的zip包,你可以在下面下载即可. 1.下载zip包.elasticsearch-analysis-ik-1.8.0.jar下面有附件链接[ik-安装包.zip],下 ...
- 【ELK】【docker】【elasticsearch】2.使用elasticSearch+kibana+logstash+ik分词器+pinyin分词器+繁简体转化分词器 6.5.4 启动 ELK+logstash概念描述
官网地址:https://www.elastic.co/guide/en/elasticsearch/reference/current/docker.html#docker-cli-run-prod ...
- ElasticSearch(六):IK分词器的安装与使用IK分词器创建索引
之前我们创建索引,查询数据,都是使用的默认的分词器,分词效果不太理想,会把text的字段分成一个一个汉字,然后搜索的时候也会把搜索的句子进行分词,所以这里就需要更加智能的分词器IK分词器了. 1. i ...
随机推荐
- Defense:SMB协议漏洞利用与控制CVE-2017-7494("永恒之蓝")攻防实验
漏洞描述 1. 服务器打开了文件/打印机共享端口445,让其能够在公网上访问 2. 共享文件拥有写入权限 3. 恶意攻击者需猜解Samba服务端共享目录的物理路径 Samba是在Linux和UNIX系 ...
- spring data jpa执行update和delete语句时报错处理
之前项目中使用spring data jpa时,遇到删除记录的需求时,主要利用spring data中自带的delete()方法处理,最近在dao层使用delete sql语句时报错,代码如下: @Q ...
- C语言:赋值
#include <stdio.h> //=赋值运算符 //具有方向性,只能将赋值号右边的表达式的值给左边的变量 //赋值语句具有计算功能,赋值号右边可以是常量,变量或表达式都可以 //赋 ...
- Java 获取Word批注所标记的文本和图片
[环境配置] 本文将通过Java程序代码来展示如何来获取Word批注所标注的文本和图片.这里使用的Word Jar包工具是Free Spire.Doc for Java,在pom.xml中按如下步骤配 ...
- 【洛谷1339 [USACO09OCT]】热浪Heat Wave 图论+最短路
AC代码 #include<bits/stdc++.h> using namespace std; const int MAXN=62000+10,INF=999999; struct E ...
- 第二篇 -- Django写一个接口并用Jmeter进行测试
第一节学习了Jmeter的下载和安装,那么第二节就来看看具体怎么使用. 本篇介绍的是使用Jmeter进行http接口测试,那么接口程序使用Django开发的一个小接口. 一.Django编写接口 这一 ...
- 第十一篇 -- QMainWindow与QAction(斜体-粗体-下划线)
效果图: ui_mainWindow.py # -*- coding: utf-8 -*- # Form implementation generated from reading ui file ' ...
- shell脚本(12)-特殊变量介绍
一.特殊变量介绍: 1.$* :代表所有参数,其间隔为IFS内参数的第一个字元 2.$@ :与*星号类同,不同之处在于不参照IFS 3.$# :代表参数数量 4.$: 代表上一个指令的返回值 5.$- ...
- 开源低代码平台开发实践二:从 0 构建一个基于 ER 图的低代码后端
前后端分离了! 第一次知道这个事情的时候,内心是困惑的. 前端都出去搞 SPA,SEO 们同意吗? 后来,SSR 来了. 他说:"SEO 们同意了!" 任何人的反对,都没用了,时代 ...
- <题解>[SDOI2017]硬币游戏
solutions 题面(loj) 题面(luogu) 这个题吧是我很久很久以前留下的坑了,到了今天才补好.(是不是太菜了) 暴力 这个和之前的题解一样,确实可以用 trie 树,这复杂度是\(\ma ...