
Elasticsearch——分页查询From&Size VS scroll
Elasticsearch中数据都存储在分片中,当执行搜索时每个分片独立搜索后,数据再经过整合返回。那么,如果要实现分页查询该怎么办呢?
更多内容参考Elasticsearch资料汇总
按照一般的查询流程来说,如果我想查询前10条数据:
- 1 客户端请求发给某个节点
- 2 节点转发给个个分片,查询每个分片上的前10条
- 3 结果返回给节点,整合数据,提取前10条
- 4 返回给请求客户端
那么当我想要查询第10条到第20条的数据该怎么办呢?这个时候就用到分页查询了。
from-size"浅"分页
"浅"分页的概念是小博主自己定义的,可以理解为简单意义上的分页。它的原理很简单,就是查询前20条数据,然后截断前10条,只返回10-20的数据。这样其实白白浪费了前10条的查询。
查询的方法如:
{

    "from" : 0, "size" : 10,

    "query" : {

        "term" : { "user" : "kimchy" }

    }

}
其中,from定义了目标数据的偏移值,size定义当前返回的事件数目。
默认from为0,size为10,即所有的查询默认仅仅返回前10条数据。
做过测试,越往后的分页,执行的效率越低。
通过下图可以看出,刨去一些异常的数据,总体上还是会随着from的增加,消耗时间也会增加。而且数据量越大,效果越明显!
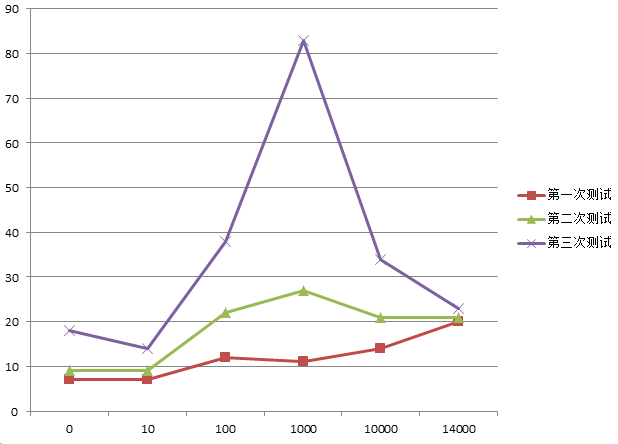
也就是说,分页的偏移值越大,执行分页查询时间就会越长!
scroll“深”分页
相对于from和size的分页来说,使用scroll可以模拟一个传统数据的游标,记录当前读取的文档信息位置。这个分页的用法,不是为了实时查询数据,而是为了一次性查询大量的数据(甚至是全部的数据)。
因为这个scroll相当于维护了一份当前索引段的快照信息,这个快照信息是你执行这个scroll查询时的快照。在这个查询后的任何新索引进来的数据,都不会在这个快照中查询到。但是它相对于from和size,不是查询所有数据然后剔除不要的部分,而是记录一个读取的位置,保证下一次快速继续读取。
API使用方法如:
curl -XGET 'localhost:9200/twitter/tweet/_search?scroll=1m' -d '

{

    "query": {

        "match" : {

            "title" : "elasticsearch"

        }

    }

}

'
会自动返回一个_scroll_id,通过这个id可以继续查询(实际上这个ID会很长哦!):
curl -XGET 'localhost:9200/_search/scroll?scroll=1m&scroll_id=c2Nhbjs2OzM0NDg1ODpzRlBLc0FXNlNyNm5JWUc1'
注意,我在使用1.4版本的ES时,只支持把参数放在URL路径里面,不支持在JSON body中使用。
有个很有意思的事情,细心的会发现,这个ID其实是通过base64编码的:
cXVlcnlUaGVuRmV0Y2g7MTY7MjI3NTp2dFhLSjhsblFJbWRpd2NEdFBULWtBOzIyNzQ6dnRYS0o4bG5RSW1kaXdjRHRQVC1rQTsyMjgwOnZ0WEtKOGxuUUltZGl3Y0R0UFQta0E7MjI4MTp2dFhLSjhsblFJbWRpd2NEdFBULWtBOzIyODM6dnRYS0o4bG5RSW1kaXdjRHRQVC1rQTsyMjgyOnZ0WEtKOGxuUUltZGl3Y0R0UFQta0E7MjI4Njp2dFhLSjhsblFJbWRpd2NEdFBULWtBOzIyODc6dnRYS0o4bG5RSW1kaXdjRHRQVC1rQTsyMjg5OnZ0WEtKOGxuUUltZGl3Y0R0UFQta0E7MjI4NDp2dFhLSjhsblFJbWRpd2NEdFBULWtBOzIyODU6dnRYS0o4bG5RSW1kaXdjRHRQVC1rQTsyMjg4OnZ0WEtKOGxuUUltZGl3Y0R0UFQta0E7MjI3Njp2dFhLSjhsblFJbWRpd2NEdFBULWtBOzIyNzc6dnRYS0o4bG5RSW1kaXdjRHRQVC1rQTsyMjc4OnZ0WEtKOGxuUUltZGl3Y0R0UFQta0E7MjI3OTp2dFhLSjhsblFJbWRpd2NEdFBULWtBOzA7
如果使用解码工具可以看到:
queryThenFetch;16;2275:vtXKJ8lnQImdiwcDtPT-kA;2274:vtXKJ8lnQImdiwcDtPT-kA;2280:vtXKJ8lnQImdiwcDtPT-kA;2281:vtXKJ8lnQImdiwcDtPT-kA;2283:vtXKJ8lnQImdiwcDtPT-kA;2282:vtXKJ8lnQImdiwcDtPT-kA;2286:vtXKJ8lnQImdiwcDtPT-kA;2287:vtXKJ8lnQImdiwcDtPT-kA;2289:vtXKJ8lnQImdiwcDtPT-kA;2284:vtXKJ8lnQImdiwcDtPT-kA;2285:vtXKJ8lnQImdiwcDtPT-kA;2288:vtXKJ8lnQImdiwcDtPT-kA;2276:vtXKJ8lnQImdiwcDtPT-kA;2277:vtXKJ8lnQImdiwcDtPT-kA;2278:vtXKJ8lnQImdiwcDtPT-kA;2279:vtXKJ8lnQImdiwcDtPT-kA;0;
虽然搞不清楚里面是什么内容,但是看到了一堆规则的键值对,总是让人兴奋一下!
测试from&size VS scroll的性能
首先呢,需要在java中引入elasticsearch-jar,比如使用maven:
<dependency>

	<groupId>org.elasticsearch</groupId>

	<artifactId>elasticsearch</artifactId>

	<version>1.4.4</version>

</dependency>
然后初始化一个client对象:
private static TransportClient client;

    private static String INDEX = "index_name";

	private static String TYPE = "type_name";

	public static TransportClient init(){

		Settings settings = ImmutableSettings.settingsBuilder()

				 .put("client.transport.sniff", true)

				 .put("cluster.name", "cluster_name")

				 .build();

		client = new TransportClient(settings).addTransportAddress(new InetSocketTransportAddress("localhost",9300));

		return client;

	}

    public static void main(String[] args) {

    	TransportClient client = init();

        //这样就可以使用client执行查询了

    }
然后就是创建两个查询过程了 ,下面是from-size分页的执行代码:
System.out.println("from size 模式启动!");

Date begin = new Date();

long count = client.prepareCount(INDEX).setTypes(TYPE).execute().actionGet().getCount();

SearchRequestBuilder requestBuilder = client.prepareSearch(INDEX).setTypes(TYPE).setQuery(QueryBuilders.matchAllQuery());

for(int i=0,sum=0; sum<count; i++){

    SearchResponse response = requestBuilder.setFrom(i).setSize(50000).execute().actionGet();

    sum += response.getHits().hits().length;

    System.out.println("总量"+count+" 已经查到"+sum);

}

Date end = new Date();

System.out.println("耗时: "+(end.getTime()-begin.getTime()));
下面是scroll分页的执行代码,注意啊!scroll里面的size是相对于每个分片来说的,所以实际返回的数量是:分片的数量*size
System.out.println("scroll 模式启动!");

begin = new Date();

SearchResponse scrollResponse = client.prepareSearch(INDEX)

    .setSearchType(SearchType.SCAN).setSize(10000).setScroll(TimeValue.timeValueMinutes(1))

    .execute().actionGet();

count = scrollResponse.getHits().getTotalHits();//第一次不返回数据

for(int i=0,sum=0; sum<count; i++){

    scrollResponse = client.prepareSearchScroll(scrollResponse.getScrollId())

        .setScroll(TimeValue.timeValueMinutes(8))

	.execute().actionGet();

    sum += scrollResponse.getHits().hits().length;

    System.out.println("总量"+count+" 已经查到"+sum);

}

end = new Date();

System.out.println("耗时: "+(end.getTime()-begin.getTime()));
我这里总的数据有33万多,分别以每页5000,10000,50000的数据量请求,得到如下的执行时间:
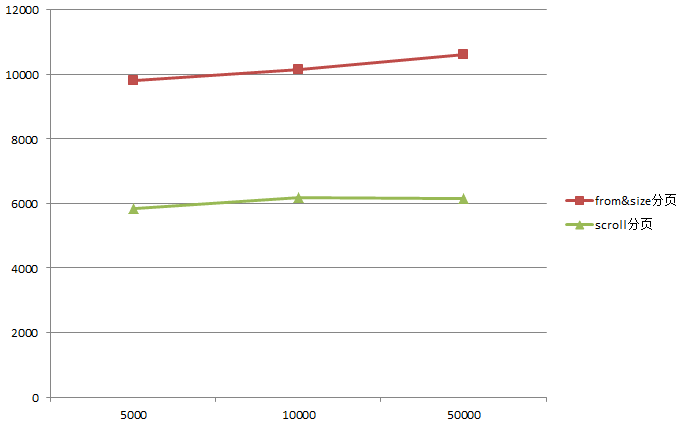
可以看到仅仅30万,就相差接近一倍的性能,更何况是如今的大数据环境...因此,如果想要对全量数据进行操作,快换掉fromsize,使用scroll吧!
参考
1 简书:elasticsearch 的滚动(scroll)
2 16php:Elasticsearch Scroll API详解
3 elastic:from-size查询
4 elastic:scroll query
Elasticsearch——分页查询From&Size VS scroll的更多相关文章
- elasticsearch 分页查询实现方案——Top K+归并排序
elasticsearch 分页查询实现方案 1. from+size 实现分页 from表示从第几行开始,size表示查询多少条文档.from默认为0,size默认为10,注意:size的大小不能超 ...
- ElasticSearch—分页查询
ElasticSearch查询—分页查询详解 Elasticsearch中数据都存储在分片中,当执行搜索时每个分片独立搜索后,数据再经过整合返回.那么,如何实现分页查询呢? 按照一般的查询流程来说,如 ...
- elasticsearch 分页查询实现方案
1. from+size 实现分页 from表示从第几行开始,size表示查询多少条文档.from默认为0,size默认为10, 注意:size的大小不能超过index.max_result_wind ...
- ElasticSearch——分页查询
前言 ElasticSearch实现分页查询,有3种方式,他们在数据查询中各自占据着不同的优势,因此在搜索引擎的数据分页过程中,如何更好地利用各自的优势来进行数据查询是一个非常重要的过程. 传统分页( ...
- Elasticsearch 分页查询
目录 前言 from + size search after scroll api 总结 参考资料 前言 我们在实际工作中,有很多分页的需求,商品分页.订单分页等,在MySQL中我们可以使用limit ...
- Elasticsearch分页查询
global index global CLIENT index = "guajibao-ipused-2019.10.13" CLIENT = Elasticsearch(hos ...
- SpringBoot整合Elasticsearch游标查询(scroll)
游标查询(scroll)简介 scroll 查询 可以用来对 Elasticsearch 有效地执行大批量的文档查询,而又不用付出深度分页那种代价. 游标查询会取某个时间点的快照数据. 查询初始化之后 ...
- elasticsearch查询之大数据集分页查询
一. 要解决的问题 search命中的记录特别多,使用from+size分页,直接触发了elasticsearch的max_result_window的最大值: { "error" ...
- Elasticsearch from/size-浅分页查询-深分页 scroll-深分页search_after深度查询区别使用及应用场景
Elasticsearch调研深度查询 1.from/size 浅分页查询 一般的分页需求我们可以使用from和size的方式实现,但是这种的分页方式在深分页的场景下应该是避免使用的.深分页的页次增加 ...
随机推荐
- 重制AdvanceWars第一步 -- 搞定地图
首先来聊下高级战争吧Advance Wars,由任天堂旗下的Intelligent Systems开发的战棋游戏.初作诞生于GBA上,后来继续跟进了高战2黑洞崛,而后在下一代掌机DS上也出了三代续作高 ...
- [.NET领域驱动设计实战系列]专题六:DDD实践案例:网上书店订单功能的实现
一.引言 上一专题已经为网上书店实现了购物车的功能了,在这一专题中,将继续对网上书店案例进行完善,本专题将对网上书店订单功能的实现进行介绍,现在废话不多说了,让我们来一起看看订单功能是如何实现的吧. ...
- 如何做到在虚拟数据库和真实数据库之间自由切换?【低调赠送:QQ高仿版GG 4.4 最新源码】
记得以前在公司上班时,有时候白天的活没干完,我就会把工作带回家晚上加班继续做.但是,我们开发用的数据库是部署在公司局网内部的一台服务器上的,在家里是肯定连不上这台机器的.在家里没有数据库,服务端就跑不 ...
- Android和Linux应用综合对比分析
原文地址:http://www.cnblogs.com/beer/p/3325242.html 免责声明: 当时写完这篇调查报告,给同事看了后,他觉得蛮喜欢,然后想把这篇文章修改一下,然后往期刊上发表 ...
- 原创教程:《metasploit新手指南》介绍及下载
原创教程:<metasploit新手指南>介绍及下载 1.1 作者简介 这份教程并不是“玄魂工作室”原创,但是我还是要力推给大家.相比那些一连几年都在问“我怎么才能入门”的人而言,我们更欣 ...
- 一个简单的通用Makefile实现
一个简单的通用Makefile实现 Makefile是Linux下程序开发的自动化编译工具,一个好的Makefile应该准确的识别编译目标与源文件的依赖关系,并且有着高效的编译效率,即每次重新ma ...
- 如何在CRM系统中集成ActiveReports最终报表设计器
有时候,将ActiveReports设计器集成到业务系统中,为用户提供一些自定义的数据表,用户不需要了解如何底层的逻辑关系和后台代码,只需要选择几张关联的数据表,我们会根据用户的选择生成可供用户直接使 ...
- 缓存篇(Cache)~第二回 使用static静态成员实现服务器端缓存(导航面包屑)~续
返回目录 在写完首篇cache文章后,有些朋友给我来信,希望可以使用JS的方法来实现这个导航功能,所以,才有了这篇文章,JS与C#不同,它虽然有引用类型,但它不具备一些引用类型的特性,如它的方法参数为 ...
- Atitit 面向对象 封装的实现原理
Atitit 面向对象 封装的实现原理 1.1. 动态对象的模拟使用map+函数接口可以实现1 1.2. 在用结构体 + 函数指针 模拟 对象 1 1.3. This指针..1 1.4. " ...
- Atitit截屏功能的设计解决方案
Atitit截屏功能的设计解决方案 自己实现.... 使用快捷键.. 弹出自己的win,,背景是屏幕快照 点击鼠标光标变成十字状态 出现截屏窗口调整截屏窗口位置与大小 释放鼠标,三个btn,, 复制 ...