
spark基础---->spark的第一个程序
这里面我们介绍一下spark的安装,并通过一个python的例子来简单的体会一下spark的使用。
spark的安装与使用
安装环境:mac 10.13.6,spark版本:2.3.1,python版本:3.6.5
一、在mac上面安装spark和pyspark,可以使用brew包管理器安装。直接运行命令
> brew install apache-spark

> pip install pyspark
二、通过start-master启动我们的集群
> ./start-master.sh

然后我们访问:http://localhost:8080/,就可以看到集群相关的信息。
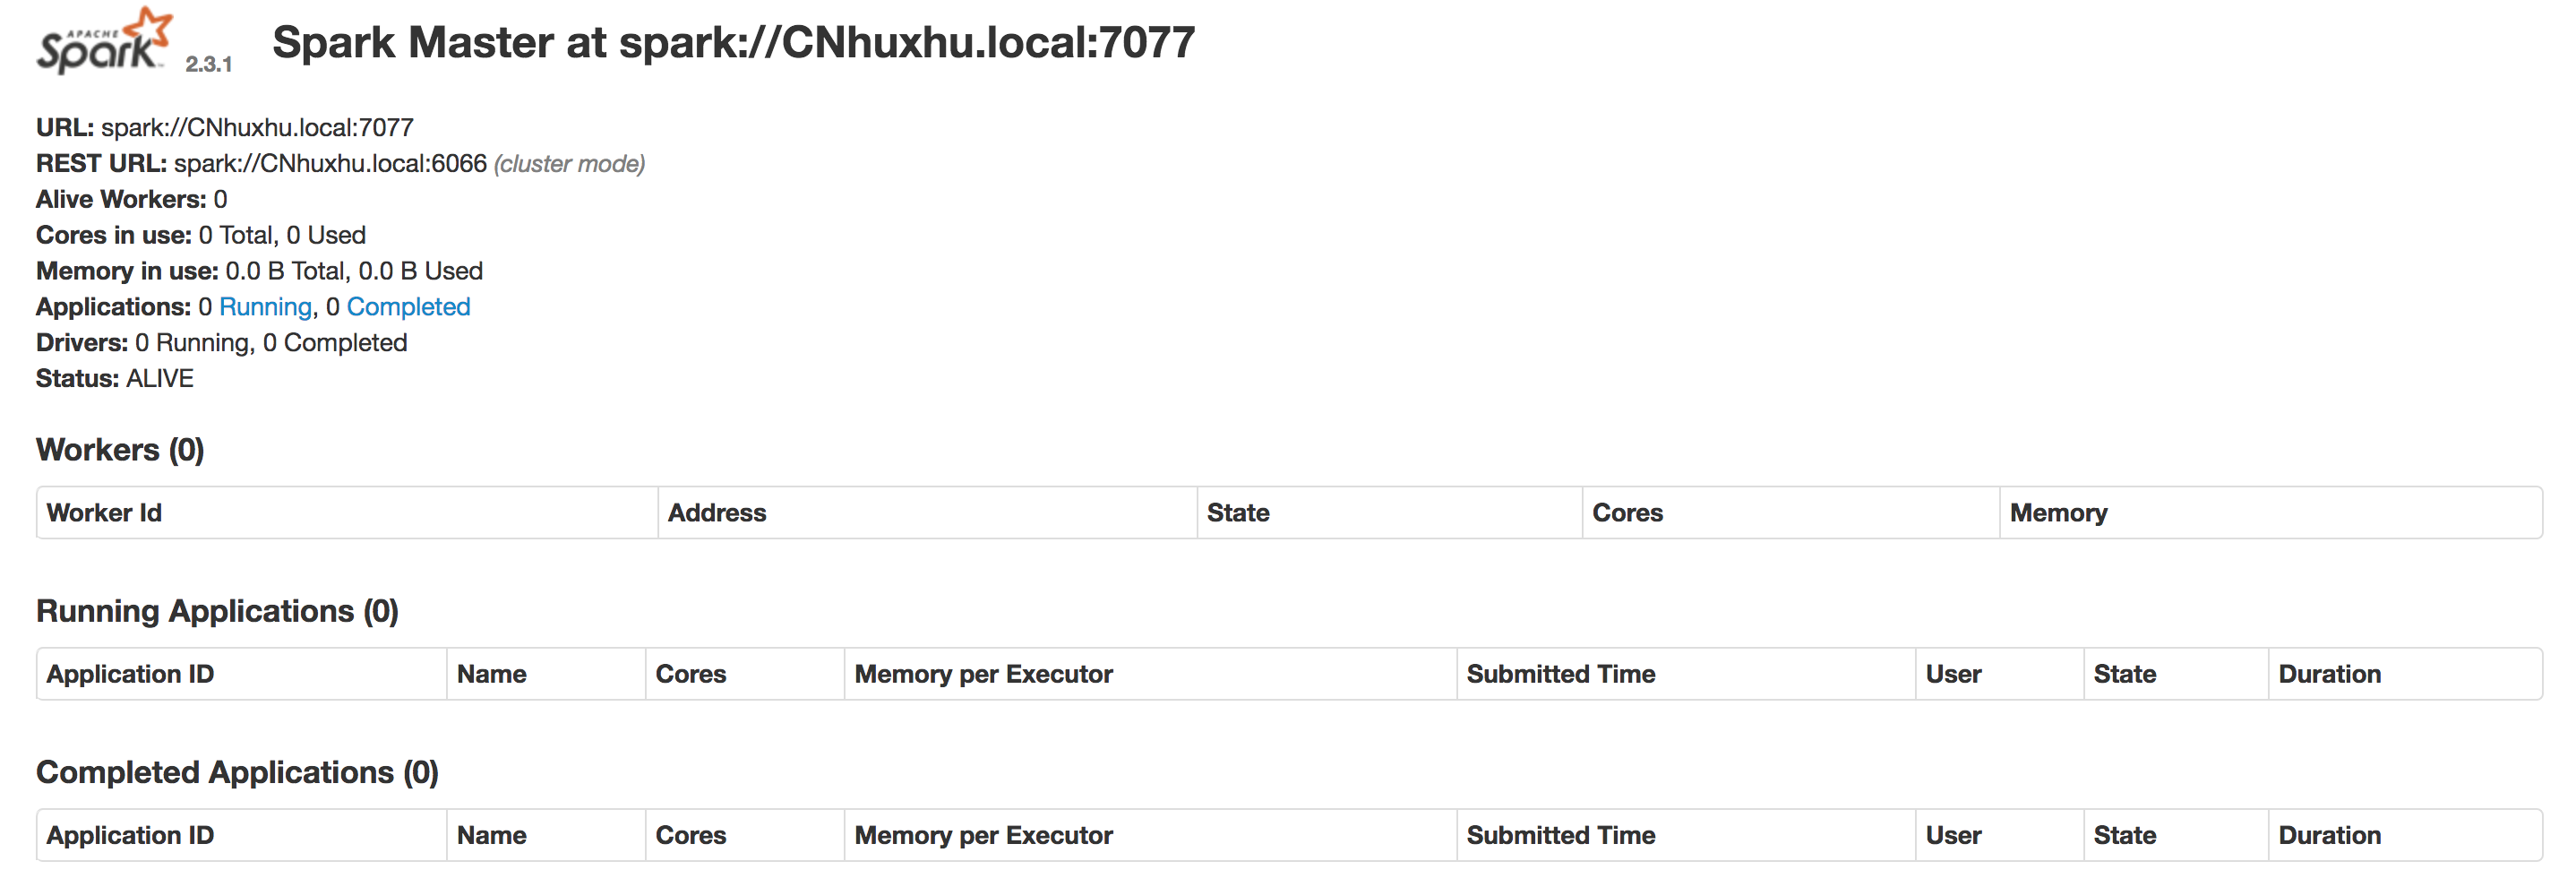
三、启动我们的worker。
> ./start-slave.sh spark://CNhuxhu.local:7077

再次访问http://localhost:8080/,可以在workers里面看到我们启动的worker信息。

四、编写我们的第一个spark的python程序
from pyspark import SparkContext, SparkConf

conf = SparkConf().setAppName("FirstApp").setMaster("spark://CNhuxhu.local:7077")

sc = SparkContext(conf=conf)

lines = sc.textFile('/usr/local/Cellar/apache-spark/2.3.1/README.md')

print('counts = ', lines.count())
五、提交到spark中处理
spark-submit --master local[4] simpleSpark.py
可以在控制台看到如下的打印信息:
counts = 103
程序中遇到的一些问题
一、运行程序报以下的错误
py4j.protocol.Py4JJavaError: An error occurred while calling z:org.apache.spark.api.python.PythonRDD.collectAndServe.
这是由于我们的mac本地安装的java版本有jdk8和jdk10,但是默认的是jdk10。spark2.3.1要求的jdk版本是1.8,所以修改系统的jdk版本问题解决。vim ~/.zshrc,添加以下内容
export JAVA_HOME=/Library/Java/JavaVirtualMachines/jdk1.8.0_162.jdk/Contents/Home
二、查看系统安装jdk的java_home命令
usr/libexec/java_home -V
可以查看系统安装的所有java以及JAVA_HOME的信息
Matching Java Virtual Machines (2):

    10.0.2, x86_64:    "Java SE 10.0.2"    /Library/Java/JavaVirtualMachines/jdk-10.0.2.jdk/Contents/Home

    1.8.0_162, x86_64:    "Java SE 8"    /Library/Java/JavaVirtualMachines/jdk1.8.0_162.jdk/Contents/Home

/Library/Java/JavaVirtualMachines/jdk-10.0.2.jdk/Contents/Home
三、以下是一个java版本的spark程序
项目是由maven构建的,在pom.xml添加所需的依赖。
<dependency> <!-- Spark dependency -->

    <groupId>org.apache.spark</groupId>

    <artifactId>spark-sql_2.11</artifactId>

    <version>2.3.1</version>

</dependency>
我们编写的java代码如下:
package com.linux.huhx;

import org.apache.spark.sql.Dataset;

import org.apache.spark.sql.SparkSession;

/**

 * user: huxhu

 * date: 2018/8/11 3:40 PM

 **/

public class SimpleSpark {

    public static void main(String[] args) {

        String logFile = "/usr/local/Cellar/apache-spark/2.3.1/README.md"; // Should be some file on your system

        SparkSession spark = SparkSession.builder().appName("Simple Application").getOrCreate();

        Dataset<String> logData = spark.read().textFile(logFile).cache();

        long numAs = logData.filter(s -> s.contains("a")).count();

        long numBs = logData.filter(s -> s.contains("b")).count();

        System.out.println("Lines with a: " + numAs + ", lines with b: " + numBs);

        spark.stop();

    }

}
mvn package打包项目,在target目录下生成可执行的sparkLearn-1.0-SNAPSHOT.jar文件。最后执行spark-submit命令
spark-submit --class "com.linux.huhx.SimpleSpark" --master local[] target/sparkLearn-1.0-SNAPSHOT.jar
可以在控制台看到如下的日志打印
Lines with a: 61, lines with b: 30
友情链接
spark基础---->spark的第一个程序的更多相关文章
- Java 零基础跑起第一个程序
Java 零基础跑起第一个程序 一 概述 1 java代码编译 编译后才干在计算机中执行.编译就是把人能看懂的代码转换成机器能看懂的形式 2 java的长处 一次编译.到处执行.由于java代码是在 ...
- Spark基础学习精髓——第一篇
Spark基础学习精髓 1 Spark与大数据 1.1 大数据基础 1.1.1 大数据特点 存储空间大 数据量大 计算量大 1.1.2 大数据开发通用步骤及其对应的技术 大数据采集->大数据预处 ...
- C#基础知识-编写第一个程序(二)
通过上一篇数据类型已经介绍了C#中最基本的15种预定义数据类型,了解每一种类型代表的数据以及每种类型的取值范围,这是很重要也是最基本.下面我们通过实例来了解每个类型如何去使用.编写C#程序时我们需要用 ...
- Go基础---->go的第一个程序
今天我们学习搭建一个学习go语言的开发环境. Go语言 一.下载go 下载地址:https://golang.org/dl/ 校验下载,在命令行输入go version 二.编写第一个hello wo ...
- cocos2dx基础篇(2) 第一个程序
[本节内容] 1.程序的基本组成:CCSprite(精灵).CCLayer(层).CCScene(场景).CCDirector(导演) 2.分析HelloWorld源码. 一.基本组成 cocos2d ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- Spark菜鸟学习营Day5 分布式程序开发
Spark菜鸟学习营Day5 分布式程序开发 这一章会和我们前面进行的需求分析进行呼应,完成程序的开发. 开发步骤 分布式系统开发是一个复杂的过程,对于复杂过程,我们需要分解为简单步骤的组合. 针对每 ...
- spark基础知识
1.Spark是什么? UCBerkeley AMPlab所开源的类HadoopMapReduce的通用的并行计算框架. dfsSpark基于mapreduce算法实现的分布式计算,拥有HadoopM ...
- spark基础知识介绍(包含foreachPartition写入mysql)
数据本地性 数据计算尽可能在数据所在的节点上运行,这样可以减少数据在网络上的传输,毕竟移动计算比移动数据代价小很多.进一步看,数据如果在运行节点的内存中,就能够进一步减少磁盘的I/O的传输.在spar ...
随机推荐
- Hyperledger超级账本在Centos7下搭建运行环境
超级账本(hyperledger)是Linux基金会于2015年发起的推进区块链数字技术和交易验证的开源项目,加入成员包括:荷兰银行(ABN AMRO).埃森哲(Accenture)等十几个不同利益体 ...
- 用PHP纯手工打造会动的多帧GIF图片验证码
效果演示: http://pcik.7di.net/pcik_reg 百度的效果演示: https://passport.baidu.com/cgi-bin/genimage?captchaservi ...
- linux,日志查找技巧
1.查询日志中含有某个关键字的信息 cat app.log |grep 'error' 2.查询日志尾部最后10行的日志 tail -n 10 app.log 3.查询10行之后的所有日志 tail ...
- MongoDB副本集配置系列七:MongoDB oplog详解
1:oplog简介 oplog是local库下的一个固定集合,Secondary就是通过查看Primary 的oplog这个集合来进行复制的.每个节点都有oplog,记录这从主节点复制过来的信息,这样 ...
- oracle 11g 安装及netca,dbca乱码之解决
在中文Linux下安装Oracle 11g,运行runInstaller后默认会出现乱码,解决办法如下: 1.准备字体zysong.ttf,点击下载,解压下载到的fallback 2.使用归档管理器打 ...
- SQL Server 数据库基础笔记分享(上)
前言 本文是个人学习SQL Server 数据库时的以往笔记的整理,内容主要是对数据库的基本增删改查的SQL语句操作和约束,视图,存储过程,触发器的基本了解. 注:内容比较基础,适合入门者对SQL S ...
- oracle登陆提示“ora-01031 insufficient privileges”
本机装了服务端的oracle11.2g,一直没用,中间换过系统的登陆用户.今早发现登陆数据库时发现老提示“ora-01031 insufficient privileges”,以为监听没配置好,试过了 ...
- 全面理解Javascript闭包和闭包的几种写法及用途【转】
一.什么是闭包和闭包的几种写法和用法 1.什么是闭包 闭包,官方对闭包的解释是:一个拥有许多变量和绑定了这些变量的环境的表达式(通常是一个函数),因而这些变量也是该表达式的一部分.闭包的特点: 1. ...
- [Big Data - Kafka] Kafka设计解析(五):Kafka Benchmark
性能测试及集群监控工具 Kafka提供了非常多有用的工具,如Kafka设计解析(三)- Kafka High Availability (下)中提到的运维类工具——Partition Reassign ...
- python os详解
1.os.getcwd()--起始执行目录 获取当前执行程序文件所在的目录,需要注意的是,getcwd不是获取代码所在文件的目录,也不是获取执行文件所在的目录,而是起始执行目录. 目录结构: test ...