一,sql_trace的作用:用以描述SQL的执行过程的trace输出。

     - SQL是如何操作数据的
     - SQL执行过程中产生了哪些等待事件
     - SQL执行中消耗了多少资源
     - SQL的实际执行计划
     - SQL产生的递归语句
 
二,set autotrace 与 sql_trace的区别
     set autotrace用于输出优化器产生的执行计划,执行计划展示的资源消耗情况是CBO的估算值,并不一定是SQL实际执行时资源消耗情况。比如,向表t中插入10万条数据,执行查询的时候发现只返回少量数据,这可能就是表t还没有被Oracle重分析,它并不知道表的数据已更新。
     sql_trace是SQL实际的执行情况。
 
三,何时使用set autotrace 与 sql_trace
     当需要分析执行计划及CBO行为时,使用set autotrace;当要看一条SQL的真实运行效果时,使用sql_trace。
 
四,sql_trace的使用
     (1)收集本回话的SQL执行过程
     SQL>alter session set sql_trace=true
     SQL>alter session set statistics_level =all;          
     SQL>alter session set timed_statistics = true;          
     SQL>alter session set max_dump_file_size = unlimited;
     SQL>alter session set tracefile_identifier = liangjian
     SQL>sql.....
     SQL>alter session set sql_trace=false
     SQL>exit                         
 
     (2)收集其它会话的SQL执行过程
     SQL1>select sid, serial# from v$session;                                                            
     SQL2>execute  dbms_system.set_sql_trace_in_session(sid, serial#, true);           
     SQL2>sql....
     SQL2>execute  dbms_system.set_sql_trace_in_session(sid, serial#, false); 
 
五,trace文件内容
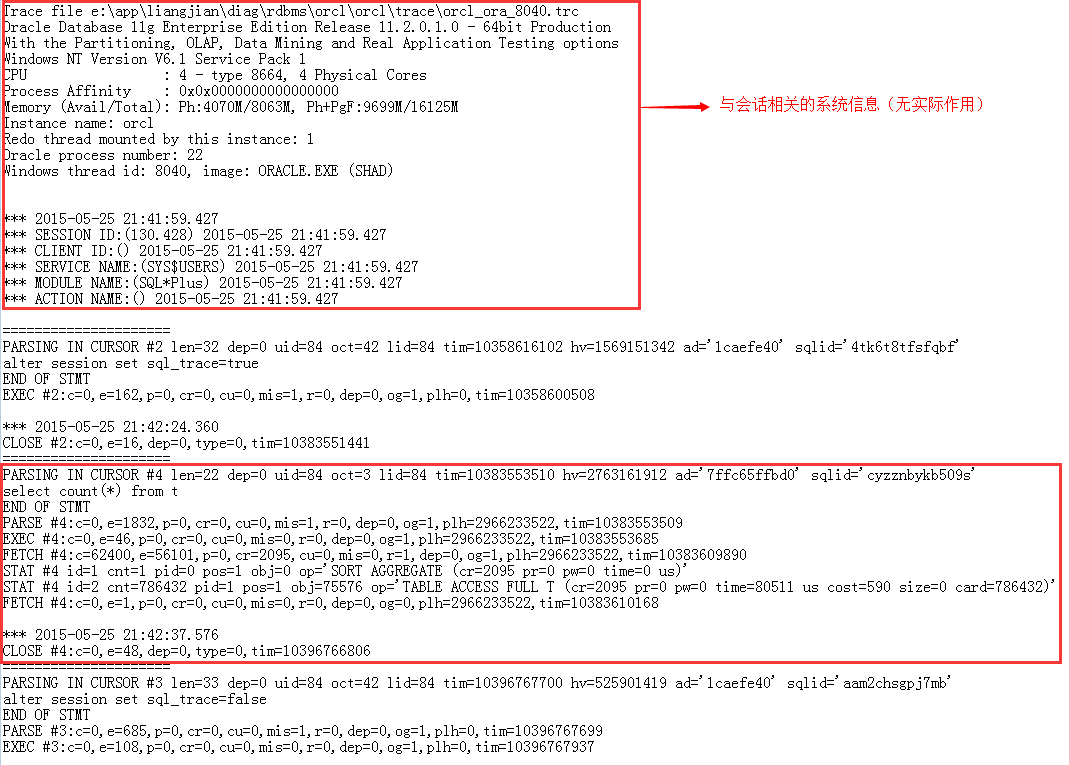
     生成的trace文件的目录由参数文件指定,可以通过v$diag_info视图来查看,name=Default Trace File的值就是trace文件的默认路径。下面是一个实际生成的trace文件:
  
     trace文件内容:
  
     trace文件中记录的是Oracle按照时间先后顺序来输出的,它是Oracle执行SQL最底层的过程。上面第二个红色方框中体现的就是我们所发出SQL执行的过程,其意思是:首先打开一个标号为4的游标,关联这条SQL语句,然后解析这条SQL语句(PARSE #4),其中mis=1表示共享区中没有可共享已解析SQL,故它执行的是一次硬解析,然后执行SQL语句,再然后获取数据,最后关闭游标。有时候游标标号相同的输出并不在一起,因为trace文件是按照时间的先后顺序输出的,这也最能反映Oracle内部的执行顺序。
 
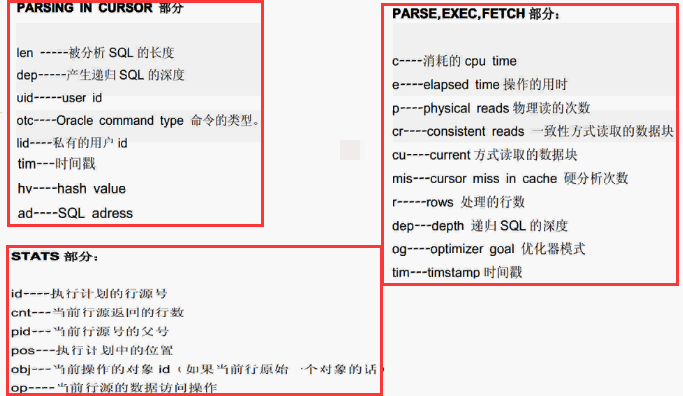
     trace文件中有很多键值对信息,初次看trace文件也一定是看不懂的,下面介绍一下各个键所代表的含义:
     

六,tkprof格式化工具
     trace文件并不直观,为了让读者一目了然,Oracle提供了格式化trace文件的工具:tkprof
(1)tkprof命令
     Usage: tkprof tracefile outputfile [explain= ] [table= ] [print= ] [insert= ] [sys= ] [sort= ]
     参数说明
     tracefile:你要分析的trace文件的绝对路径
     outputfile:格式化后的文件绝对路径
     explain=user/password@connectstring,对每条SQL 语句确定其执行规划,并将执行规划写到输出文件中。如果不是有explain,在trace文件中我们看到的是SQL实际的执行路径,不会有sql的执行计划(可以对比实际执行规划和执行计划的差别)
     table=schema.tablename,在输出到输出文件前,用于存放临时表的用户名和表名。
     PRINT:只列出输出文件的最初N个SQL语句。默认为所有的SQL语句。
     AGGREGATE:如果= NO,则不对多个相同的SQL进行汇总。如果为yes则对trace文件中的相同sql进行合并。
     INSERT:SQL 语句的一种,用于将跟踪文件的统计信息存储到数据库中。在TKPROF创建脚本后,在将结果输入到数据库中。
     SYS:如果设置为yes,则所有sys用户的操作(也包含用户sql语句引发的递归sql),这样可以减少分析出来的文件的复杂度,便于查看。
     sort:对trace文件的sql语句根据需要排序,其中比较有用的一个排序选项是fchela,即按照elapsed time fetching来对分析的结果排序(记住要设置初始化参数timed_statistics=true),生成的文件将把最消耗时间的sql放在最前面显示。
 
     执行计划分为两部分,第一部分称为行源操作(Row Source Operation ),是游标关闭且开启跟踪情况下写到跟踪文件中的执行计划。这意味着如果应用程序不关闭游标而重用它们的话,不会有新的针对重用游标的执行计划写入到跟踪文件中。第二部分,叫做执行计划 (Execution Plan),是由指定了explain参数的TKPROF生成的。既然这是随后生成的,所以和第一部分不一定完全匹配。万一看到两者不一致,前者是正确的。两个执行计划都通过Rows列提供执行计划中每个操作返回的行数(不是处理的--要注意)。 对于每个行源操作来说,可能还会提供如下的运行时统计: 
     cr是一致性模式下逻辑读出的数据块数。
     pr是从磁盘物理读出的数据块数。
     pw是物理写入磁盘的数据块数。
     time是以微秒表示的总的消逝时间。要注意根据统计得到的值不总是精确的。实际上,为了减少开销,可能用了采样。
     cost是操作的评估开销。这个值只有在Oracle 11g才提供。
     size是操作返回的预估数据量(字节数)。这个值只有在Oracle 11g才提供。 
     card是操作返回的预估行数。这个值只有在Oracle 11g才提供。 
 
     输出文件的结尾给出了所有关于跟踪文件的信息。首先可以看到跟踪文件名称、版本号、用于这个分析所使用的参数sort的值。然后,给出了所有会话数量与SQL语句数量。 
     Optimizer mode: ALL_ROWS表示优化器采用的是all_rows的模式
     Parsing user id: 55 表示用户id为55 
 
 
(2)格式化后输出文件的解释
     首先解释输出文件中列的含义:
     CALL:每次SQL语句的处理都分成三个部分
     Parse:这步将SQL语句转换成执行计划,包括检查是否有正确的授权和所需要用到的表、列以及其他引用到的对象是否存在。
     Execute:这步是真正的由Oracle来执行语句。对于insert、update、delete操作,这步会修改数据,对于select操作,这步就只是确定选择的记录。
     Fetch:返回查询语句中所获得的记录,这步只有select语句会被执行。
     COUNT:这个语句被parse、execute、fetch的次数。
     CPU:这个语句对于所有的parse、execute、fetch所消耗的cpu的时间,以秒为单位。
     ELAPSED:这个语句所有消耗在parse、execute、fetch的总的时间。
     DISK:从磁盘上的数据文件中物理读取的块的数量。
     QUERY:在一致性读模式下,所有parse、execute、fetch所获得的buffer的数量。一致性模式的buffer是用于给一个长时间运行的事务提供一个一致性读的快照,缓存实际上在头部存储了状态。
     CURRENT:在current模式下所获得的buffer的数量。一般在current模式下执行insert、update、delete操作都会获取buffer。在current模式下如果在高速缓存区发现有新的缓存足够给当前的事务使用,则这些buffer都会被读入了缓存区中。
     ROWS: 所有SQL语句返回的记录数目,但是不包括子查询中返回的记录数目。对于select语句,返回记录是在fetch这步,对于insert、update、delete操作,返回记录则是在execute这步。
 
(3)trace文件中的性能分析 
     1、如果分析数与执行数之比为1,说明每次执行这个查询都要进行sql解析。如果分析数与执行数之比接近0,则意味着查询执行了很多次软解析,降低了系统的可伸缩性。
     2、如果trace文件中显示对所有或者几乎所有的sql都执行一次,那有可能是因为没有正确使用绑定变量。
     3、如果一个(Fetch Count)/所获得行数的比值接近1,且行数大于1,则应用程序不执行大批量取数操作,每种语言/API都有能力完成这个功能,即一次取多行。如果没有利用这个功能进行批量去,将有可能花费多得多的时间在客户端与服务器端之间来回往返。这个过多的来回转换出了产生很拥挤的网络状况之外,也会比一次调用获得很多行要慢得多,如何指示应用程序进行批量获取将随语言/API而定。
     4、如果CPU时间与elasped时间有巨大差异,意味着有可能花了大量时间在等待某些事情上。如果花了一个CPU时间来执行,但它却总共花了10秒的时间,这就意味着90%的运行时间在等待一个资源。例如被一个会话等待,或者大量查询时的物理IO等待等
     5、较长的CPU或经过时间往往是最消耗资源的sql,需要我们关注
     6、可以通过磁盘IO所占逻辑IO的比例,disk/query+current来判断磁盘IO的情况,太大的话有可能是db_buffer_size过小,当然这也跟SQL的具体特性有关
     7、query+current/rows 平均每行所需的block数,太大的话(超过20)SQL语句效率太低,数据过于分散,可以考虑重组对象
 

SQL执行计划之sql_trace的更多相关文章

  1. Oracle中SQL调优(SQL TUNING)之最权威获取SQL执行计划大全

    该文档为根据相关资料整理.总结而成,主要讲解Oracle数据库中,获取SQL语句执行计划的最权威.最正确的方法.步骤,此外,还详细说明了每种方法中可选项的意义及使用方法,以方便大家和自己日常工作中查阅 ...

  2. Oracle查看SQL执行计划的方式

    Oracle查看SQL执行计划的方式     获取Oracle sql执行计划并查看执行计划,是掌握和判断数据库性能的基本技巧.下面案例介绍了多种查看sql执行计划的方式:   基本有以下几种方式: ...

  3. Atitit sql执行计划

    Atitit sql执行计划 1.1. 首先要搞明白什么叫执行计划? 执行计划是数据库根据SQL语句和相关表的统计信息作出的一个查询方案,这个方案是由查询优化器自动分析产生的 Oracle中的执行计划 ...

  4. 查看SQL执行计划

    一用户进入某界面慢得要死,查看SQL执行计划如下(具体SQL语句就不完全公布了,截断的如下): call     count       cpu    elapsed       disk       ...

  5. 查看Oracle SQL执行计划的常用方式

    在查看SQL执行计划的时候有很多方式 我常用的方式有三种 SQL> explain plan for 2 select * from scott.emp where ename='KING'; ...

  6. sql执行计划解析案例(二)

    sql执行计划解析案例(二)   今天是2013-10-09,本来以前自己在专注oracle sga中buffer cache 以及shared pool知识点的研究.但是在研究cache buffe ...

  7. Oracle之SQL优化专题01-查看SQL执行计划的方法

    在我2014年总结的"SQL Tuning 基础概述"中,其实已经介绍了一些查看SQL执行计划的方法,但是不够系统和全面,所以本次SQL优化专题,就首先要系统的介绍一下查看SQL执 ...

  8. DB查询分析器7.01新增的周、月SQL执行计划功能

                DB查询分析器7.01新增的周.月SQL执行计划功能 马根峰              (广东联合电子服务股份有限公司, 广州 510300) 1      引言   中国本土 ...

  9. SQL优化 MySQL版 -分析explain SQL执行计划与笛卡尔积

    SQL优化 MySQL版 -分析explain SQL执行计划 作者 Stanley 罗昊 [转载请注明出处和署名,谢谢!] 首先我们先创建一个数据库,数据库中分别写三张表来存储数据; course: ...

随机推荐

  1. 如何查看运行的docker container 的 执行 docker run的命令

    前言 就是我备份了一下 mysql_container, 然后我想启用 新的备份的mysql_container 但是之前的docker run image xxxxxx这些都已经忘记了 我想找一下之 ...

  2. tf_upgrade_v2.exe实验

    实验前 import tensorflow as tf import numpy as np #create data x_data=np.random.rand(100).astype(np.flo ...

  3. JMS学习十一(ActiveMQ Consumer高级特性之独有消费者(Exclusive Consumer))

    一.简介 Queue中的消息是按照顺序被分发到consumers的.然而,当你有多个consumers同时从相同的queue中提取消息时, 你将失去这个保证.因为这些消息是被多个线程并发的处理.有的时 ...

  4. centos-系统删除多余网卡的方法

    一.删除系统中中多余的ifcfg-eth0.bak Centos系统更改网卡或网卡MAC地址后会出现个eth0.bak配置备份文件解决方法:/etc/sysconfig/networking/devi ...

  5. 2018-2019-2 网络对抗技术 20165235 Exp 9 Web安全基础

    实验任务 本实践的目标理解常用网络攻击技术的基本原理,做不少于7个题目,共3.5分.包括(SQL,XSS,CSRF).Webgoat实践下相关实验. 基础问题回答 (1)SQL注入攻击原理,如何防御 ...

  6. 百度编辑器ueditor上传图片失败,显示上传错误,实际上图片已经传到服务器或者本地

    报错,上传失败,图片没有显示,且调试response没有信息,但是图片已经上传到了本地 这个问题是因为ueditor里面的Upload.class.php里面__construct()方法里面的ico ...

  7. jQuery file upload callback options

    autoUpload By default, files added to the widget are uploaded as soon as the user clicks on the star ...

  8. 506C Mr. Kitayuta vs. Bamboos

    分析 代码 #include<bits/stdc++.h> using namespace std; #define int long long ],h[],now[],cnt[]; in ...

  9. 搜索引擎、邮件营销、微信营销之营销方式大PK

    经常有朋友问到这个问题,关于搜索引擎.邮件营销.微信营销三种网络营销方式的优劣势,用哪种营销方式比较好.下面我们跟随Focussend小编来看看这几种方式的优劣势. 搜索引擎 优势:1.传播速度快:2 ...

  10. Spring获取request、session以及servletContext

    获取request: HttpServletRequest request = ((ServletRequestAttributes) RequestContextHolder.getRequestA ...