
用java api 实现查询 Hive 数据
版本:cdh5.4.7, hive1.1.0
pom文件
         <dependency>

			<groupId>org.apache.hive</groupId>

			<artifactId>hive-jdbc</artifactId>

			<version>1.2.1</version>

		</dependency>

		<dependency>

			<groupId>org.apache.hadoop</groupId>

			<artifactId>hadoop-common</artifactId>

			<version>2.6.0</version>

		</dependency>

		<dependency>

			<groupId>org.apache.hadoop</groupId>

			<artifactId>hadoop-client</artifactId>

			<version>2.6.0</version>

		</dependency>

		<dependency>

			<groupId>org.apache.thrift</groupId>

			<artifactId>libthrift</artifactId>

			<version>0.9.3</version>

		</dependency>
需要先启动的服务有:
./hive --service hiveserver2
./hive --service metastore
java代码:
public static void main(String[] args) {

        String connectionURL = "jdbc:hive2://node11:10000/didu";

        String drivername = "org.apache.hive.jdbc.HiveDriver";

        String username = "";

        String password = "";

        try {

            Class.forName(drivername);

                }

            catch (ClassNotFoundException e)

              {

            // TODO Auto-generated catch block

            e.printStackTrace();

            System.exit(1);

              }

              try {

                Connection con = DriverManager.getConnection(connectionURL, username, password);

                if(con != null)

                {

                System.out.println("Connected");

                    }

                else

                    {

                System.out.println("Not Connected");

                }

                Statement stmt = con.createStatement();

                // select * query

                String sql;

                ResultSet res;

               sql = "select * from u_data limit 10";

               // sql = "show tables";

                System.out.println("Running: " + sql);

                    res = stmt.executeQuery(sql);

                while (res.next())

                {

                      System.out.println(String.valueOf(res.getString(1)) + "\t" + res.getString(2));

                }

                  }

              catch(SQLException se)

              {

                se.printStackTrace();

              }

    }
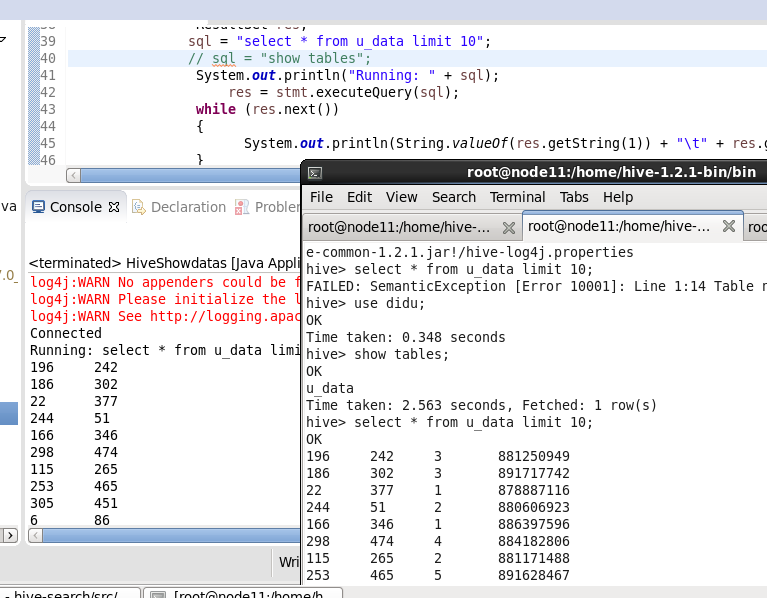
结果展示:
用java api 实现查询 Hive 数据的更多相关文章
- [搜索]ElasticSearch Java Api(一) -添加数据创建索引
转载:http://blog.csdn.net/napoay/article/details/51707023 ElasticSearch JAVA API官网文档:https://www.elast ...
- Elasticsearch java api 常用查询方法QueryBuilder构造举例
转载:http://m.blog.csdn.net/u012546526/article/details/74184769 Elasticsearch java api 常用查询方法QueryBuil ...
- java调用scala 查询hbase数据
问题:将scala打成jar包,提供给java调用,但是java一直提示找不到类 实现功能:利用spark查询hbase数据,然后提供给外部接口调用 我的方式:spark查询Hbase用scala实现 ...
- 通过java api 读取sql 中数据(查询)
配置文件:dbconfig.properties 里面的数据 jdbc.url.jwhat=jdbc\:mysql\://ip\:3306/laibadev?useUnicode\=true& ...
- Java API 实现HBase的数据添加与过滤查询
包依赖比较麻烦,找了好久,我用的CDH5.0 现将所依赖的包的列表清单如下: public class EmployeeDao { /** * @param args */ public static ...
- Java框架-mybatis01查询单个数据
1.什么是mybatis? mybatis是一个基于Java的持久层框架. 2.持久化:数据从瞬时状态变为持久状态. 3.持久层:完成持久化工作的代码块.---dao 4.Mybatis是帮助程序员将 ...
- Elasticsearch java API (23)查询 DSL Geo查询
地理查询编辑 Elasticsearch支持两种类型的地理数据: geo_point纬度/经度对字段的支持,和 geo_shape领域,支持点.线.圆.多边形.多等. 这组查询: geo_shape ...
- 【Java】数据库查询的数据直接以指定文件类型下载到本地(弹出下载框)
欲实现的功能目标:当点击下图的导出数据文件时弹出文件下载框,默认csv格式,用户自定义下载的本地路径 遇到的问题: 1.项目之前做过一次下载,但是是使用了本地文件模板.用输入流读取文件模板,插入数据, ...
- KUDU数据导入尝试一:TextFile数据导入Hive,Hive数据导入KUDU
背景 SQLSERVER数据库中单表数据几十亿,分区方案也已经无法查询出结果.故:采用导出功能,导出数据到Text文本(文本>40G)中. 因上原因,所以本次的实验样本为:[数据量:61w条,文 ...
随机推荐
- excel cannot access the file there are several possible reasons
original link Microsoft Office Excel cannot access the file ‘c:\file.xlsx’. There are several possib ...
- 转 Page Object模式
Page Object模式是Selenium中的一种测试设计模式,主要是将每一个页面设计为一个Class,其中包含页面中需要测试的元素(按钮,输入框,标题 等),这样在Selenium测试页面中可以通 ...
- redis的set()方法参数
redis 127.0.0.1:6379> SET KEY VALUE [EX seconds] [PX milliseconds] [NX|XX] EX seconds − 设置指定的到期 ...
- 8条关于Web前端性能的优化建议
一般网站优化都是优化后台,如接口的响应时间.SQL优化.后台代码性能优化.服务器优化等.高并发情况下,对前端web优化也是非常重要的. 下面说说几种常见的优化措施. 1.HTML CSS JS位置 一 ...
- time模块 datetime 模块 random 模块 OS 模块 sys 模块 hashlib 模块
time模块 在python中的时间表现形式: 时间戳 (自1970-01-01-00-00 到当前时间,按秒计算,一共过了多少秒 格式化时间 返回的是时间的字符串 格式化时间对象 返回的是一个元组 ...
- matplotlib系列——折线图
import numpy as np import matplotlib.pyplot as plt import matplotlib #数据准备 #numpy.linspace(start, st ...
- Java中的动态代理(jdk和cglib)
JAVA的动态代理 代理模式 代理模式是常用的java设计模式,他的特征是代理类与委托类有同样的接口,代理类主要负责为委托类预处理消息.过滤消息.把消息转发给委托类,以及事后处理消息等.代理类与委托类 ...
- etcd注册服务
etcd作为最简单(轻量,精简)的kv服务.etcd可以应用很多方面,但是它有一个特点,etcd只是基础,需要你自己实现功能.它不像其其它组件开箱即用,也正是如此,它足够简单精巧. 回到主题,etcd ...
- CentOS使用手册(二)
前言: 本篇目录: 1.Linux软件安装调试 2.Linux内存.CPU.进程.端口.硬盘管理 3.Linux systemctl管理服务.防火墙firewalld以及SELinux配置 Linux ...
- Windows下搭建kafka
安装JDK,跳过 kafka依赖zookeeper,此处zookeeper安装跳过 http://kafka.apache.org/downloadskafka下载地址 解压文件(我的目录是D:\mi ...