
AdaGrad Algorithm and RMSProp
AdaGrad全称是Adaptive Gradient Algorithm,是标准Gradient Descent的又一个派生算法。标准Gradient Descent的更新公式为:
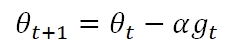
其中Learning Rate α对于Cost Function的各个feature都一样,但同一个α几乎不可能在各个feature上都表现完美,通常为了收敛,会选择较小的α。
而AdaGrad的主要思想是:在各个维度上使用不同的learning rate,从而加快函数收敛的速度。其公式为:
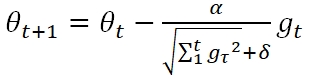
gt是t时刻目标函数的梯度,可以看到,依旧为各个feature设置了统一的α,但是通过历史梯度累计RMS作为分母来调节该learning rate。δ是一个很小的数例如10-7,仅仅为了分母不为0。
如果我们将等式右侧第二项看做一个整体。则标准Gradient Descent是,对t时刻梯度大的feature更新步子大,对t时刻梯度小的feature更新步子小。可以说Gradient Descent是衡量绝对大小的,但AdaGrad则不同,采取了“相对大与相对小”。使用当前时刻的梯度与历史梯度的RMS相比较,如果梯度变缓了,说明快要收敛了,那么步子调整的小一些;而如果梯度突然变大了,那证明参数需要大幅度更新了。
单AdaGrad算法虽然在凸函数(Convex Functions)上表现较好,但在非凸函数上却可能有局限。在深度学习训练中,Cost Function有可能会是很复杂的空间结构,有可能在某些平缓的结构上使用了很小的steps,但在某一时刻却有希望增大步伐。但上式的分母表示,优化的更新步伐和t时刻之前的所有时刻的梯度都相关,所以很有可能当算法希望增大步伐时,更新幅度已经衰减到很小,从而导致优化过程被困在某个局部最优点。
基于此,多大的Hinton教授提出了RMSProp,将AdaGrad和EMA结合起来。将上式分母的部分做成滑动的窗口,通过参数ρ来控制窗口的大小。从而,梯度的“相对大小”参照物,会丢弃遥远的历史,只与相邻窗口内的结构进行比较,来决定更新步幅的大小。梯度的EMA等于:
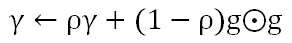
参数更新公式为:
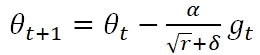
AdaGrad Algorithm and RMSProp的更多相关文章
- L21 Momentum RMSProp等优化方法
airfoil4755 下载 链接:https://pan.baidu.com/s/1YEtNjJ0_G9eeH6A6vHXhnA 提取码:dwjq 11.6 Momentum 在 Section 1 ...
- (转)分布式深度学习系统构建 简介 Distributed Deep Learning
HOME ABOUT CONTACT SUBSCRIBE VIA RSS DEEP LEARNING FOR ENTERPRISE Distributed Deep Learning, Part ...
- (转) An overview of gradient descent optimization algorithms
An overview of gradient descent optimization algorithms Table of contents: Gradient descent variants ...
- 第三十七节、人脸检测MTCNN和人脸识别Facenet(附源码)
在说到人脸检测我们首先会想到利用Harr特征提取和Adaboost分类器进行人脸检测(有兴趣的可以去一看这篇博客第九节.人脸检测之Haar分类器),其检测效果也是不错的,但是目前人脸检测的应用场景逐渐 ...
- An overview of gradient descent optimization algorithms
原文地址:An overview of gradient descent optimization algorithms An overview of gradient descent optimiz ...
- 基于MNIST数据的卷积神经网络CNN
基于tensorflow使用CNN识别MNIST 参数数量:第一个卷积层5x5x1x32=800个参数,第二个卷积层5x5x32x64=51200个参数,第三个全连接层7x7x64x1024=3211 ...
- Momentum
11.6 Momentum 在 Section 11.4 中,我们提到,目标函数有关自变量的梯度代表了目标函数在自变量当前位置下降最快的方向.因此,梯度下降也叫作最陡下降(steepest desce ...
- 第七章:网络优化与正则化(Part1)
任何数学技巧都不能弥补信息的缺失. --科尼利厄斯·兰佐斯(Cornelius Lanczos) 匈牙利数学家.物理学家 文章相关 1 第七章:网络优化与正则化(Part1) 2 第七章:网络优化与正 ...
- RNN 入门教程 Part 4 – 实现 RNN-LSTM 和 GRU 模型
转载 - Recurrent Neural Network Tutorial, Part 4 – Implementing a GRU/LSTM RNN with Python and Theano ...
随机推荐
- Delphi Unicode学习
String.AnsiString及Tbytes之间的转换一.string转为AnsiString1.直接赋值 (有警告)2.AnsiString()类型强制转换.(无警告) 二.AnsiString ...
- Codeforces Manthan, Codefest 19 (open for everyone, rated, Div. 1 + Div. 2)
传送门 A. XORinacci 手玩三四项发现序列就是 $a,b,a\ xor\ b,a,b,...$,直接输出即可 #include<iostream> #include<cst ...
- HDU 1009 FatMouse' Trade题解
版权声明:本文作者靖心,靖空间地址:http://blog.csdn.net/kenden23/.未经本作者同意不得转载. https://blog.csdn.net/kenden23/article ...
- 搜索(BFS)---完美平方数
完美平方数 279. Perfect Squares (Medium) For example, given n = 12, return 3 because 12 = 4 + 4 + 4; give ...
- Vue+elementui 实现复杂表头和动态增加列的二维表格
先上完成的效果图:列是根据查询结果增加的 数据格式: 表头的数据取出: data.data.forEach(element => { this.thead.push({ 品名: element. ...
- Linux延时执行命令at
也许你的Ubuntu没有at命令,先安装 - sudo apt install at 在某时刻执行命令 - at 15:30:回车之后,需要在at后输入指令,表示在15:30要执行的指令 - 比如输入 ...
- IntelliJ IDEA 创建spring boot 的Hello World 项目
1.Open IDEA,choose "New-->Project" 2.Choose "Spring Initializr" 3. Choose jav ...
- 2019-3-9-通过-frp-开启服务器打开本地的-ZeroNet-服务器外网访问
title author date CreateTime categories 通过 frp 开启服务器打开本地的 ZeroNet 服务器外网访问 lindexi 2019-03-09 11:47:4 ...
- 常用Linux Shell命令组合
序号 任务 命令组合 1 删除0字节文件 find . -type f -size 0 -exec rm -rf {} \;find . type f -size 0 -delete 2 查看进程,按 ...
- 03scikit-learn非监督学习
In [1]: from sklearn.decomposition import PCA from sklearn.datasets import load_iris pca = PCA(n_com ...