
LINUX内核分析第六周学习总结——进程的描述和进程的创建
LINUX内核分析第六周学习总结——进程的描述和进程的创建
张忻(原创作品转载请注明出处)
《Linux内核分析》MOOC课程http://mooc.study.163.com/course/USTC-1000029000
一、知识概要
进程的描述
- 进程描述符task_struct数据结构(一)
- 进程描述符task_struct数据结构(二)
进程的创建
- 进程的创建概览及fork一个进程的用户态代码
- 理解进程创建过程复杂代码的方法
- 浏览进程创建过程相关的关键代码
- 创建的新进程是从哪里开始执行的?
- 使用gdb跟踪创建新进程的过程
二、学习笔记
进程的描述
1.进程描述符task_struct数据结构(一)
为了管理进程,内核必须对每个进程进行清晰的描述,进程描述符提供了内核所需了解的进程信息。
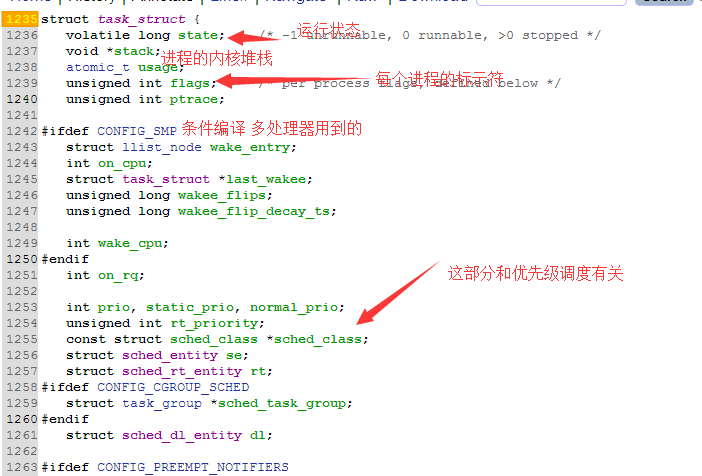
- struct task_struct数据结构很庞大
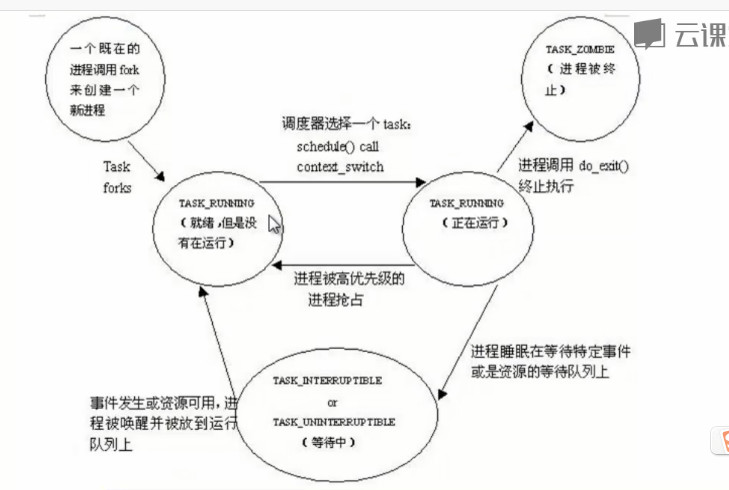
- Linux进程的状态与操作系统原理中的描述的进程状态似乎有所不同,比如就绪状态和运行状态都是TASK_RUNNING,为什么呢?
- 进程的标示pid
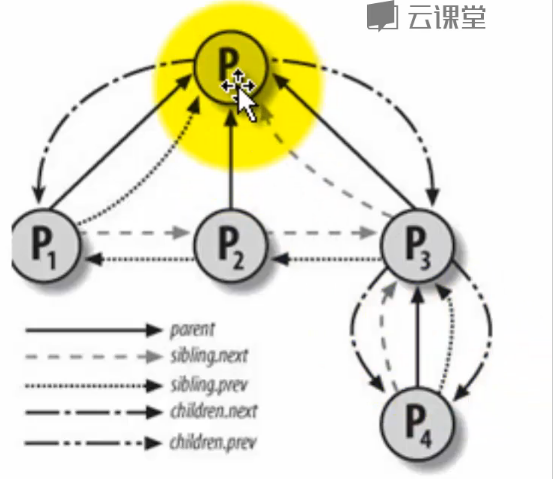
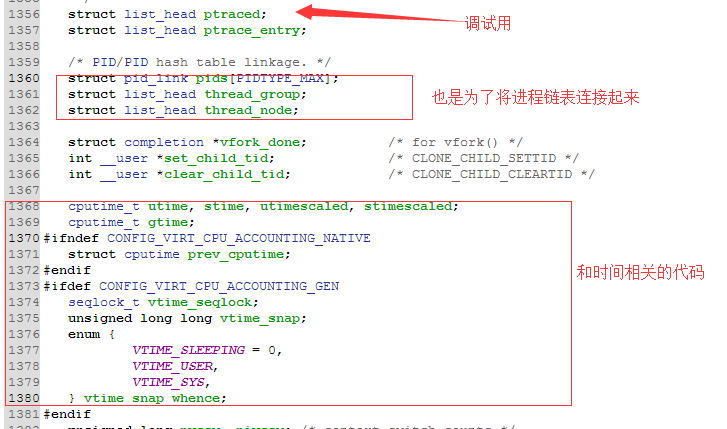
- 所有进程链表struct list_head tasks; 内核的双向循环链表的实现方法 - 一个更简略的双向循环链表
- 程序创建的进程具有父子关系,在编程时往往需要引用这样的父子关系。进程描述符中有几个域用来表示这样的关系
- Linux为每个进程分配一个8KB大小的内存区域,用于存放该进程两个不同的数据结构:Thread_info和进程的内核堆栈
进程处于内核态时使用,不同于用户态堆栈,即PCB中指定了内核栈,那为什么PCB中没有用户态堆栈?用户态堆栈是怎么设定的?
内核控制路径所用的堆栈很少,因此对栈和Thread_info来说,8KB足够了
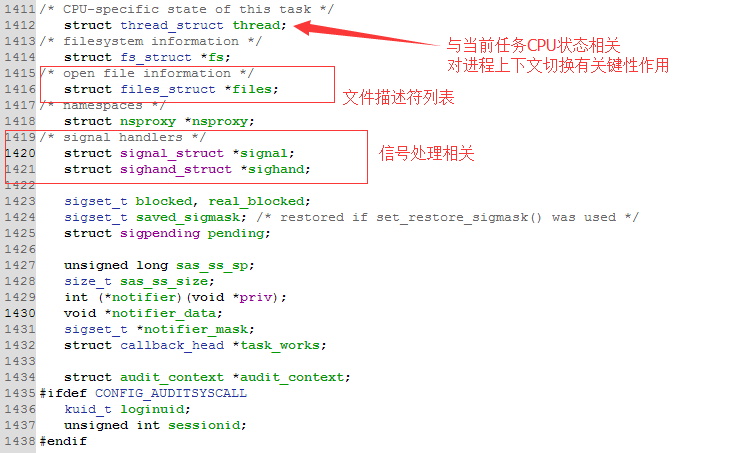
- struct thread_struct thread; //CPU-specific state of this task
- 文件系统和文件描述符
- 内存管理——进程的地址空间
Linux内核状态转换图:
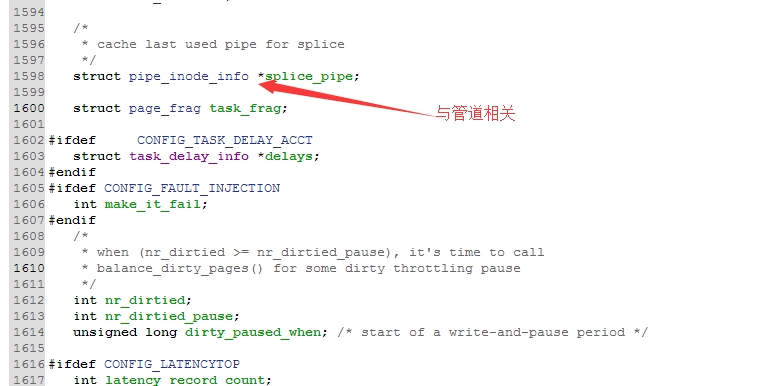
2.进程描述符task_struct数据结构(二)
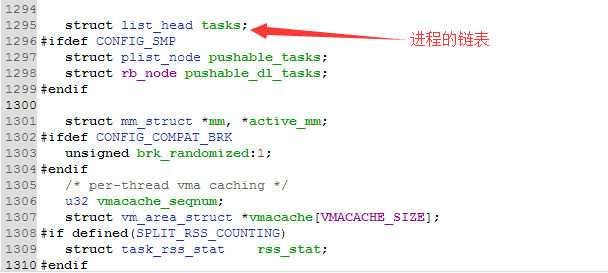
双向循环链表图如下:


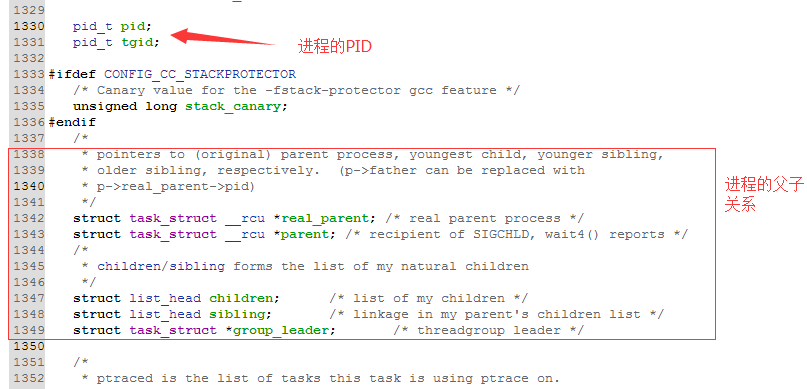
进程的父子关系直观图:
进程的创建
1.进程的创建概览及fork一个进程的用户态代码
(1)进程的起源再回顾
- 道生一(start_kernel...cpu_idle)
- 一生二(kernel_init和kthreadd)
- 二生三(即前面的0、1、2三个进程)
- 三生万物(1号进程是所有用户态进程的祖先,2号进程是所有内核线程的祖先)
(2)0号进程手工写,1号进程复制、加载init程序
(3)shell命令行是如何启动进程的
fork一个子进程的代码:
 #include <stdio.h>

 #include <stdlib.h>

 #include <unistd.h>

 int main(int argc, char * argv[])

 {

     int pid;

     /* fork another process */

     pid = fork();

     if (pid < )   出错处理

     {

         /* error occurred */

         fprintf(stderr,"Fork Failed!");

         exit(-);

     }

     else if (pid == )

     {

         /* child process */  子进程   pid=0时 if和else都会执行  fork系统调用在父进程和子进程各返回一次

         printf("This is Child Process!\n");

     }

     else

     {

         /* parent process  */

         printf("This is Parent Process!\n");

         /* parent will wait for the child to complete*/

         wait(NULL);

         printf("Child Complete!\n");

     }

 }
2.理解进程创建过程复杂代码的方法
(1)系统调用再回顾

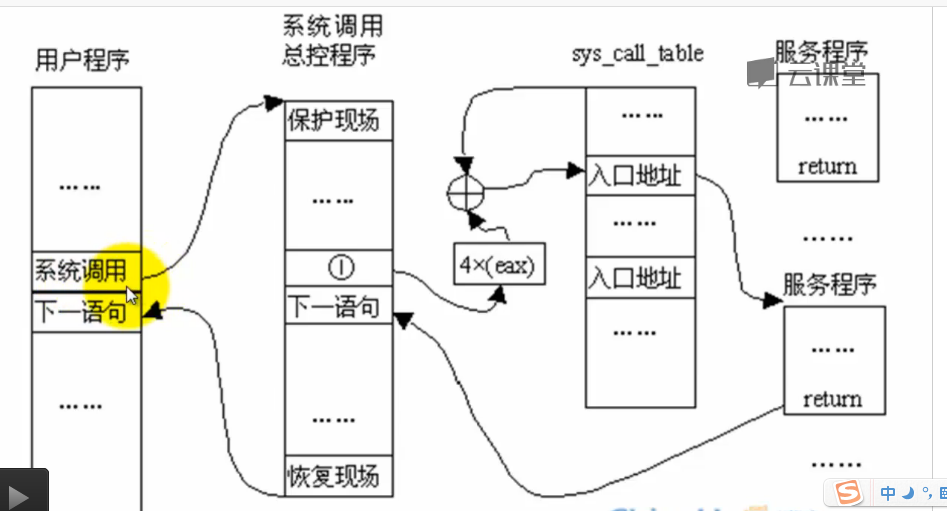
(2)fork的子进程是从哪里开始执行的?
与基于mykernel写的精简内核对照起来。
(3)创建一个新进程在内核中的执行过程
- fork、vfork和clone三个系统调用都可以创建一个新进程,而且都是通过调用do_fork来实现进程的创建;
- Linux通过复制父进程来创建一个新进程,那么这就给我们理解这一个过程提供一个想象的框架:
- 复制一个PCB——task_struct
err = arch_dup_task_struct(tsk, orig);
- 要给新进程分配一个新的内核堆栈
ti = alloc_thread_info_node(tsk, node);

tsk->stack = ti;

setup_thread_stack(tsk, orig); //这里只是复制thread_info,而非复制内核堆栈
- 要修改复制过来的进程数据,比如pid、进程链表等等都要改改吧,见copy_process内部。
- 从用户态的代码看fork();函数返回了两次,即在父子进程中各返回一次,父进程从系统调用中返回比较容易理解,子进程从系统调用中返回,那它在系统调用处理过程中的哪里开始执行的呢?这就涉及子进程的内核堆栈数据状态和task_struct中thread记录的sp和ip的一致性问题,这是在哪里设定的?copy_thread in copy_process
1 *childregs = *current_pt_regs(); //复制内核堆栈

2 childregs->ax = 0; //为什么子进程的fork返回0,这里就是原因!

3

4 p->thread.sp = (unsigned long) childregs; //调度到子进程时的内核栈顶

5 p->thread.ip = (unsigned long) ret_from_fork; //调度到子进程时的第一条指令地址
(4)理解复杂事物要预设一个大致的框架。
(5)创建新进程是通过复制当前进程来实现的。
(6)设想创建新进程过程中需要做哪些事
3.浏览进程创建过程相关的关键代码
(1)系统调用内核处理函数sys_fork、sys_clone、sys_vfork

最终都是执行do_fork()。

do_fork()里的复制进程的函数:

具体:

打开复制PCB的具体函数:

打开alloc_thread_info():

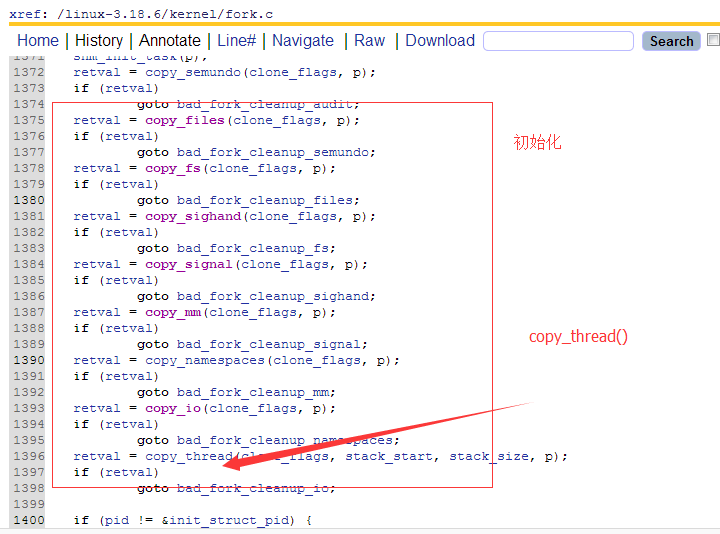
拷贝内核堆栈数据和指定新进程的第一条指令地址。
4.创建的新进程是从哪里开始执行的?
(1)复制内核堆栈时

打开pt_regs:

int指令和SAVE_ALL压到内核栈的内容。
下面分析entry_32.S,也就是总控程序。
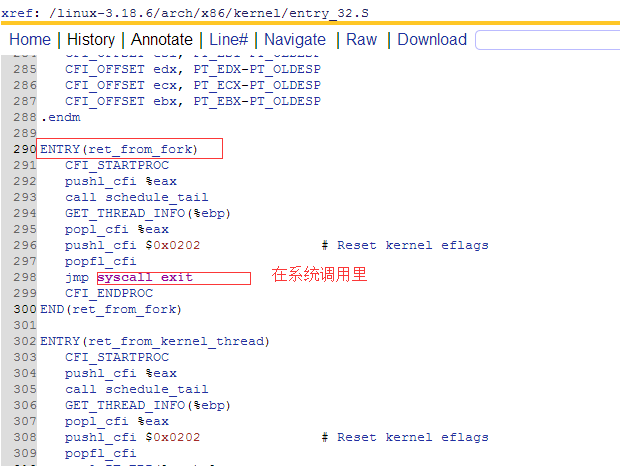
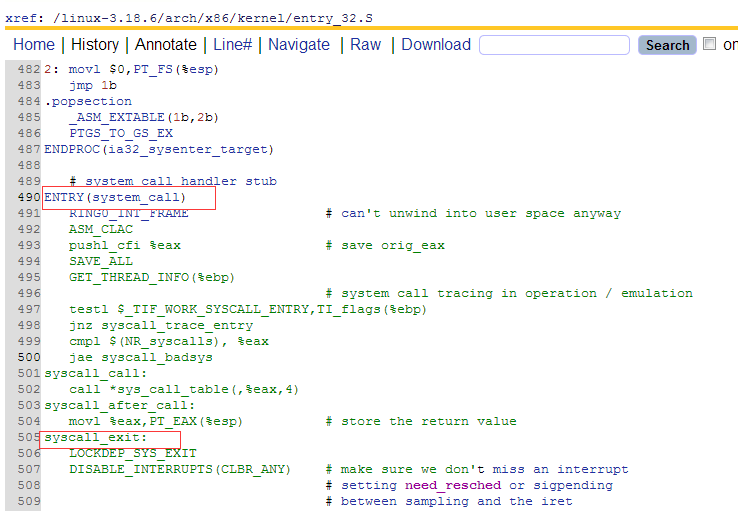
5.使用gdb跟踪创建新进程的过程(见作业)
三、课后作业
1.理解task_struct数据结构http://codelab.shiyanlou.com/xref/linux-3.18.6/include/linux/sched.h#1235;
具体代码分析过程见第二部分学习过程 进程的描述 部分——2.进程描述符task_struct数据结构(二)
2.分析fork函数对应的内核处理过程sys_clone,理解创建一个新进程如何创建和修改task_struct数据结构;
具体代码分析过程见第二部分学习过程 进程的创建 部分——3.浏览进程创建过程相关的关键代码(1)系统调用内核处理函数sys_fork、sys_clone、sys_vfork
理解如下:
fork、vfork和clone三个系统调用都可以创建一个新进程,而且都是通过调用do_fork来实现进程的创建,do_fork完成了创建中的大部分工作,该函数调用copy_process()函数,然后让进程开始运行。copy_process()函数工作如下:
- 1、调用dup_task_struct()为新进程创建一个内核栈、thread_info结构和task_struct,这些值与当前进程的值相同
- 2、检查
- 3、子进程着手使自己与父进程区别开来。进程描述符内的许多成员被清0或设为初始值。
- 4、子进程状态被设为TASK_UNINTERRUPTIBLE,以保证它不会投入运行
- 5、copy_process()调用copy_flags()以更新task_struct的flags成员。表明进程是否拥有超级用户权限的PF_SUPERPRIV标志被清0。表明进程还没有调用exec()函数的PF_FORKNOEXEC标志被设置
- 6、调用alloc_pid()为新进程分配一个有效的PID
- 7、根据传递给clone()的参数标志,copy_process()拷贝或共享打开的文件、文件系统信息、信号处理函数、进程地址空间和命名空间等
- 8、最后,copy_process()做扫尾工作并返回一个指向子进程的指针
3.使用gdb跟踪分析一个fork系统调用内核处理函数sys_clone ,验证您对Linux系统创建一个新进程的理解,推荐在实验楼Linux虚拟机环境下完成实验。
分析过程如下:
更新menu代码到最新版、make rootfs,用help查看,新添加fork命令:

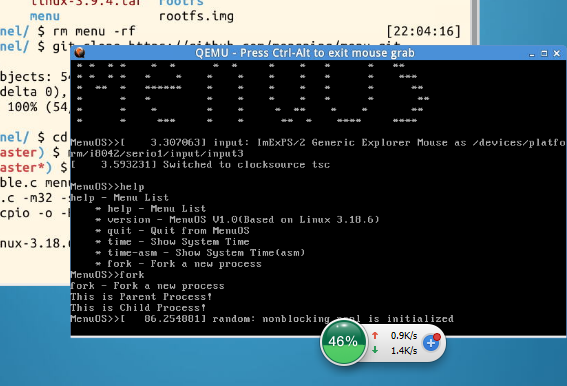
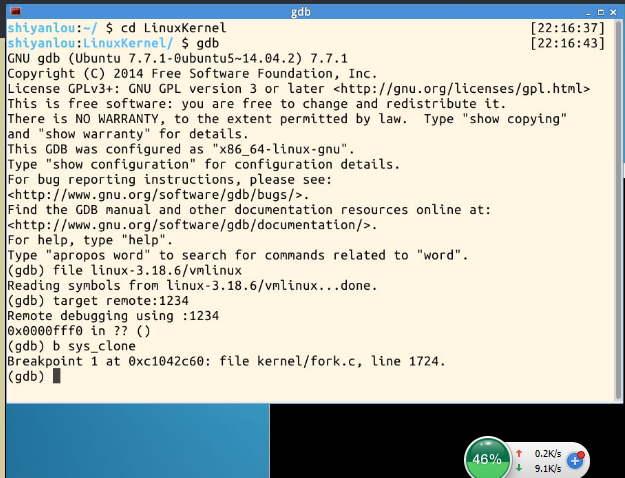
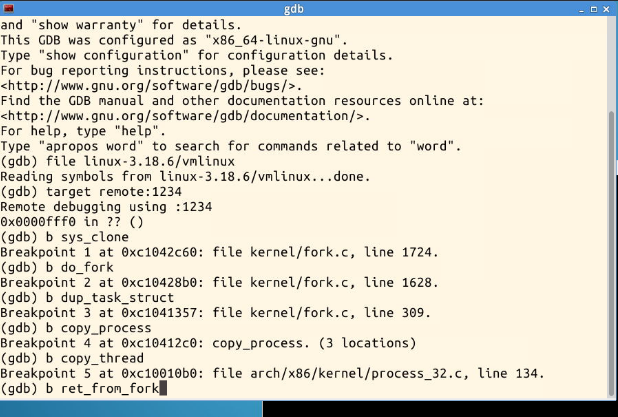
使用gdb跟踪调试内核,在一些重要函数处设置断点:
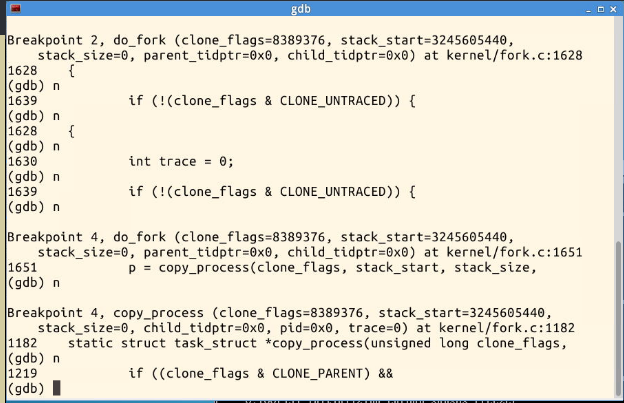
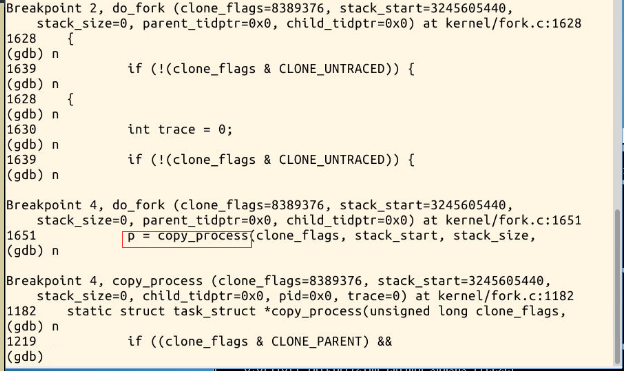
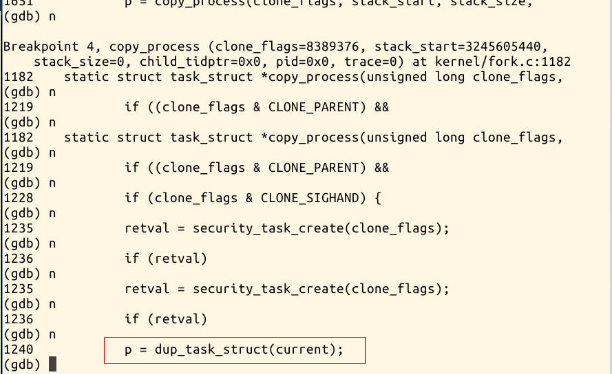
执行一个fork,会发现只输出一个fork的命令描述,后面并没有执行,因为它停在了sys_clone这个位置。
4.特别关注新进程是从哪里开始执行的?为什么从哪里能顺利执行下去?即执行起点与内核堆栈如何保证一致。
答:ret_from_fork;决定了新进程的第一条指令地址。
原因如下:
copy_process()主要完成进程数据结构,各种资源的初始化。
p = dup_task_struct(current);
- (省略的IF语句)检查clone_flags参数,防止无效的组合进入
p = dup_task_struct(current);调用dup_task_struct()为新进程创建一个内核栈- 判断权限及允许范围的代码
- 对子进程的描述符初始化和复制父进程的资源给子进程
retval = sched_fork(clone_flags, p);完成调度相关的设置,将这个task分配给CPUif (retval)语句群,复制共享进程的的各个部分retval = copy_thread(clone_flags, stack_start, stack_size, p);复制父进程堆栈的内容到子进程的堆栈中去.这其中,copy_thread()函数中的语句p->thread.ip = (unsigned long) ret_from_fork;决定了新进程的第一条指令地址.
- 在ret_from_fork之前,也就是在copy_thread()函数中
*childregs = *current_pt_regs();该句将父进程的regs参数赋值到子进程的内核堆栈, - *childregs的类型为pt_regs,里面存放了SAVE ALL中压入栈的参数
- 故在之后的RESTORE ALL中能顺利执行下去.
5.根据本周所学知识分析fork函数对应的系统调用处理过程,撰写一篇署名博客,并在博客文章中注明“真实姓名(与最后申请证书的姓名务必一致) + 原创作品转载请注明出处 + 《Linux内核分析》MOOC课程http://mooc.study.163.com/course/USTC-1000029000 ”,
总结:
- Linux通过复制父进程来创建一个新进程,通过调用do_fork来实现
- Linux为每个新创建的进程动态地分配一个
task_struct结构. - 为了把内核中的所有进程组织起来,Linux提供了几种组织方式,其中哈希表和双向循环链表方式是针对系统中的所有进程(包括内核线程),而运行队列和等待队列是把处于同一状态的进程组织起来
- fork()函数被调用一次,但返回两次
LINUX内核分析第六周学习总结——进程的描述和进程的创建的更多相关文章
- LINUX内核分析第六周学习总结——进程的描述与创建
LINUX内核分析第六周学习总结--进程的描述与创建 标签(空格分隔): 20135321余佳源 余佳源 原创作品转载请注明出处 <Linux内核分析>MOOC课程 http://mooc ...
- linux内核分析第六周学习笔记
LINUX内核分析第六周学习总结 标签(空格分隔): 20135328陈都 陈都 原创作品转载请注明出处 <Linux内核分析>MOOC课程 http://mooc.study.163.c ...
- Linux内核分析第六周学习笔记——分析Linux内核创建一个新进程的过程
Linux内核分析第六周学习笔记--分析Linux内核创建一个新进程的过程 zl + <Linux内核分析>MOOC课程http://mooc.study.163.com/course/U ...
- Linux内核分析——第六周学习笔记20135308
第六周 进程的描述和进程的创建 一.进程描述符task_struct数据结构 1.操作系统三大功能 进程管理 内存管理 文件系统 2.进程控制块PCB——task_struct 也叫进程描述符,为了管 ...
- Linux内核分析第六周学习总结:进程的描述和进程的创建
韩玉琪 + 原创作品转载请注明出处 + <Linux内核分析>MOOC课程http://mooc.study.163.com/course/USTC-1000029000 一.进程的描述 ...
- Linux内核分析——第六周学习笔记
进程的描述和进程的创建 前言:以下笔记除了一些讲解视频中的概念记录,图示.图示中的补充文字.总结.分析.小结部分均是个人理解.如有错误观点,请多指教! PS.实验操作会在提交到MOOC网站的博客中写.
- LINUX内核分析第七周学习总结——可执行程序的装载
LINUX内核分析第六周学习总结——进程的描述和进程的创建 张忻(原创作品转载请注明出处) <Linux内核分析>MOOC课程http://mooc.study.163.com/cours ...
- LINUX内核分析第七周学习总结:可执行程序的装载
LINUX内核分析第七周学习总结:可执行程序的装载 韩玉琪 + 原创作品转载请注明出处 + <Linux内核分析>MOOC课程http://mooc.study.163.com/cours ...
- LINUX内核分析第八周学习总结——进程的切换和系统的一般执行过程
LINUX内核分析第八周学习总结——进程的切换和系统的一般执行过程 张忻(原创作品转载请注明出处) <Linux内核分析>MOOC课程http://mooc.study.163.com/c ...
随机推荐
- beta冲刺————第二天(2/5)
完善具体内容: 前端: (1)添加了更多设置 (2)点击后出现底栏,分别可以进行字体背景设置.收藏.分享等操作,同时可以看出对文章的排版进行了完善 后端: 对阿里云服务器中的环境进行配置,同时熟悉阿里 ...
- 'No Transport' Error w/ jQuery ajax call in IE
I need to use foursquare API to search venues. Of course it is cross-domain. It has no any problems ...
- NodeHandles
os::NodeHandle类有两个作用: 第一.它在roscpp程序内提供了一种RAII(Resource Acquisition Is Initialization)类型式启动和关闭内部节点的方法 ...
- JAVA框架 Spring AOP--切入点表达式和通知类型
一:AOP的相关术语: 1)Joinpoint(连接点):所谓的连接点是指那些可以被拦截点,在spring中这些点是指方法.因为在spring中支持方法类型的连接点. 2)Pointcut(切入点): ...
- 计算机视觉-sift(2)代码理解
之前结合不同人的资料理解了sift的原理,这里通过opencv中的代码来加深对sift的实现的理解. 使得能够从原理性理解到源码级的理解.不过该博文还是大量基于<赵春江, opencv2.4.9 ...
- Pythoner使用的豆瓣pip源
主要示例: sudo pip install -i http://pypi.douban.com/simple/ flask-script Flask的扩展: flask-script是一个可以在f ...
- 大数据入门第十四天——Hbase详解(三)hbase基本原理与MR操作Hbase
一.基本原理 1.hbase的位置 上图描述了Hadoop 2.0生态系统中的各层结构.其中HBase位于结构化存储层,HDFS为HBase提供了高可靠性的底层存储支持, MapReduce为HBas ...
- 20155218《网络对抗》Exp2 后门原理与实践
20155218<网络对抗>Exp2 后门原理与实践 常用后门工具实践 1.Windows获得Linux Shell: 在Windows下,先使用ipconfig指令查看本机IP,使用nc ...
- # 2017-2018-2 20155319『网络对抗技术』Exp6:信息收集与漏洞扫描
2017-2018-2 20155319『网络对抗技术』Exp6:信息收集与漏洞扫描 实践内容 (1)各种搜索技巧的应用 (2)DNS IP注册信息的查询 (3)基本的扫描技术:主机发现.端口扫描.O ...
- [c#][福利]BTTool种子文件修改工具
前言 不知道各位看官是否有过类似的经历.好不容易找到一个电影的种子文件,想用百度云的离线下载功能去下载文件,却被百度云无情提示“离线文件因含有违规内容被系统屏蔽无法下载”!假设有这么一个场景,比如最近 ...