
python爬虫_入门
本来觉得没什么可写的,因为网上这玩意一搜一大把,不过爬虫毕竟是python的一个大亮点,不说说感觉对不起这玩意
基础点来说,python2写爬虫重点需要两个模块,urllib和urllib2,其实还有re
先介绍下模块的一些常用功能
urllib.urlopen('http://xxx.xxx.xxx') #打开一个网址,只是打开,和open差不多
urllib2.Request(url) #解析网址,这个可以省略,具体不是很懂,一些功能,比如加head头什么的也需要使用这个
urllib.urlretrieve(url,filename) #下载用,把url提供的东西down下来,并用filename保存
举个蜂鸟爬图片的例子,下面上伪代码:
1、url解析

2、打开url

3、读取url,就是read()

4、使用re.findall找到所有和图片有关系的地址,这里只jpg

5、循环下载
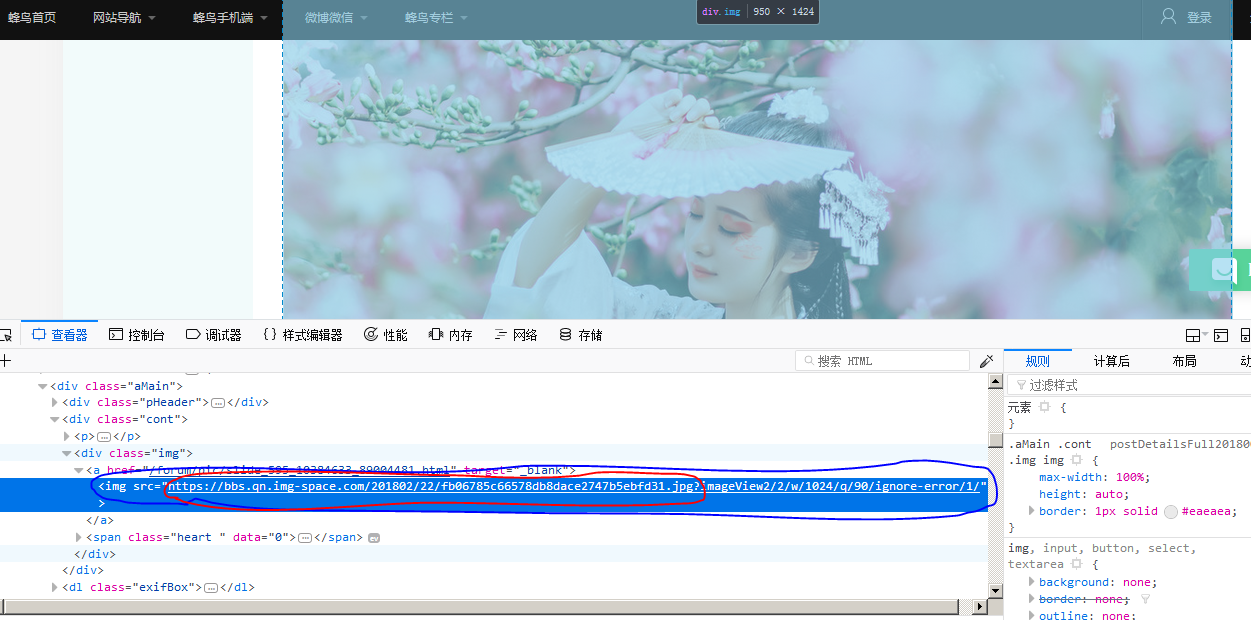
看图上,图片链接格式是src="http://index_url/page_num/image_name.jpg?XXXXXXX",那么如果需要下载的话一定是需要红圈部分,也就是http://index_url/page_num/image_name.jpg
分析之后后面的事就好办了,下面上代码
import urllib

import urllib2

import re

#处理地址,并获取页面全部的图片地址

def get_image_url(url):

  #url_format = urllib2.Request(url) #1

  url_open = urllib.urlopen(url) #

  url_read = url_open.read() #

  re_value = re.compile('(?<=src\=\").*?\.jpg')

  image_url_list = re.findall(re_value,url_read) #

  return image_url_list

#这个函数专门用来下载,前面两行是将图片连接中/前面的内容全部删除,留下后面的文件名用来保存文件的,try不说了,不清楚请翻回去看容错

def down_image(image_url):

  rev = '^.*/'

  file_name = re.sub(rev,'',image_url)

  try:

    urllib.urlretrieve(image_url,file_name)

  except:

    print 'download %s fail' %image_url

  else:

    print 'download %s successed' %image_url

if __name__ == '__main__':

  url = 'http://bbs.fengniao.com/forum/10384633.html'

  image_url_list = get_image_url(url)

  for image_url in image_url_list:

    down_image(image_url) #
困死,睡觉去。。。。。有时间再说说翻页什么的,就能爬网站了
python爬虫_入门的更多相关文章
- python爬虫_入门_翻页
写出来的爬虫,肯定不能只在一个页面爬,只要要爬几个页面,甚至一个网站,这时候就需要用到翻页了 其实翻页很简单,还是这个页面http://bbs.fengniao.com/forum/10384633. ...
- python爬虫-基础入门-python爬虫突破封锁
python爬虫-基础入门-python爬虫突破封锁 >> 相关概念 >> request概念:是从客户端向服务器发出请求,包括用户提交的信息及客户端的一些信息.客户端可通过H ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
- python爬虫如何入门
学爬虫是循序渐进的过程,作为零基础小白,大体上可分为三个阶段,第一阶段是入门,掌握必备的基础知识,第二阶段是模仿,跟着别人的爬虫代码学,弄懂每一行代码,第三阶段是自己动手,这个阶段你开始有自己的解题思 ...
- Python爬虫教程——入门五之URLError异常处理
大家好,本节在这里主要说的是URLError还有HTTPError,以及对它们的一些处理. 1.URLError 首先解释下URLError可能产生的原因: 网络无连接,即本机无法上网 连接不到特定的 ...
- 【Python爬虫】入门知识
爬虫基本知识 这阵子需要用爬虫做点事情,于是系统的学习了一下python爬虫,觉得还挺有意思的,比我想象中的能干更多的事情,这里记录下学习的经历. 网上有关爬虫的资料特别多,写的都挺复杂的,我这里不打 ...
- python爬虫从入门到放弃前奏之学习方法
首谈方法 最近在整理爬虫系列的博客,但是当整理几篇之后,发现一个问题,不管学习任何内容,其实方法是最重要的,按照我之前写的博客内容,其实学起来还是很点枯燥不能解决传统学习过程中的几个问题: 这个是普通 ...
随机推荐
- 浅析Session和Cookie
Cookie Cookie的作用,就是当一个用户通过http访问一个服务器时,这个服务器会将一些key/value键值对返回给客户端浏览器,并给这些数据加上一些限制条件,在条件符合时这个用户访问该 ...
- eclipse安装quick text search插件,全文搜索
主要有两种方法 1.InstaSearch 同样可以做到workspace下的全文搜索 可以使用eclipse marktplace中搜索instaSearch,与普通软件安装类似 安装成功后的界面如 ...
- [USACO 07DEC]Best Cow Line, Gold
Description 题库链接 给以长度为 \(n\) 的字符串,要求每次只能从两边取一个字符,使得取出来之后字典序最小. \(1\leq n\leq 30000\) Solution 将字符串翻转 ...
- 模拟按下某快捷键:keybd_event使用方法
keybd_event是函数功能:该函数合成一次击键事件.系统可使用这种合成的击键事件来产生WM_KEYUP或WM_KEYDOWN消息. Windows提供了一个模拟键盘API函数Keybd_even ...
- MVC应用程序播放RealPlayer(rmvb)视频
以前Insus.NET开发asp.net时,一直无法把Realplayer的rmvb格式的视频在aspx网页播放与显示.现在学习ASP.NET MVC了,再次尝试这个,望它能在MVC的应用程序运行. ...
- 在jQuery定义自己的扩展方法函数
今早复习昨天的练习jQuery的DropDownList联动功能,如果想看回<jQuery实现DropDownList(MVC)>http://www.cnblogs.com/insus/ ...
- 获取ip 笔记
使用命令 Request.UserHostAddress;//IP地址 Request.UserHostName;//用户名. 1. 在ASP.NET中专用属性: 获取服务器电脑名:Page.Serv ...
- Freemarker出现NullNumberException异常
Spring Boot项目使用了Freemarker模板引擎. 在ftl文件中使用了一些变量,但是一直出现错误,无法正常渲染页面,反复出现的报错是: freemarker.core.NonNumeri ...
- 使用 RabbitMQ 实现异步调用
目录 引言 启动 RabbitMQ 服务器 运行 rabbitmq 容器 RabbitMQ 控制台 Exchange 和 Queue 开发服务端和客户端 开发服务端 开发客户端 Java Bean 类 ...
- Android - 自定义控件和属性(attr和TypedArray)
http://blog.csdn.net/zjh_1110120/article/details/50976027 1.attr format 取值类型 以ShapeView 为例 <decla ...