
[sklearn] 决策树、随机森林、隐马尔可夫模型
决策树
决策树(Decision Tree)是一种用于处理分类和回归问题的无监督学习算法。如下图所示为某女青年在某相亲网站的相亲决策图。这幅图描述的都是一个非常典型的决策树模型。
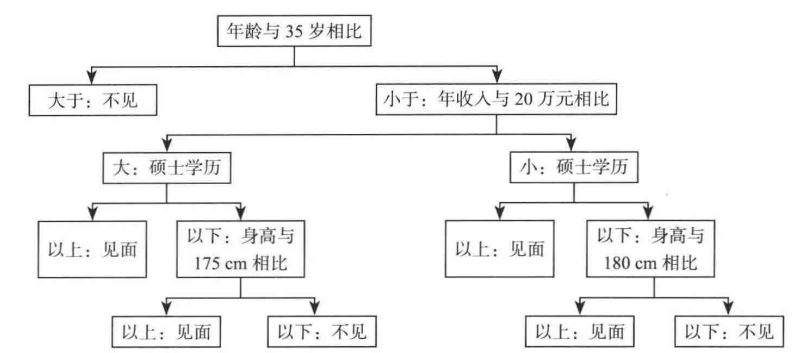
通过对其相亲决策的分析,假设其相亲信息如下所示:
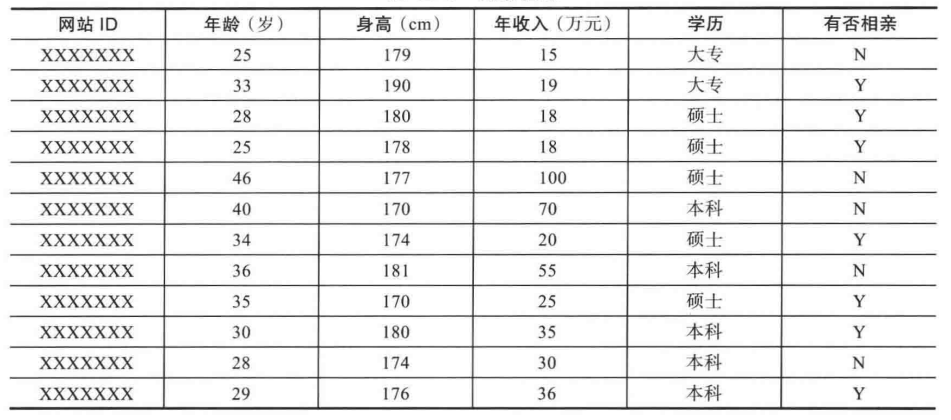
该女青年相亲决策主要考虑到因素有年龄,身高,年收入,学历。同事由该女青年的相亲决策图可以看到,相亲决策树以年龄与35岁相比作为树根。但是其他的数据项也能做树根。因此选择合适的数据项作为树根十分重要。在决策树中由信息增益确定树根。
信息增益
在提出信息增益前,需要对理解信息熵(香农熵,information entropy)这个概念。信息熵(entropy)描述整个体系的混乱程度,熵越大,体系混乱程度越大。例如火柴有序的放在火柴盒子里,则熵值很低,反之,熵值很高。
整个体系的信息熵的计算公式如下:
$$Info=-\sum_{i=1}^{m}p_{i}log_{2}p_{i}$$
其中m表示最后决策的种类。前面女青年相亲的例子,最后决策分为相亲和不相亲,则m=2。其中Y(相亲)概率为7/12,
N(不相亲)概率为5/12。信息熵为:
$$Info=-\left(\frac{7}{12}log_{2}\frac{7}{12}+\frac{5}{12}log_{2}\frac{5}{12}\right )=0.98 bit$$
树根的选择十分重要。选择树根的原则首先确定最佳因素如确定为年龄,然后再确定分割节点如确定年龄为35岁为分割节点,分割后获得两棵子树。然后根据其他因素选择树根,再次对所获得的两棵子树分割。通过熵来评价分割结果,当熵越大,则接下分割难度越大,分割次数越多;熵越小则分割难度越小,分割次数越小。这个划分规则下以某因素A来划分,所得划分熵如下:
$$Info_{A}=-\sum_{j=1}^{v}p_{j}\cdot Info(A_{j})$$
上式中v表示所选因素A一共有多少组,如A为学历时v=3。\(P_(j)\)表示这种分组所占比重。如学历有可以被划分为3组,大专、本科、硕士。则当所选因素为A时,信息熵为:

最后求的近似值\(Info_{A}=0.872\)
对于信息增益,前后的信息熵变化值为信息增益。信息增益越大表明分割效果越好。对于以学历为分割因素时的信息增益如下:

sklearn实现
sklearn中对应的函数DecisionTreeClassifier函数(分类),DecisionTreeRegressor(回归),分类代码如下
from sklearn import tree

import numpy as np

#年龄,身高,年收入,学历(大专:0,本科:1,硕士:2)

X = np.array(

        [[25, 179, 15, 0],

         [33, 190, 19 ,0],

         [28, 180, 18, 2],

         [25, 178, 18, 2],

         [46, 100, 100, 2],

         [40, 170, 170, 1],

         [34, 174, 20, 2],

         [36, 181, 55, 1],

         [35, 170, 25, 2],

         [30, 180, 35, 1],

         [28, 174, 30, 1],

         [29, 176, 36, 1]])

#0表示没有相亲,1表示相亲

y= [0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 0, 1]

clf = tree.DecisionTreeClassifier().fit(X, y)

p=[[28, 180, 18, 2]]

print(clf.predict(p)) #[1]
函数其他参数改动可参考官网文档:
http://scikit-learn.org/stable/modules/tree.html#tree-classification
另外可以将sklearn所生成的决策可视化,具体参考链接:
随机森林
随机森林(Random Forest)是一个构建决策树的过程,目标是构建许多棵决策树。随机森林会为一个训练集根据不同的因素构建若干棵决策,每棵树的层级都比较浅。对新样本进行分类判断时候会同时对这些决策树进行分类概率判断,最后进行投票,哪个类别多,输入的样本就属于哪个类别。其分类方式也就是通过若干个分类器进行组合集成学习。
sklearn实现
sklearn中对应的函数RadomForestClassifier函数(分类),RadomForestRegressor(回归),分类代码如下
from sklearn.ensemble import RandomForestClassifier

import numpy as np

#年龄,身高,年收入,学历(大专:0,本科:1,硕士:2)

X = np.array(

        [[25, 179, 15, 0],

         [33, 190, 19 ,0],

         [28, 180, 18, 2],

         [25, 178, 18, 2],

         [46, 100, 100, 2],

         [40, 170, 170, 1],

         [34, 174, 20, 2],

         [36, 181, 55, 1],

         [35, 170, 25, 2],

         [30, 180, 35, 1],

         [28, 174, 30, 1],

         [29, 176, 36, 1]])

#0表示没有相亲,1表示相亲

y= [0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 0, 1]

clf =RandomForestClassifier().fit(X, y)

p=[[28, 180, 18, 2]]

print(clf.predict(p)) #[1]
函数 其他参数改动可参考官网文档:
http://scikit-learn.org/stable/modules/ensemble.html#random-forests
隐马尔可夫模型
隐马尔可夫模型和贝叶斯信念网络的模型思维方式比较接近。区别在于隐马尔可夫模型更简单,也可以说隐马尔可夫模型是贝叶斯信念网络的一种特例。但是sklearn中没有实现隐马尔可夫模型的函数库。
隐马尔可夫模型理论见文档:如何用简单易懂的例子解释隐马尔可夫模型? - Yang Eninala的回答 - 知乎
在IPython Notebook有隐马尔可夫模型的实现,具体见:
https://github.com/hmmlearn/hmmlearn
[sklearn] 决策树、随机森林、隐马尔可夫模型的更多相关文章
- HMM隐马尔可夫模型来龙去脉(一)
目录 隐马尔可夫模型HMM学习导航 一.认识贝叶斯网络 1.概念原理介绍 2.举例解析 二.马尔可夫模型 1.概念原理介绍 2.举例解析 三.隐马尔可夫模型 1.概念原理介绍 2.举例解析 四.隐马尔 ...
- [综]隐马尔可夫模型Hidden Markov Model (HMM)
http://www.zhihu.com/question/20962240 Yang Eninala杜克大学 生物化学博士 线性代数 收录于 编辑推荐 •2216 人赞同 ×××××11月22日已更 ...
- 隐马尔科夫模型HMM学习最佳范例
谷歌路过这个专门介绍HMM及其相关算法的主页:http://rrurl.cn/vAgKhh 里面图文并茂动感十足,写得通俗易懂,可以说是介绍HMM很好的范例了.一个名为52nlp的博主(google ...
- HMM隐马尔科夫模型
这是一个非常重要的模型,凡是学统计学.机器学习.数据挖掘的人都应该彻底搞懂. python包: hmmlearn 0.2.0 https://github.com/hmmlearn/hmmlearn ...
- 猪猪的机器学习笔记(十七)隐马尔科夫模型HMM
隐马尔科夫模型HMM 作者:樱花猪 摘要: 本文为七月算法(julyedu.com)12月机器学习第十七次课在线笔记.隐马尔可夫模型(Hidden Markov Model,HMM)是统计模型,它用来 ...
- 隐马尔科夫模型(HMM)及事实上现
马尔科夫模型 马尔科夫模型是单重随机过程,是一个2元组:(S,A). 当中S是状态集合,A是状态转移矩阵. 仅仅用状态转移来描写叙述随机过程. 马尔科夫模型的2个如果 有限历史性如果:t+l时刻系统状 ...
- 【整理】图解隐马尔可夫模型(HMM)
写在前面 最近在写论文过程中,研究了一些关于概率统计的算法,也从网上收集了不少资料,在此整理一下与各位朋友分享. 隐马尔可夫模型,简称HMM(Hidden Markov Model), 是一种基于概率 ...
- 隐马尔科夫模型HMM(三)鲍姆-韦尔奇算法求解HMM参数
隐马尔科夫模型HMM(一)HMM模型 隐马尔科夫模型HMM(二)前向后向算法评估观察序列概率 隐马尔科夫模型HMM(三)鲍姆-韦尔奇算法求解HMM参数(TODO) 隐马尔科夫模型HMM(四)维特比算法 ...
- NLP —— 图模型(一)隐马尔可夫模型(Hidden Markov model,HMM)
本文简单整理了以下内容: (一)贝叶斯网(Bayesian networks,有向图模型)简单回顾 (二)隐马尔可夫模型(Hidden Markov model,HMM) 写着写着还是写成了很规整的样 ...
随机推荐
- LinkedBlockingQueue详解
LinkedBlockingQueue介绍 [1]LinkedBlockingQueue是一个基于链表实现的阻塞队列,默认情况下,该阻塞队列的大小为Integer.MAX_VALUE,由于这个数值特别 ...
- c++算法竞赛常用板子集合(持续更新)
前言 本文主要包含算法竞赛一些常用的板子,码风可能不是太好,还请见谅. 后续会继续补充没有的板子.当然我太菜了有些可能写不出来T^T 稍微有些分类但不多,原谅我QwQ 建议 Ctrl + F 以快速查 ...
- 知识图谱-生物信息学-医学顶刊论文(Briefings in Bioinformatics-2021):生物信息学中的图表示学习:趋势、方法和应用
4.(2021.6.24)Briefings-生物信息学中的图表示学习:趋势.方法和应用 论文标题: Graph representation learning in bioinformatics: ...
- python face_recognition安装及各种应用
1.安装 首先,必须提前安装cmake.numpy.dlib,其中,由于博主所用的python版本是3.6.4(为了防止不兼容,所以用之前的版本),只能安装19.7.0及之前版本的dlib,所以直接p ...
- 什么是subsignature和return-type-substitutable
subsignature 什么是签名(signature) 方法签名组成:方法名+参数列表(参数的类型.个数.顺序) Java语言层面规定的签名是不包含返回值类型的: JVM层面规定的签名是包含返回值 ...
- 前端JS获取路由地址里的参数QueryString取值
参数的获取 声明一个函数 //参数name是路由参数 engNo function getQueryString(name) { var reg = new RegExp("(^|& ...
- day05-JavaScript02
JavaScript02 8.JavaScript函数 JavaScript函数介绍 函数是由事件驱动的,或者当它被调用时,执行的可重复使用的代码 例子 <!DOCTYPE html> & ...
- 【lwip】07-链路层收发以太网数据帧源码分析
目录 前言 7.1 链路层概述 7.2 MAC地址的基本概念 7.3 以太网帧结构 7.4 以太网帧结构 7.5 以太网帧报文数据结构 7.6 发送以太网数据帧 7.7 接收以太网数据帧 7.8 虚拟 ...
- 【NGINX】浅尝
Introduction Nginx is a web server that can also be used as a reverse proxy, load balancer, mail pro ...
- 2022春每日一题:Day 9
题目:IncDec Sequence 思维题,差分好题,每次区间操作,对应差分a[l]+=v,a[r+1]-=v,在差分数组中一定有一个正负号抵消,那么我们求出差分数组中正数(负数)和,记做s1,s2 ...