
python中的set集合
当使用爬虫URL保存时,一般会选择set来保存urls,set是集合,集合中的元素不能重复,其次还有交集,并集等集合的功能,
爬虫每次获取的网页中提取网页中的urls,并保存,这就需要利用urls = set()
- 下面展示一下HTML解析器代码
#coding:utf-8

import re

import  urlparse

from bs4 import BeautifulSoup

class HtmlParser(object):

    def parser(self,page_url,html_cont):

        '''

        用于解析网页内容抽取URL和数据

        :param page_url: 下载页面的URL

        :param html_cont: 下载的网页内容

        :return:返回URL和数据

        '''

        if page_url is None or html_cont is None:

            return

        soup = BeautifulSoup(html_cont,'html.parser',from_encoding='utf-8')

        new_urls = self._get_new_urls(page_url,soup)

        new_data = self._get_new_data(page_url,soup)

        return new_urls,new_data

    def _get_new_urls(self,page_url,soup):

        '''

        抽取新的URL集合

        :param page_url: 下载页面的URL

        :param soup:soup

        :return: 返回新的URL集合

        '''

        new_urls = set()

        #抽取符合要求的a标签

        #原书代码

        # links = soup.find_all('a',href=re.compile(r'/view/\d+\.htm'))

        #2017-07-03 更新,原因百度词条的链接形式发生改变

        links = soup.find_all('a', href=re.compile(r'/item/.*'))

        for link in links:

            #提取href属性

            new_url = link['href']

            #拼接成完整网址

            new_full_url = urlparse.urljoin(page_url,new_url)

            new_urls.add(new_full_url)

        return new_urls

    def _get_new_data(self,page_url,soup):

        '''

        抽取有效数据

        :param page_url:下载页面的URL

        :param soup:

        :return:返回有效数据

        '''

        data={}

        data['url']=page_url

        title = soup.find('dd',class_='lemmaWgt-lemmaTitle-title').find('h1')

        data['title']=title.get_text()

        summary = soup.find('div',class_='lemma-summary')

        #获取到tag中包含的所有文版内容包括子孙tag中的内容,并将结果作为Unicode字符串返回

        data['summary']=summary.get_text()

        return data
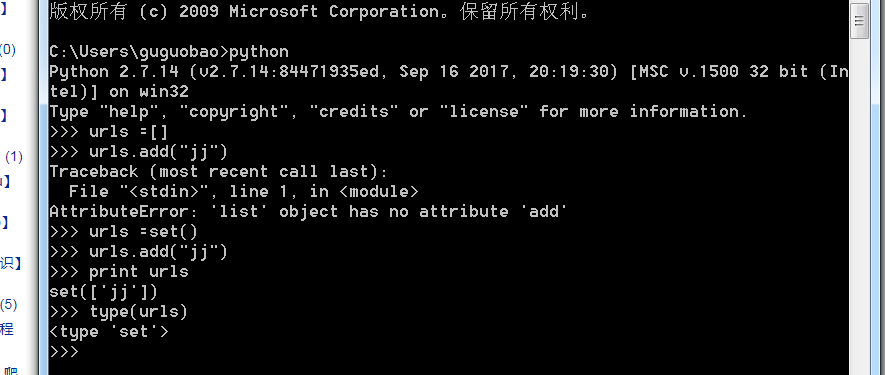
- 其次需要注意的是set可以add,而list不可以
python中的set集合的更多相关文章
- Python中字典和集合
Python中字典和集合 映射类型: 表示一个任意对象的集合,且可以通过另一个几乎是任意键值的集合进行索引 与序列不同,映射是无序的,通过键进行索引 任何不可变对象都可用作字典的键,如字符串.数字.元 ...
- 认识python中的set集合及其用法
python中,集合(set)是一个无序排列,可哈希, 支持集合关系测试,不支持索引和切片操作,没有特定语法格式, 只能通过工厂函数创建.集合里不会出现两个相同的元素, 所以集合常用来对字符串或元组或 ...
- Python中字典和集合的用法
本人开始学习python 希望能够慢慢的记录下去 写下来只是为了害怕自己忘记. python中的字典和其他语言一样 也是key-value的形式 利用空间换时间 可以进行快速的查找 key 是唯一的 ...
- Python中的SET集合操作
python的set和其他语言类似, 是一个无序不重复元素集, 基本功能包括关系测试和消除重复元素. 集合对象还支持union(联合), intersection(交), difference(差)和 ...
- Python中的数据结构 --- 集合(set)
1.集合(set)里面的元素是不可以重复的 s={1,2,3,3,4,3,4} ## 输出之后,没有重复的 2.定义一个空集合 s = set([]) print s,type(s)3 ...
- python中的set集合和深浅拷贝
一.基础数据类型的补充 1.str中的join算法,将列表转换成字符串,并用'_'(或其他) li=['李嘉诚','马化腾','刘嘉玲','黄海峰',] s='_'.join(li) print(s) ...
- Python中字典,集合和元组函数总结
## 字典的所有方法- 内置方法 - 1 cmp(dict1, dict2) 比较两个字典元素. - 2 len(dict) 计算字典元素个数,即键的总数. - 3 str(dict) 输出字典可打印 ...
- 2018.8.3 python中的set集合及深浅拷贝
一.字符串和列表的相互转化 之前写到想把xx类型的数据转化成yy类型的数据,直接yy(xx)就可以了,但是字符串和列表的转化比较特殊,相互之间的转化要通过join()和split()来实现. 例如: ...
- day05 Python中的set集合
集合是无序的,不重复的数据集合,它里面的元素是可哈希的(不可变类型),但是集合本身是不可哈希(所以集合做不了字典的键)的.以下是集合最重要的两点: 1.去重,把一个列表变成集合,就自动去重了. 2.关 ...
随机推荐
- lib异步中断
基于libusbx-1.0.18-rc1,libusbx现已重新merage到libusb.1. 初始化使用libusb_init初始化libusb,如果是单设备通信,ctx参数可以传NULL,表示使 ...
- jpa @Query()参数设置,:冒号方式、?NO.问号方式、实体类对象参数设置
一.service层事务(update/delete) @Transactional(rollbackFor = Exception.class) 二.@Query()参数设置 ?x 和:XX不能混 ...
- gitlab断电
断电重启以后 会出现2019-06-26_05:47:42.71382 HINT: If you're sure there are no old server processes still run ...
- Missing artifact com.sun.jmx:jmxri:jar:1.2.1的解决方法
maven项目添加log4j-1.2.15依赖出现Missing artifact com.sun.jmx:jmxri:jar:1.2.1错误 解决方法一:修改log4j.jar的版本为1.2.16或 ...
- react入门及简单配置
直接script引入的不说了 1.npm i -g create-react-app 2.create-react-app my-app (其中my-app为项目名称) 3.进入项目cd my-app ...
- golang web实战之三(基于iris框架的 web小应用,数据库采用 sqlite3 )
一.效果:一个图片应用 1.可上传图片到uploads目录. 2.可浏览和评论图片(用富文本编辑器输入) 二.梳理一下相关知识: 1.iris框架(模板输出,session) 2.富文本编辑器.sql ...
- HTML5上传超大文件解决方案
一.概述 所谓断点续传,其实只是指下载,也就是要从文件已经下载的地方开始继续下载.在以前版本的HTTP协议是不支持断点的,HTTP/1.1开始就支持了.一般断点下载时才用到Range和Content- ...
- asp.net上传超大文件解决方案
ASP.NET上传文件用FileUpLoad就可以,但是对文件夹的操作却不能用FileUpLoad来实现. 下面这个示例便是使用ASP.NET来实现上传文件夹并对文件夹进行压缩以及解压. ASP.NE ...
- R-seq()
seq(0, 1, length.out = 11) > seq(0, 1, length.out = 11) [1] 0.0 0.1 0.2 0.3 0.4 0.5 0.6 0.7 0.8 0 ...
- web 新能优化
网上的东西太多了都是搜来的东西 留着自己看吧! 摘自 :http://www.cnblogs.com/50614090/archive/2011/08/19/2145620.html 打开网站慢现状分 ...