
在python中使用正则表达式(转载)
https://www.cnblogs.com/hanmk/p/9143514.html
在python中使用正则表达式(一)
在python中通过内置的re库来使用正则表达式,它提供了所有正则表达式的功能。
一.写在前面:关于转义的问题
正则表达式中用“\”表示转义,而python中也用“\”表示转义,当遇到特殊字符需要转义时,你要花费心思到底需要几个“\”,所以为了避免这个情况,墙裂推荐使用原生字符串类型(raw string)来书写正则表达式。
方法很简单,只需要在表达式前面加个“r”即可,如下
r'\d{2}-\d{8}'
r'\bt\w*\b'
二.Re库常用的功能函数

1. re.match()
从字符串的起始位置匹配,匹配成功,返回一个匹配的对象,否则返回None
语法:re.match(pattern, string, flags=0)pattern:匹配的正则表达式string:要匹配的字符串flags:标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等;flags=0表示不进行特殊指定
可选标志如下:
修饰符被指定为一个可选的标志。多个标志可以通过按位 OR(|) 它们来指定。如 re.I | re.M 被设置成 I 和 M 标志

示例:

不含标志位:
>>> re.match(r'\d{2}','123')
<_sre.SRE_Match object; span=(0, 2), match='12'>
>>> re.match(r'\d{2}','ab123')
>>> print(re.match(r'\d{2}','ab123'))
None

含有标志位:
>>> re.match(r'a','ab123').group()
'a'
>>> re.match(r'a','Ab123').group()
Traceback (most recent call last):
File "<pyshell#5>", line 1, in <module>
re.match(r'a','Ab123').group()
AttributeError: 'NoneType' object has no attribute 'group'
>>> re.match(r'a','Ab123',re.I).group()
'A'
2. re.search()
扫描整个字符串并返回第一个成功的匹配对象,否则返回None
语法:re.search(pattern, string, flags=0)
示例:
>>> re.search(r'\d{2}','Ab123')
<_sre.SRE_Match object; span=(2, 4), match='12'>
>>> re.search(r'\d{2}','Abcde')
>>> print(re.search(r'\d{2}','Abcde'))
None
可以看到match()和search()返回的时match对象(即匹配对象),可以通过group()方法获得匹配内容
>>> re.search(r'\d{2}','Ab12c34d56e78').group()
'12'
>>> re.match(r'\d{2}','12c34d56e78').group(0)
'12'

group() 同group(0)就是匹配正则表达式整体结果,也就是所有匹配到的字符
group()其实更多的结合分组来使用,即如果在正则表达式中定义了分组(什么是分组?参见正则表达式学习,一个左括号“(”,表示一个分组),就可以在match对象上用group()方法提取出子串来。后面会单独写一下group()和groups()的用法,这里先简单了解一下。
re.match与re.search的区别:
re.match只匹配字符串的开始,如果字符串开始不符合正则表达式,则匹配失败,函数返回None;而re.search匹配整个字符串,直到找到一个匹配(注意:仅仅是第一个)
3. re.findall()
在字符串中找到正则表达式所匹配的所有子串,并返回一个列表,如果没有找到匹配的,则返回空列表
注意: match 和 search 是匹配一次,而findall 匹配所有
>>> re.findall(r'\d{2}','21c34d56e78')
['21', '34', '56', '78']
4. re.finditer()
和 findall 类似,在字符串中找到正则表达式所匹配的所有子串,并把它们作为一个迭代器返回.
示例:
>>> match = re.finditer(r'\d{2}','21c34d56e78')
>>> for t in match:
    print(t.group())

21
34
56
78
>>>
5. re.split()
根据正则表达式中的分隔符把字符分割为一个列表并返回成功匹配的列表.
示例:
>>> match = re.split(r'\.|-','hello-world.data')   # 使用 . 或 - 作为字符串的分隔符
>>> print(match)
['hello', 'world', 'data']
字符串也有split方法,如下,作个对比:
字符串的split方法
>>> 'a b   c'.split(' ')  # b和c之间有3个空格
['a', 'b', '', '', 'c']
如果用空格不好理解的话,可以换位x
>>> 'axbxxxc'.split('x')
['a', 'b', '', '', 'c']
>>>
可以看到,单纯用字符串的split方法无法识别连续的空格,
用正则表示式如下:
>>> re.split(r'\s+', 'a b   c')  # \s+ 表示匹配一个或多个空白符(\s表示匹配空白符,+表示重复1次或1次以上)
['a', 'b', 'c']
>>>
6. re.sub()
用于替换字符串中的匹配项
语法: re.sub(pattern, repl, string, count=0)
- pattern : 正则中的模式字符串。
- repl : 替换的字符串,也可为一个函数。
- string : 要被查找替换的原始字符串。
- count : 模式匹配后替换的最大次数,默认 0 表示替换所有的匹配。
示例:
>>> match = re.sub(r'a', 'b','aaccaa')   # 把字符串中的a都替换为b
>>> print(match)
bbccbb
>>>
参考:https://www.cnblogs.com/yan-lei/p/7653362.html和菜鸟教程
这一节主要学习一下compile()函数和group()方法
1. re.compile()
compile 函数用于编译正则表达式,生成一个正则表达式( Pattern )对象,然后就可以用编译后的正则表达式去匹配字符串
语法如下:>>> help(re.compile)
Help on function compile in module re:

compile(pattern, flags=0)
    Compile a regular expression pattern, returning a pattern object.>>>
pattern : 一个字符串形式的正则表达式 flags :可选,表示匹配模式,比如忽略大小写,多行模式等
示例:
>>> test_pattern = re.compile(r'\d{2}')   # 编译一个正则表达式,并将其赋给一个变量
>>> m = test_pattern.match('12bc34')   # 使用编译后的正则表达式对象直接匹配字符串
>>> m
<_sre.SRE_Match object; span=(0, 2), match='12'>
>>> test_pattern = re.compile(r'a\w+')  # 生成一个正则表达式对象(这里是匹配以a开头的单词)
>>> m = test_pattern.findall('apple,blue,alone,shot,attack') # 使用findall()函数匹配所有满足匹配规则的子串
>>> m
['apple', 'alone', 'attack']
2.group()和groups()
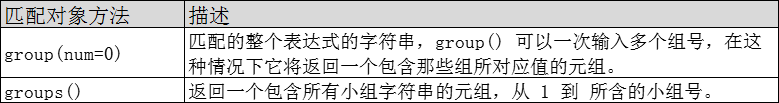
一般用match()或search()函数匹配,得到匹配对象后,需要用group()方法获得匹配内容;同时也可以提取分组截获的字符串(正则表达式中()用来分组)
示例:
>>> pattern = re.compile(r'^(\d{3})-(\d{3,8})$')  # 匹配一个3位数开头,然后一个-,然后跟着3-8位数字的字符串
>>> m = pattern.match('020-1234567')
>>> m
<_sre.SRE_Match object; span=(0, 11), match='020-1234567'>
>>> m.group()   #  显示整个匹配到的字符
'020-1234567'
>>> m.group(0)  # 同样是显示整个匹配到的字符
'020-1234567'
>>> m.group(1)   # 提取第1个分组中的子串
'020'
>>> m.group(2)   # 提取第2个分组中的子串
'1234567'
>>> m.group(3)   # 因为不存在第3个分组,所以这里会报错:没有这样的分组
Traceback (most recent call last):
  File "<pyshell#73>", line 1, in <module>
    m.group(3)
IndexError: no such group
>>> m.groups()
('020', '1234567')
>>>
2018-06-07 22:43:46
在python中使用正则表达式(转载)的更多相关文章
- Python::re 模块 -- 在Python中使用正则表达式
前言 这篇文章,并不是对正则表达式的介绍,而是对Python中如何结合re模块使用正则表达式的介绍.文章的侧重点是如何使用re模块在Python语言中使用正则表达式,对于Python表达式的语法和详细 ...
- 在Python中使用正则表达式同时匹配邮箱和电话并进行简单的分类
在Python使用正则表达式需要使用re(regular exprssion)模块,使用正则表达式的难点就在于如何写好p=re.compile(r' 正则表达式')的内容. 下面是在Python中使用 ...
- python模块 re模块与python中运用正则表达式的特点 模块知识详解
1.re模块和基础方法 2.在python中使用正则表达式的特点和问题 3.使用正则表达式的技巧 4.简单爬虫例子 一.re模块 模块引入; import re 相关知识: 1.查找: (1)find ...
- Python学习-38.Python中的正则表达式(二)
在Python中,正则表达式还有较其他编程语言有特色的地方.那就是支持松散正则表达式了. 在某些情况,正则表达式会写得十分的长,这时候,维护就成问题了.而松散正则表达式就是解决这一问题的办法. 用上一 ...
- Python学习-37.Python中的正则表达式
作为一门现代语言,正则表达式是必不可缺的,在Python中,正则表达式位于re模块. import re 这里不说正则表达式怎样去匹配,例如\d代表数字,^代表开头(也代表非,例如^a-z则不匹配任何 ...
- [Python]网络爬虫(七):Python中的正则表达式教程
转自:http://blog.csdn.net/pleasecallmewhy/article/details/8929576#t4 接下来准备用糗百做一个爬虫的小例子. 但是在这之前,先详细的整理一 ...
- [Python]网络爬虫(七):Python中的正则表达式教程(转)
接下来准备用糗百做一个爬虫的小例子. 但是在这之前,先详细的整理一下Python中的正则表达式的相关内容. 正则表达式在Python爬虫中的作用就像是老师点名时用的花名册一样,是必不可少的神兵利器. ...
- 【转载】Python中的正则表达式教程
本文http://www.cnblogs.com/huxi/archive/2010/07/04/1771073.html 正则表达式经常被用到,而自己总是记不全,转载一份完整的以备不时之需. 1. ...
- Python中的正则表达式教程
本文http://www.cnblogs.com/huxi/archive/2010/07/04/1771073.html 正则表达式经常被用到,而自己总是记不全,转载一份完整的以备不时之需. 1. ...
随机推荐
- xposed获取context 的方法
// 应用被加壳,采用这种方式加载类 try { XposedHelpers.findAndHookMethod(Application.class, "attach", Cont ...
- Iterator 其实很简单(最好理解的工厂模式的例子)
我们都知道Iterator是一个典型的工厂模式的例子.那么我们可能会被这两个名词搞晕.首先,我们会奇怪,为什么iterator可以遍历不同类型的结合,其次,出入程序猿的我们根本不知道工厂模式是什么. ...
- Linux命令——vi、cut、tr、wc、sort、uniq
vi 和 vim ^跳转当前行第一个非空字符 Ctrl + b向下翻页 Ctrl + f向上翻页 Shift + % 找到()[] {},以及在括号之间来回切换 全局替换 一次性替换文件中的所有出现的 ...
- docker在Linux环境下的安装
在Centos6.8上安装 一.查看系统版本 二.安装EPEL 因为系统自带的repo中不带docker需要安装epel rpm -Uvh http://dl.fedoraproject.org/pu ...
- web开发原生开发混合开发的区别优势
最近有人在讨论是原生开发好还是,混合开发好,以下是引用了数据来说: 最近原生应用.Web应用.混合应用的名字让我们听得比较熟悉了,现在我们就通过评析各种应用的优缺点来更进一步看看这三者的区别. 一.原 ...
- Ubuntu系统---中英文问题小记
Ubuntu系统---中英文问题小记 Ubuntu系统安装的时候,选择English版本,这样进入tty模式,中文提示不会显示乱码,终端下也是提示英文版的信息. Ubuntu 系统中文显示乱码的问题解 ...
- 深度解析Droupout与Batch Normalization
Droupout与Batch Normalization都是深度学习常用且基础的训练技巧了.本文将从理论和实践两个角度分布其特点和细节. Droupout 2012年,Hinton在其论文中提出Dro ...
- es批量导入进一对多的数据
es批量导入进一对多的数据 我有一个产品表 一个产品对应多个属性名 一个属性名对应多个属性值 一个产品还对应一个分类名称 控制层 @ApiOperation(value = "导入所有 ...
- 怎奈风云多变换,骚完一波还一波,记PHP mongodb驱动的2019年11月用法
怎么,觉得pecl下一个扩展包,phpize make make install php.ini里引用一下 mongodb.so就万事大吉了? Deeply Sorry!看到MongoDB\Driv ...
- C# Parallel 使用
ParallelLoopResult result = Parallel.For(, , i => { Console.WriteLine("{0}, task: {1}, threa ...