
Hbase扩展
1 HBase在商业项目中的能力
每天:
1) 消息量:发送和接收的消息数超过60亿
2) 将近1000亿条数据的读写
3) 高峰期每秒150万左右操作
4) 整体读取数据占有约55%,写入占有45%
5) 超过2PB的数据,涉及冗余共6PB数据
6) 数据每月大概增长300千兆字节。
2 布隆过滤器
在日常生活中,包括在设计计算机软件时,我们经常要判断一个元素是否在一个集合中。比如在字处理软件中,需要检查一个英语单词是否拼写正确(也就是要判断它是否在已知的字典中);在 FBI,一个嫌疑人的名字是否已经在嫌疑名单上;在网络爬虫里,一个网址是否被访问过等等。最直接的方法就是将集合中全部的元素存在计算机中,遇到一个新元素时,将它和集合中的元素直接比较即可。一般来讲,计算机中的集合是用哈希表(hash table)来存储的。它的好处是快速准确,缺点是费存储空间。当集合比较小时,这个问题不显著,但是当集合巨大时,哈希表存储效率低的问题就显现出来了。比如说,一个像 Yahoo,Hotmail 和 Gmai 那样的公众电子邮件(email)提供商,总是需要过滤来自发送垃圾邮件的人(spamer)的垃圾邮件。一个办法就是记录下那些发垃圾邮件的 email 地址。由于那些发送者不停地在注册新的地址,全世界少说也有几十亿个发垃圾邮件的地址,将他们都存起来则需要大量的网络服务器。如果用哈希表,每存储一亿个 email 地址, 就需要 1.6GB 的内存(用哈希表实现的具体办法是将每一个 email 地址对应成一个八字节的信息指纹googlechinablog.com/2006/08/blog-post.html,然后将这些信息指纹存入哈希表,由于哈希表的存储效率一般只有 50%,因此一个 email 地址需要占用十六个字节。一亿个地址大约要 1.6GB, 即十六亿字节的内存)。因此存贮几十亿个邮件地址可能需要上百 GB 的内存。除非是超级计算机,一般服务器是无法存储的。
布隆过滤器只需要哈希表 1/8 到 1/4 的大小就能解决同样的问题。
Bloom Filter是一种空间效率很高的随机数据结构,它利用位数组很简洁地表示一个集合,并能判断一个元素是否属于这个集合。Bloom Filter的这种高效是有一定代价的:在判断一个元素是否属于某个集合时,有可能会把不属于这个集合的元素误认为属于这个集合(false positive)。因此,Bloom Filter不适合那些“零错误”的应用场合。而在能容忍低错误率的应用场合下,Bloom Filter通过极少的错误换取了存储空间的极大节省。
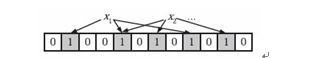
下面我们具体来看Bloom Filter是如何用位数组表示集合的。初始状态时,Bloom Filter是一个包含m位的位数组,每一位都置为0,如图

为了表达S={x1, x2,…,xn}这样一个n个元素的集合,Bloom Filter使用k个相互独立的哈希函数(Hash Function),它们分别将集合中的每个元素映射到{1,…,m}的范围中。对任意一个元素x,第i个哈希函数映射的位置hi(x)就会被置为1(1≤i≤k)。注意,如果一个位置多次被置为1,那么只有第一次会起作用,后面几次将没有任何效果。如图9-6所示,k=3,且有两个哈希函数选中同一个位置(从左边数第五位)。
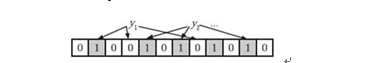
在判断y是否属于这个集合时,我们对y应用k次哈希函数,如果所有hi(y)的位置都是1(1≤i≤k),那么我们就认为y是集合中的元素,否则就认为y不是集合中的元素。如图9-7所示y1就不是集合中的元素。y2或者属于这个集合,或者刚好是一个false positive。
为了add一个元素,用k个hash function将它hash得到bloom filter中k个bit位,将这k个bit位置1。
· 为了query一个元素,即判断它是否在集合中,用k个hash function将它hash得到k个bit位。若这k bits全为1,则此元素在集合中;若其中任一位不为1,则此元素比不在集合中(因为如果在,则在add时已经把对应的k个bits位置为1)。
· 不允许remove元素,因为那样的话会把相应的k个bits位置为0,而其中很有可能有其他元素对应的位。因此remove会引入false negative,这是绝对不被允许的。
布隆过滤器决不会漏掉任何一个在黑名单中的可疑地址。但是,它有一条不足之处,也就是它有极小的可能将一个不在黑名单中的电子邮件地址判定为在黑名单中,因为有可能某个好的邮件地址正巧对应一个八个都被设置成一的二进制位。好在这种可能性很小,我们把它称为误识概率。
布隆过滤器的好处在于快速,省空间,但是有一定的误识别率,常见的补救办法是在建立一个小的白名单,存储那些可能个别误判的邮件地址。
布隆过滤器具体算法高级内容,如错误率估计,最优哈希函数个数计算,位数组大小计算,请参见http://blog.csdn.net/jiaomeng/article/details/1495500。
2 HBase2.0新特性
2017年8月22日凌晨2点左右,HBase发布了2.0.0 alpha-2,相比于上一个版本,修复了500个补丁,我们来了解一下2.0版本的HBase新特性。
最新文档:
http://hbase.apache.org/book.html#ttl
官方发布主页:
举例:
1) region进行了多份冗余
主region负责读写,从region维护在其他HregionServer中,负责读以及同步主region中的信息,如果同步不及时,是有可能出现client在从region中读到了脏数据(主region还没来得及把memstore中的变动的内容flush)。
2) 更多变动
Hbase扩展的更多相关文章
- HBase自动分区
HBase扩展和负载均衡的基本单位是Region.Region从本质上说是行的集合.当Region的大小达到一定的阈值,该Region会自动分裂(split),当然也可能是合并(merge),合并可以 ...
- HBASE学习笔记--概述
定义: HBase是一个分布式的.面向列的开源数据库,HBase是Google Bigtable的开源实现,它利用Hadoop HDFS作为其文件存储系统,利用Hadoop MapReduce来处理H ...
- [How to] 使用HBase协处理器---基本概念和regionObserver的简单实现
1. 简介 对于HBase的协处理器概念可由其官方博文了解:https://blogs.apache.org/hbase/entry/coprocessor_introduction 总体来说其包含两 ...
- HBase学习系列
转自:http://www.aboutyun.com/thread-8391-1-1.html 问题导读: 1.hbase是什么? 2.hbase原理是什么? 3.hbase使用中会遇到什么问题? 4 ...
- HBase 协处理器---基本概念和regionObserver的简单实现
1. 简介 对于HBase的协处理器概念可由其官方博文了解:https://blogs.apache.org/hbase/entry/coprocessor_introduction 总体来说其包含两 ...
- 【HBase】HBase基本介绍和基础架构
目录 基本介绍 概述 特点 HBase和Hadoop的关系 RDBMS与HBase的对比 特征 基础架构 基本介绍 概述 HBase是bigtable的开源java版本,是建立在HDFS之上,提供高可 ...
- Zookeeper的基本原理(zk架构、zk存储结构、watch机制、独立安装zk、集群间同步复制)
1.Hbase集群的高可用性与伸缩性 HBase可以实现对Regionserver的监控,当个别Regionserver不可访问时,将其负责的分区分给其他Regionsever,其转移过程较快,因为只 ...
- HBASE数据模型&扩展和负载均衡理论
示例数据模型 HBase中扩展和负载均衡的基本单元成为region,region本质上是以行健排序的连续存储区间.如果region太大,系统会把它们 自动拆分,相反的,就是把多个region合并,以减 ...
- Hbase集群扩展
当hbase集群节点不够用时,我们须要新增节点来对集群进行扩展.hbase集群的扩展是非常easy的,过程例如以下: 一.准备一台新机器作为扩展节点,这里是作为slaves15,该机子要先与maste ...
随机推荐
- 网关/负载均衡下的consul集群代理
之前有做过使用单机版的consul实现Prometheus服务注册,以为使用集群版的consul只是将consul服务地址从节点IP变为了网关IP.但比较坑的就是,当使用consul注册一个servi ...
- 快速获取更丰富的Sitecore体验数据库
无论您是否立即使用Sitecore的营销功能,我们强烈建议您执行这三项任务,以使您的数据收集更加丰富,并为您以后的决策留下良好的位置. Sitecore的体验数据库,即xDB,是Sitecore营销平 ...
- [Atcoder ARC103D]Robot Arms
题目大意:平面上有$n$个点,要求你构造$m$条边(满足$m\leqslant40$),使得可以从原点到达给定的$n$个点(边必须平行于坐标轴).并要求输出每一条边的方向,每条边必须都使用,无解输出$ ...
- Java学习:抽象方法和抽象类的使用
抽象 抽象方法:就是加上abstract关键字,然后去掉大括,直接分号结束.抽象类:抽象方法所在的类,必须是抽象类才行.在class之前写上abstract即可. 如何使用抽象类和抽象方法: 1.不能 ...
- Channel延续篇
上篇文章中介绍了NIO中的Channel,从Channel是什么.特性.分类几个方面做了下简单的介绍.但是后面Channel的分类,个人感觉不够全面,容易误导读者,特此以这篇文章加以补充. Chann ...
- 【LeetCode】633. Sum of Square Numbers
Difficulty: Easy More:[目录]LeetCode Java实现 Description https://leetcode.com/problems/sum-of-square-n ...
- 整理下log4net日志
今天整理了下log4net日志,记录一下... 日志是一个系统排错的重要组成,有在之前的.NET中,微软还没有提供过像样的日志框架,目前能用的一些框架比如Log4Net.NLog.CommonLogg ...
- SQL小技巧(一)拼音首字母的模糊查询
基于Microsoft SQL Server 的标量值函数fun_GetPy,借鉴其他优秀的博主文章,此处贴出源码,以及使用方法 1.打开新建查询,贴如下代码,F5 /****** Object: U ...
- 开源串口 Ymodem 上位机软件
概述 上位机使用Qt开发,计划整合多个工具为一体,用作以后的调试工具. 当前完成功能: 1.串口调试 支持hex和ascii 码发送,接受. 支持自动添加回车换行. 支持定时发送,最短间隔100ms, ...
- 【优化】COUNT(1)、COUNT(*)、COUNT(常量)、COUNT(主键)、COUNT(ROWID)、COUNT(非空列)、COUNT(允许为空列)、COUNT(DISTINCT 列名)
[优化]COUNT(1).COUNT(*).COUNT(常量).COUNT(主键).COUNT(ROWID).COUNT(非空列).COUNT(允许为空列).COUNT(DISTINCT 列名) 1. ...