
Hadoop:pig 安装及入门示例
pig是hadoop的一个子项目,用于简化MapReduce的开发工作,可以用更人性化的脚本方式分析数据。
一、安装
a) 下载
从官网http://pig.apache.org下载最新版本(目前是0.14.0版本),最新版本可以兼容hadop 0.x /1.x / 2.x版本,直接解压到某个目录即可。
注:下面是几个国内的镜像站点
http://mirrors.cnnic.cn/apache/pig/
http://mirror.bit.edu.cn/apache/pig/
http://mirrors.hust.edu.cn/apache/pig/
本文的解压目录是:/Users/jimmy/app/pig-0.14.0
b) 环境变量
export PIG_HOME=/Users/jimmy/app/pig-0.14.0

export HADOOP_HOME=/Users/jimmy/app/hadoop-2.6.0

export PIG_CLASSPATH=${HADOOP_HOME}/etc/hadoop/

export HADOOP_CONF_DIR=${HADOOP_HOME}/etc/hadoop

...

export PATH=${PIG_HOME}/bin:$PATH
至少要配置上面这几项,其它项比如JAVA_HOME就不必多说了,肯定也是要的。
c) 启动
$PIG_HOME/bin/pig
如果能正常进入grunt > 提示符就表示ok了
二、基本HDFS操作
pig的好处之一是简化了HDFS的操作,没有pig之前要查看一个hdfs的文件,必须$HADOOP_HOME/bin/hdfs dfs -ls /input 打一堆命令,而在pig shell交互模式下,只需要
ls /input 即可
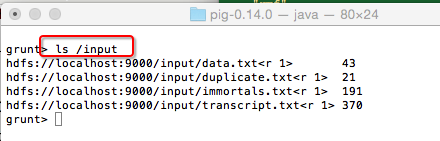
查看hdfs文件内容
cat /input/duplicate.txt
跟在linux下操作完全一样,其它命令留着大家自己去研究吧,不熟悉的可以用help查看帮助
三、基本的数据分析
在前面的文章 Hadoop: MapReduce2的几个基本示例 中,我们用JAVA编程的方式演示了几个基本例子,现在拿pig来实现一把作为对比:
a) 求Count
grunt> a = LOAD '/input/duplicate.txt' AS (value:int);
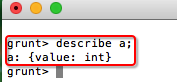
先将输入文件加载到a中,由于输入文件每行只有一个数字,最后的AS部分表示创建了一个列,名称为value,为整型,其值就是这个数字的值。
可以用describle a; 查看结构,如果要看具体值,可以用dump a;
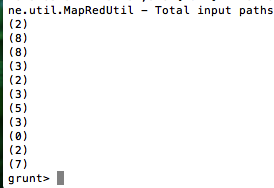
grunt> b = GROUP a all;
对a进行分组,这里由于没有指定分组条件,所以相当每一行都是分组组件,这一条命令的主要作用是实现行转列,执行完以后,可以查下b的结构和值:
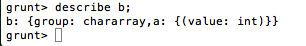
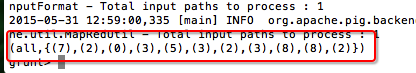
grunt> c = FOREACH b GENERATE COUNT(a.value);
由于b只有一行了,所以上面的语句其实就是求该所有a.value列的个数,即输入文件的总数。
原来用MapReduce要写一坨java代码的工作,现在用PIG只要3条命令就搞定了。
b) 求最大值(MAX)
grunt> c = FOREACH b GENERATE MAX(a.value);
c) 求平均值(AVG)
grunt> c = FOREACH b GENERATE AVG(a.value);
d) 求和(SUM)
grunt> c = FOREACH b GENERATE SUM(a.value);
e) 去重复(DISTINCT)
DISTINCT的思路跟前面略有不同,关键在于如何分组,见下面的命令:
grunt> b = GROUP a by value;
对a分组,分组依据为value值,这样重复的值就归到一组了,可以用dump b;看下结果: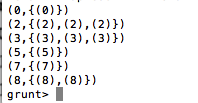
剩下的事情就好办了,把b的第一列取出来即可
grunt> c = FOREACH b GENERATE group;
处理完成,用dump c;查看结果
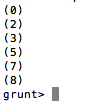
当然,对本例而言,还有一种更简单的去重方法:
grunt> b = DISTINCT a;
f) WordCount
已经有人研究过了,就直接拿来用吧,见:http://blog.itpub.net/26495863/viewspace-1348121/
grunt> a = LOAD '/input/immortals.txt' as (line:chararray); //加载输入文件,并按行分隔
grunt> words = FOREACH a GENERATE flatten(TOKENIZE(line)) as w; //将每行分割成单词
grunt> g = GROUP words by w; //按单词分组
grunt> wordcount = FOREACH g GENERATE group,COUNT(words); //单词记数
输出结果 dump wordcount;
(I,4)

(Of,1)

(am,1)

(be,3)

(do,2)

(in,1)

(it,1)

(of,1)

(to,1)

(we,3)

(But,1)

(all,1)

(are,2)

(bad,1)

(but,1)

(dog,1)

(not,1)

(say,1)

(the,4)

(way,1)

(They,1)

(best,1)

(have,1)

(what,1)

(will,2)

(your,1)

(fever,1)

(flame,1)

(guard,1)

(dreams,1)

(eternal,1)

(watcher,1)

(behavior,1)
g) wordcount2(带词频倒排序)
在刚才的示例上修改一下:
a = LOAD '/input/immortals.txt' as (line:chararray);
words = FOREACH a GENERATE flatten(TOKENIZE(line)) as w;
g = GROUP words by w;
前面这几行都不用改
wordcount = FOREACH g GENERATE group,COUNT(words) as count;//给单词数所在列加一个别名count
r = foreach wordcount generate count,group;//将结果列交换,将变成{count,word}这种结构
(4,I)

(1,Of)

(1,am)

(3,be)

(2,do)

(1,in)

(1,it)

(1,of)

(1,to)

(3,we)

(1,But)

(1,all)

(2,are)

(1,bad)

(1,but)

(1,dog)

(1,not)

(1,say)

(4,the)

(1,way)

(1,They)

(1,best)

(1,have)

(1,what)

(2,will)

(1,your)

(1,fever)

(1,flame)

(1,guard)

(1,dreams)

(1,eternal)

(1,watcher)

(1,behavior)
g2 = group r by count;//按count分组
(1,{(1,behavior),(1,watcher),(1,eternal),(1,dreams),(1,guard),(1,flame),(1,fever),(1,your),(1,what),(1,have),(1,best),(1,They),(1,way),(1,say),(1,not),(1,dog),(1,but),(1,bad),(1,all),(1,But),(1,to),(1,of),(1,it),(1,in),(1,am),(1,Of)})

(2,{(2,will),(2,are),(2,do)})

(3,{(3,we),(3,be)})

(4,{(4,I),(4,the)})
x = foreach g2 generate group,r.group;//去掉无用的列
(1,{(behavior),(watcher),(eternal),(dreams),(guard),(flame),(fever),(your),(what),(have),(best),(They),(way),(say),(not),(dog),(but),(bad),(all),(But),(to),(of),(it),(in),(am),(Of)})

(2,{(will),(are),(do)})

(3,{(we),(be)})

(4,{(I),(the)})
y = order x by group desc;//按count倒排
(4,{(I),(the)})

(3,{(we),(be)})

(2,{(will),(are),(do)})

(1,{(behavior),(watcher),(eternal),(dreams),(guard),(flame),(fever),(your),(what),(have),(best),(They),(way),(say),(not),(dog),(but),(bad),(all),(But),(to),(of),(it),(in),(am),(Of)})
最后给二个网友整理的pig用法文章地址:
hadoop pig 入门总结 http://blackproof.iteye.com/blog/1791980
pig中各种sql语句的实现 http://www.open-open.com/lib/view/open1385173281604.html
Hadoop:pig 安装及入门示例的更多相关文章
- hadoop环境安装及简单Map-Reduce示例
说明:这篇博客来自我的csdn博客,http://blog.csdn.net/lxxgreat/article/details/7753511 一.参考书:<hadoop权威指南--第二版(中文 ...
- Pig安装及简单使用(pig版本0.13.0,Hadoop版本2.5.0)
原文地址:http://www.linuxidc.com/Linux/2014-03/99055.htm 我们用MapReduce进行数据分析.当业务比较复杂的时候,使用MapReduce将会是一个很 ...
- Hadoop之Pig安装
Pig可以看做是Hadoop的客户端软件,使用Pig Latin语言可以实现排序.过滤.求和.分组等操作. Pig的安装步骤: 一.去Pig的官方网站下载.http://pig.apache.org/ ...
- hadoop生态圈安装详解(hadoop+zookeeper+hbase+pig+hive)
-------------------------------------------------------------------* 目录 * I hadoop分布式安装 * II zoo ...
- hadoop pig入门总结
在这里贴一个pig源码的分析,做pig很长时间没做笔记,不包含任何细节,以后有机会再说吧 http://blackproof.iteye.com/blog/1769219 hadoop pig入门总结 ...
- TensorFlow入门,基本介绍,基本概念,计算图,pip安装,helloworld示例,实现简单的神经网络
TensorFlow入门,基本介绍,基本概念,计算图,pip安装,helloworld示例,实现简单的神经网络
- hadoop入门篇-hadoop下载安装教程(附图文步骤)
在前几篇的文章中分别就虚拟系统安装.LINUX系统安装以及hadoop运行服务器的设置等内容写了详细的操作教程,本篇分享的是hadoop的下载安装步骤. 在此之前有必要做一个简单的说明:分享的所有内容 ...
- Hadoop Pig
Pig包括两部分: 用于描述数据流的语言,称为Pig Latin. 用于执行Pig Latin程序的执行环境,当前有两个环境:单JVM中的本地执行环境和Hadoop集群上的分布式执行环境. Pig内部 ...
- Apache Hadoop2.x 边安装边入门
完整PDF版本:<Apache Hadoop2.x边安装边入门> 目录 第一部分:Linux环境安装 第一步.配置Vmware NAT网络 一. Vmware网络模式介绍 二. NAT模式 ...
随机推荐
- Java中的基本数据类型
什么是基本数据类型 就是我们在编程的时候经常需要用到的数据类型,如整型,浮点型等,把这些数据类型专门拿出来特殊对待,并想象成所谓的“基本类型”. Java中有哪些基本数据类型
- 查看ORACLE的实际执行计划
ORACLE的执行计划分为预估执行计划和实际执行计划.其中,你用Toad.PL/SQL Developer.SQL Developer.EXPLAIN PLAN FOR或者SET ATUOTRACE ...
- 【故障处理】一次RAC故障处理过程
[故障处理]一次RAC故障处理过程 1.1 故障环境介绍 项目 source db db 类型 2节点RAC db version 11.2.0.1.0 db 存储 ASM OS版本及kernel版 ...
- 继续说一下openjson 以及 json path 的使用 (2)
在openjson 里面,其实是可以把数据类型array里面的值遍历出来的,举个栗子 ) = N' {"name":"test", "obj" ...
- SQL Server调优系列玩转篇二(如何利用汇聚联合提示(Hint)引导语句运行)
前言 上一篇我们分析了查询Hint的用法,作为调优系列的最后一个玩转模块的第一篇.有兴趣的可以点击查看:SQL Server调优系列玩转篇(如何利用查询提示(Hint)引导语句运行) 本篇继续玩转模块 ...
- scp报错:not a regular file,解决方法:加参数 -r
命令:scp -P1234 /data/aa root@192.0.0..0:/data 文件结构:/data/aa/yearmonth=2015-09 报错:not a regular fi ...
- 瘟疫公司中国版(Android)手动破解内购
前言 洒家近日下载了个瘟疫公司中国版(安卓版)(com.easymobi.plagueinc.mi ,版本 1.1.2(5)(.mi 小米版)),发现游戏需要内购而且价格不菲. 需求 root权限 文 ...
- Fragment中添加ListView而不使用ListFragment
最初的构想是,将Fragment和ViewPager结合起来, 然后突发奇想,在第一个Fragment里添加了ListView, 依照网上的建议,extends了ListFragment,接着各种报错 ...
- HowTo: Linux Server Change OR Setup The Timezone
Method 1 #tzselect # select timezone e.g. Asia/Shanghai#echo 'Asia/Shanghai' > /etc/timezone # se ...
- .Net程序员之Python基础教程学习----字符串的使用 [Second Day]
在The FirstDay 里面学习了列表的元组的使用,今天开始学习字符串的使用.字符串的使用主要要掌握,字符串的格式化(C语言中我们应该都知道,Python和C语言差别不大),字符串的基本 ...