
【Spark2.0源码学习】-9.Job提交与Task的拆分
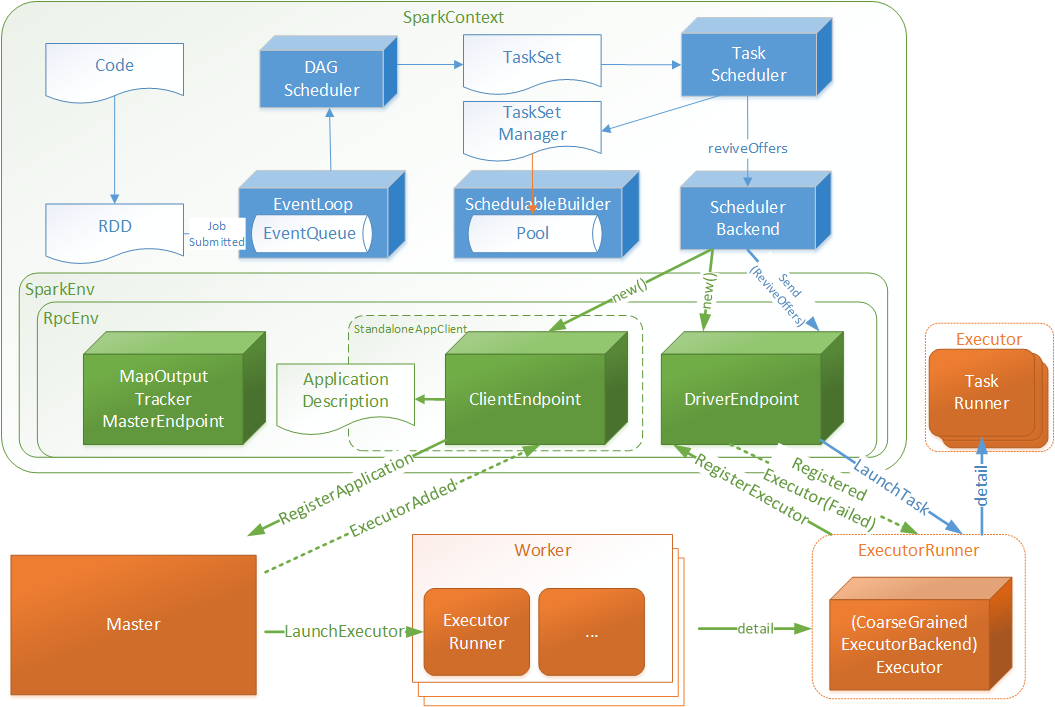

- Code:指的用户编写的代码
- RDD:弹性分布式数据集,用户编码根据SparkContext与RDD的api能够很好的将Code转化为RDD数据结构(下文将做转化细节介绍)
- DAGScheduler:有向无环图调度器,将RDD封装为JobSubmitted对象存入EventLoop(实现类DAGSchedulerEventProcessLoop)队列中
- EventLoop: 定时扫描未处理JobSubmitted对象,将JobSubmitted对象提交给DAGScheduler
- DAGScheduler:针对于JobSubmitted进行处理,最终将RDD转化为执行TaskSet,并将TaskSet提交至TaskScheduler
- TaskScheduler: 根据TaskSet创建TaskSetManager对象存入SchedulableBuilder的数据池(Pool)中,并调用DriverEndpoint唤起消费(ReviveOffers)操作
- DriverEndpoint:接受ReviveOffers指令后将TaskSet中的Tasks根据相关规则均匀分配给Executor
- Executor:启动一个TaskRunner执行一个Task

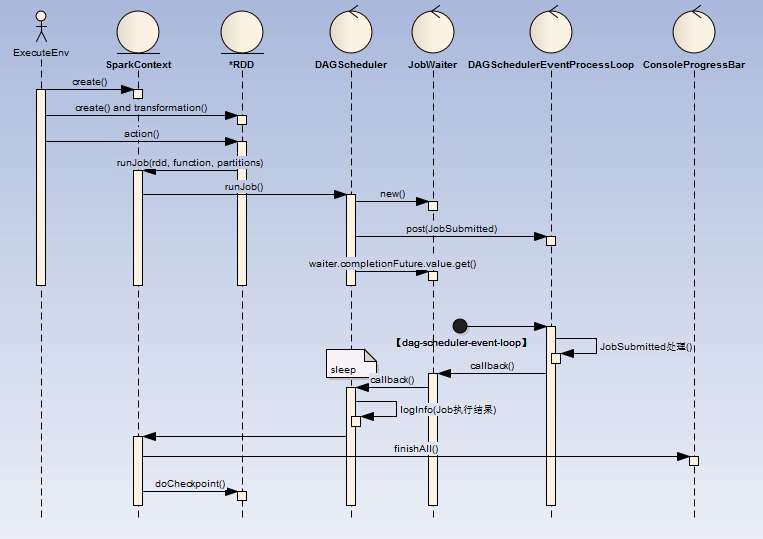
- ExecuteEnv(执行环境 )
- 这里可以是通过spark-submit提交的MainClass,也可以是spark-shell脚本
- MainClass : 代码中必定会创建或者获取一个SparkContext
- spark-shell:默认会创建一个SparkContext
- RDD(弹性分布式数据集)
- create:可以直接创建(如:sc.parallelize(1 until n, slices) ),也可以在其他地方读取(如:sc.textFile("README.md"))等
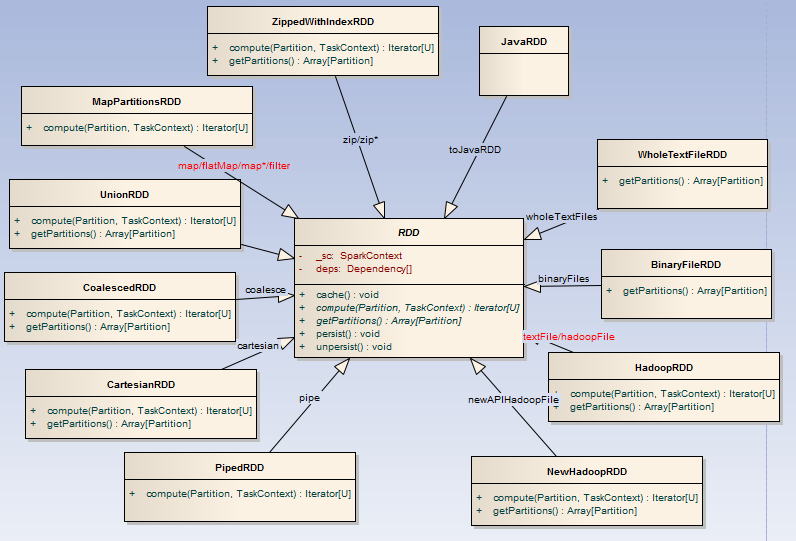
- transformation:rdd提供了一组api可以进行对已有RDD进行反复封装成为新的RDD,这里采用的是装饰者设计模式,下面为部分装饰器类图

- action:当调用RDD的action类操作方法时(collect、reduce、lookup、save ),这触发DAGScheduler的Job提交
- DAGScheduler:创建一个名为JobSubmitted的消息至DAGSchedulerEventProcessLoop阻塞消息队列(LinkedBlockingDeque)中
- DAGSchedulerEventProcessLoop:启动名为【dag-scheduler-event-loop】的线程实时消费消息队列
- 【dag-scheduler-event-loop】处理完成后回调JobWaiter
- DAGScheduler:打印Job执行结果
- JobSubmitted:相关代码如下(其中jobId为DAGScheduler全局递增Id):
eventProcessLoop.post(JobSubmitted(

  jobId, rdd, func2, partitions.toArray, callSite, waiter,

  SerializationUtils.clone(properties)))
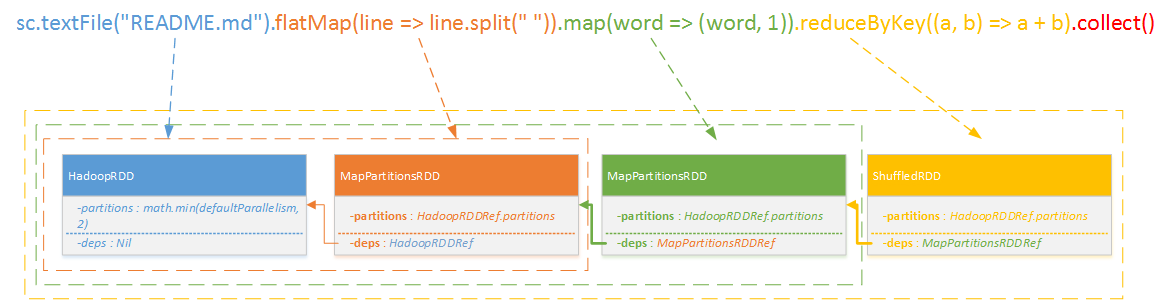
- 最终示例:

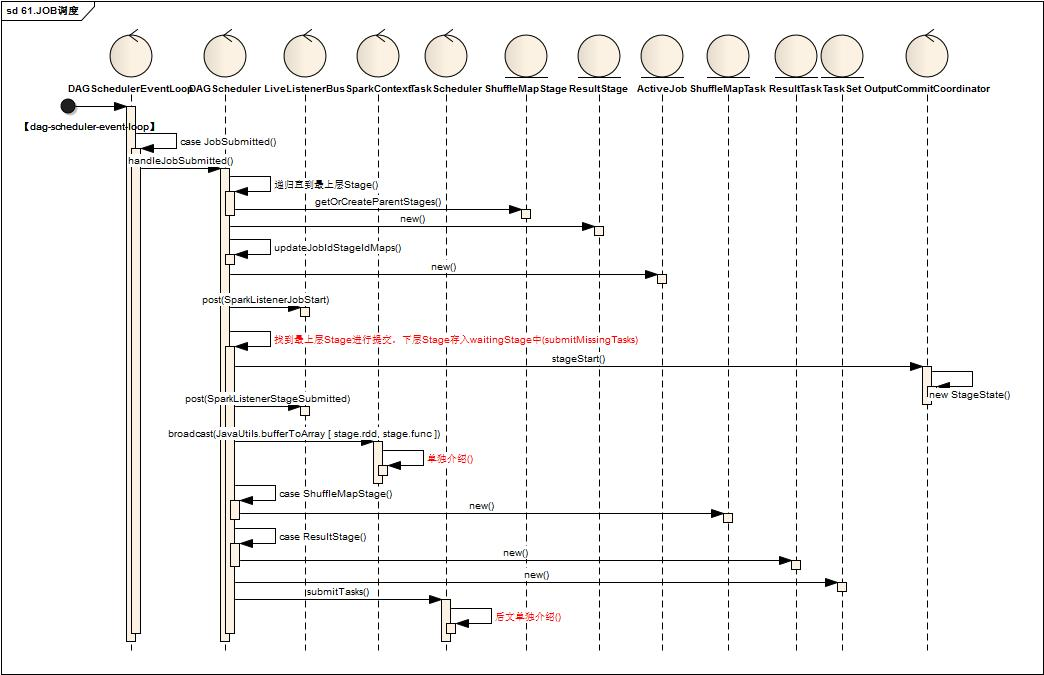

- DAGSchedulerEventProcessLoop中,线程【dag-scheduler-event-loop】处理到JobSubmitted
- 调用DAGScheduler进行handleJobSubmitted
- 首先根据RDD依赖关系依次创建Stage族,Stage分为ShuffleMapStage,ResultStage两类
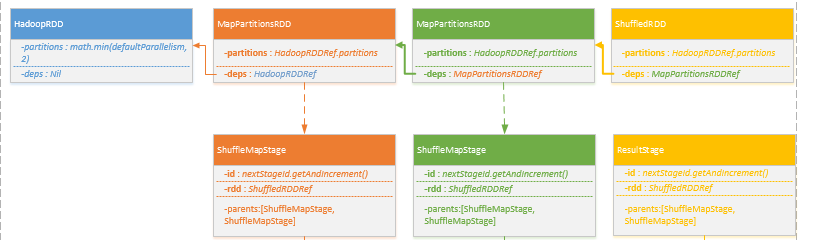

- 更新jobId与StageId关系Map
- 创建ActiveJob,调用LiveListenerBug,发送SparkListenerJobStart指令
- 找到最上层Stage进行提交,下层Stage存入waitingStage中待后续处理
- 调用OutputCommitCoordinator进行stageStart()处理
- 调用LiveListenerBug, 发送 SparkListenerStageSubmitted指令
- 调用SparkContext的broadcast方法获取Broadcast对象
- 根据Stage类型创建对应多个Task,一个Stage根据findMissingPartitions分为多个对应的Task,Task分为ShuffleMapTask,ResultTask

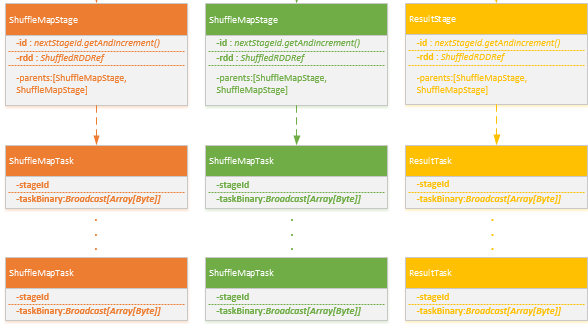
- 将Task封装为TaskSet,调用TaskScheduler.submitTasks(taskSet)进行Task调度,关键代码如下:
- 首先根据RDD依赖关系依次创建Stage族,Stage分为ShuffleMapStage,ResultStage两类
taskScheduler.submitTasks(new TaskSet(

  tasks.toArray, stage.id, stage.latestInfo.attemptId, jobId, properties))

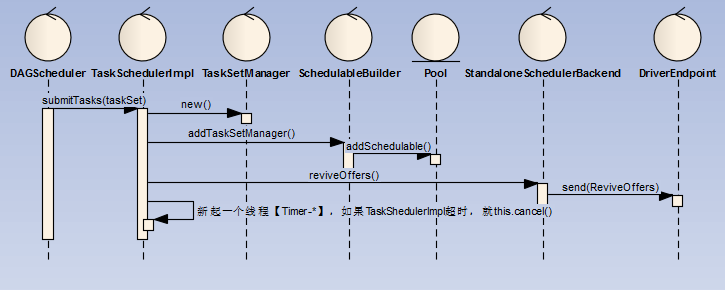
- DAGSheduler将TaskSet提交给TaskScheduler的实现类,这里是TaskChedulerImpl
- TaskSchedulerImpl创建一个TaskSetManager管理TaskSet,关键代码如下:
new TaskSetManager(this, taskSet, maxTaskFailures, blacklistTrackerOpt)
- 同时将TaskSetManager添加SchedduableBuilder的任务池Poll中
- 调用SchedulerBackend的实现类进行reviveOffers,这里是standlone模式的实现类StandaloneSchedulerBackend
- SchedulerBackend发送ReviveOffers指令至DriverEndpoint
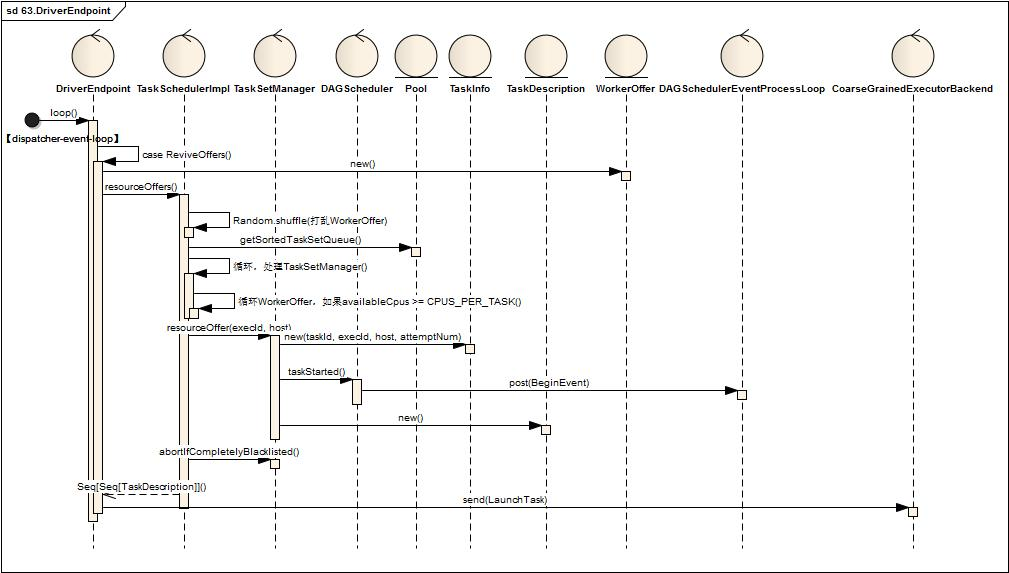

- 首先根据executorDataMap缓存信息得到可用的Executor资源信息(WorkerOffer),关键代码如下
val activeExecutors = executorDataMap.filterKeys(executorIsAlive)

val workOffers = activeExecutors.map { case (id, executorData) =>

  new WorkerOffer(id, executorData.executorHost, executorData.freeCores)

}.toIndexedSeq
- 接着调用TaskScheduler进行资源匹配,方法定义如下:
def resourceOffers(offers: IndexedSeq[WorkerOffer]): Seq[Seq[TaskDescription]] = synchronized {..}
- 将WorkerOffer资源打乱(val shuffledOffers = Random.shuffle(offers))
- 将Poo中待处理的TaskSetManager取出(val sortedTaskSets = rootPool.getSortedTaskSetQueue),
- 并循环处理sortedTaskSets并与shuffledOffers循环匹配,如果shuffledOffers(i)有足够的Cpu资源( if (availableCpus(i) >= CPUS_PER_TASK) ),调用TaskSetManager创建TaskDescription对象(taskSet.resourceOffer(execId, host, maxLocality)),最终创建了多个TaskDescription,TaskDescription定义如下:
new TaskDescription(

  taskId,

  attemptNum,

  execId,

  taskName,

  index,

  sched.sc.addedFiles,

  sched.sc.addedJars,

  task.localProperties,

  serializedTask)
- 如果TaskDescriptions不为空,循环TaskDescriptions,序列化TaskDescription对象,并向ExecutorEndpoint发送LaunchTask指令,关键代码如下:
for (task <- taskDescriptions.flatten) {

  val serializedTask = TaskDescription.encode(task)

  val executorData = executorDataMap(task.executorId)

  executorData.freeCores -= scheduler.CPUS_PER_TASK

  executorData.executorEndpoint.send(LaunchTask(new SerializableBuffer(serializedTask)))

}
【Spark2.0源码学习】-9.Job提交与Task的拆分的更多相关文章
- 【Spark2.0源码学习】-1.概述
Spark作为当前主流的分布式计算框架,其高效性.通用性.易用性使其得到广泛的关注,本系列博客不会介绍其原理.安装与使用相关知识,将会从源码角度进行深度分析,理解其背后的设计精髓,以便后续 ...
- spark2.0源码学习
[Spark2.0源码学习]-1.概述 [Spark2.0源码学习]-2.一切从脚本说起 [Spark2.0源码学习]-3.Endpoint模型介绍 [Spark2.0源码学习]-4.Master启动 ...
- 【Spark2.0源码学习】-2.一切从脚本说起
从脚本说起 在看源码之前,我们一般会看相关脚本了解其初始化信息以及Bootstrap类,Spark也不例外,而Spark我们启动三端使用的脚本如下: %SPARK_HOME%/sbin/st ...
- 【Spark2.0源码学习】-3.Endpoint模型介绍
Spark作为分布式计算框架,多个节点的设计与相互通信模式是其重要的组成部分. 一.组件概览 对源码分析,对于设计思路理解如下: RpcEndpoint: ...
- 【Spark2.0源码学习】-4.Master启动
Master作为Endpoint的具体实例,下面我们介绍一下Master启动以及OnStart指令后的相关工作 一.脚本概览 下面是一个举例: /opt/jdk1..0_79/ ...
- 【Spark2.0源码学习】-5.Worker启动
Worker作为Endpoint的具体实例,下面我们介绍一下Worker启动以及OnStart指令后的额外工作 一.脚本概览 下面是一个举例: /opt/jdk1..0_79/ ...
- 【Spark2.0源码学习】-6.Client启动
Client作为Endpoint的具体实例,下面我们介绍一下Client启动以及OnStart指令后的额外工作 一.脚本概览 下面是一个举例: /opt/jdk1..0_79/bin/jav ...
- 【Spark2.0源码学习】-10.Task执行与回馈
通过上一节内容,DriverEndpoint最终生成多个可执行的TaskDescription对象,并向各个ExecutorEndpoint发送LaunchTask指令,本节内容将关注Exe ...
- 【Spark2.0源码学习】-7.Driver与DriverRunner
承接上一节内容,Client向Master发起RequestSubmitDriver请求,Master将DriverInfo添加待调度列表中(waitingDrivers),下面针对于Dri ...
随机推荐
- 关于css解决俩边等高的问题
前段时间公司需哦一个后台管理系统,左侧是导航栏,右侧是content区域.然厚刚开始用的是js 去控制的,但是当页面的椰蓉过长的时候,有与js单线程,加载比较慢,就会有那么一个过程,查找了很多的方法都 ...
- 生成订单:三个表(Products,Orders,OrderItem)
1.有三个表(Product上,Orders,OrderItem) 分别创建对应的三个实体类 OrderItem中有外键Order_id 参考Orders中的id :Product_id参考Produ ...
- [.NET产品源码保护].NET防止反编译(非混淆加密)
.NET产品源码保护产生的背景: .NET源码加密方案支持C#及VB.NET等语言开发的ASP.NET及WINFORM应用.利用.NET支持托管代码与非托管代码共存的特性,将C#代码经过处理放于非托管 ...
- HR最喜欢问的问题_"你的职业规划是什么?"
很多面试官都会问,“你的职业规划是什么?”这个问题往往会难倒很多求职者.今天我跟大家分享,求职者怎样回答,才能更给自己加分 1.对目前自己要从事的这个岗位有清晰的认识,比如这个主要的工作是做什么的,大 ...
- Java设计模式之(建造者模式)
建造者模式:是将一个复杂的对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示. 建造者模式通常包括下面几个角色: 1. builder:抽象建造者,给出一个抽象接口,以规范产品对象的各个组 ...
- UBIFS文件系统介绍
1. 引言 UBIFS,Unsorted Block Image File System,无排序区块图像文件系统.它是用于固态硬盘存储设备上,并与LogFS相互竞争,作为JFFS2的后继文件系统之一 ...
- Transform java future into completable future 【将 future 转成 completable future】
Future is introduced in JDK 1.5 by Doug Lea to represent "the result of an asynchronous computa ...
- OC—可变数组NSMutableArray
- jQuery选择器---层次选择器总结
今天要分享的是jQuery层次选择器,层次选择器的分类如图: 接下来就开始了 要不先养养眼精神一下: 开始1.祖先选择器: 案例: <form> <label>Name:< ...
- aync await 进一步探索
aync await 进一步探索 首先来个例子 class Program { static int index = 1; static void Log(string str) { Console. ...