
python django 使用 haystack:全文检索的框架
haystack:全文检索的框架
whoosh:纯Python编写的全文搜索引擎
jieba:一款免费的中文分词包
首先安装这三个包
pip install django-haystack
pip install whoosh
pip install jieba
1.修改settings.py文件,安装应用haystack,
2.在settings.py文件中配置搜索引擎
HAYSTACK_CONNECTIONS = {

    'default': {

        # 使用whoosh引擎

        'ENGINE': 'haystack.backends.whoosh_cn_backend.WhooshEngine',

        # 索引文件路径

        'PATH': os.path.join(BASE_DIR, 'whoosh_index'),

    }

}

# 当添加、修改、删除数据时,自动生成索引

HAYSTACK_SIGNAL_PROCESSOR = 'haystack.signals.RealtimeSignalProcessor'
HAYSTACK_CONNECTIONS = {
'default': {
# 使用whoosh引擎
'ENGINE': 'haystack.backends.whoosh_cn_backend.WhooshEngine',
# 索引文件路径
'PATH': os.path.join(BASE_DIR, 'whoosh_index'),
}
}
# 当添加、修改、删除数据时,自动生成索引
HAYSTACK_SIGNAL_PROCESSOR = 'haystack.signals.RealtimeSignalProcessor'
3. 在templates目录下创建“search/indexes/blog/”目录 采用blog应用名字下面创建一个文件blog_text.txt
#指定索引的属性
{{ object.title }}
{{ object.text}}
{{ object.keywords }}
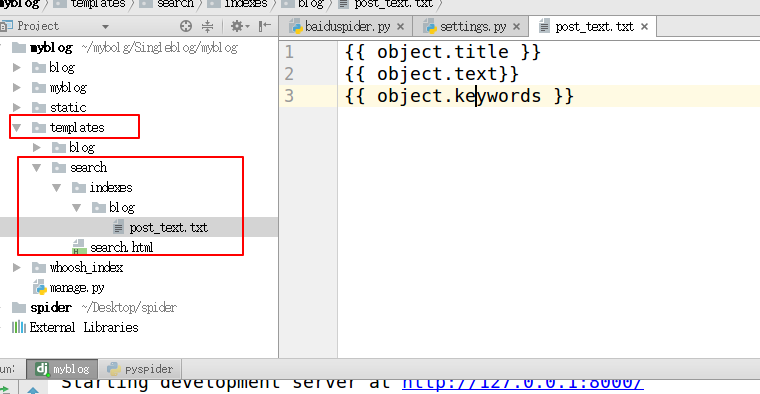
4.在需要搜索的应用下面创建search_indexes
from haystack import indexes

from models import Post #指定对于某个类的某些数据建立索引

class GoodsInfoIndex(indexes.SearchIndex, indexes.Indexable):

    text = indexes.CharField(document=True, use_template=True)

    def get_model(self):

    return Post  #搜索的模型类

    def index_queryset(self, using=None):

        return self.get_model().objects.all()
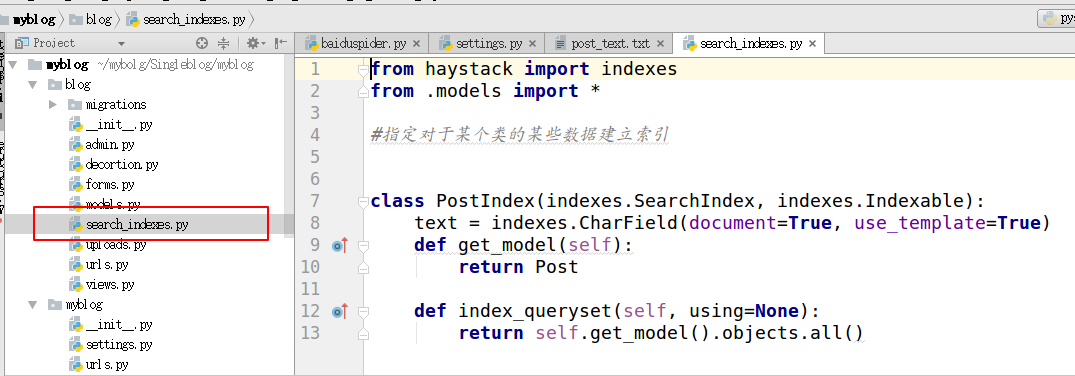
5.
1. 修改haystack文件
2. 找到虚拟环境py_django下的haystack目录 这个目录根据自己使用的python环境不同,路径也不一样。
3. site-packages/haystack/backends/ 创建一个文件名为ChineseAnalyzer.py文件写入下面代码,用于中文分词
    import jieba

from whoosh.analysis import Tokenizer, Token

    class ChineseTokenizer(Tokenizer):

    def __call__(self, value, positions=False, chars=False,

                 keeporiginal=False, removestops=True,

                 start_pos=0, start_char=0, mode='', **kwargs):

        t = Token(positions, chars, removestops=removestops, mode=mode,

                  **kwargs)

        seglist = jieba.cut(value, cut_all=True)

        for w in seglist:

            t.original = t.text = w

            t.boost = 1.0

            if positions:

                t.pos = start_pos + value.find(w)

            if chars:

                t.startchar = start_char + value.find(w)

                t.endchar = start_char + value.find(w) + len(w)

            yield t

    def ChineseAnalyzer():

    return ChineseTokenizer()
6.
1复制whoosh_backend.py文件,改为如下名称
whoosh_cn_backend.py
在复制出来的文件中导入中文分词模块
from .ChineseAnalyzer import ChineseAnalyzer
2. 更改词语分析类 改成中文
查找analyzer=StemmingAnalyzer()改为analyzer=ChineseAnalyzer()
7. 最后一步就是建初始化索引数据
python manage.py rebuild_index
8. 创建搜索模板 在templates/indexes/ 创建search.html模板
搜索结果进行分页,视图向模板中传递的上下文如下
query:搜索关键字
page:当前页的page对象
paginator:分页paginator对象
9. 在自己的应用视图中导入模块
from haystack.generic_views import SearchView
定义一个类重写get_context_data 方法,这样就可以往模板中传递自定义的上下文。
class GoodsSearchView(SearchView):
def get_context_data(self, *args, **kwargs):
context = super().get_context_data(*args, **kwargs)
context['iscart']=1
context['qwjs']=2
return context
应用的urls文件中添加这条url 将类当一个视图的方法使用 .as_view()
url('^search/$', views.BlogSearchView.as_view())
python django 使用 haystack:全文检索的框架的更多相关文章
- Django:haystack全文检索详细教程
参考:https://blog.csdn.net/AC_hell/article/details/52875927 一.安装第三方库及配置 1.1 安装插件 pip install whoosh dj ...
- Haystack全文检索框架
一.什么是Haystack Haystack是django的开源全文搜索框架(全文检索不同于特定字段的模糊查询,使用全文检索的效率更高 ),该框架支持Solr,Elasticsearch,Whoosh ...
- Python Django框架笔记(五):模型
#前言部分来自Django Book (一) 前言 大多数web应用本质上: 1. 每个页面都是将数据库的数据以HTML格式进行展现. 2. 向用户提供修改数据库数据的方法.(例如:注册.发表评 ...
- python django框架(一)
s4day63内容回顾: 1. 安装 2. 创建用户 + 授权 3. 连接 - 数据库 终端创建数据库(字符编码) - 数据表 终端 ORM pymysql create ...)engine=inn ...
- [Python] Django框架入门
说明:Django框架入门 当前项目环境:python3.5.django-1.11 项目名:test1 应用名:booktest 命令可简写为:python manager.py xxx => ...
- 利用 Python django 框架 输入汉字,数字,字符,等。。转成二维码!
利用 Python django 框架 输入汉字,数字,字符,等..转成二维码! 模块必备:Python环境 + pillow + qrcode 模块 核心代码import qrcode qr = ...
- Python Django框架笔记(六):模板
(一){%%}和{{ }} {% for post in posts %} <a href=""><h2>{{ post.title }}</h2&g ...
- Haystack全文检索
1.什么是Haystack Haystack是django的开源全文搜索框架(全文检索不同于特定字段的模糊查询,使用全文检索的效率更高 ),该框架支持Solr,Elasticsearch(java写的 ...
- django使用haystack对接Elasticsearch实现商品搜索
# 原创,转载请留言联系 前言: 在做一个商城项目的时候,需要实现商品搜索功能. 说到搜索,第一时间想到的是数据库的 select * from tb_sku where name like %苹果手 ...
随机推荐
- TensorFlow框架(3)之MNIST机器学习入门
1. MNIST数据集 1.1 概述 Tensorflow框架载tensorflow.contrib.learn.python.learn.datasets包中提供多个机器学习的数据集.本节介绍的是M ...
- open文件操作之mode模式剖析
Python可以使用open函数来实现文件的打开,关闭,读写操作: Python3中的open函数定义为: open(file, mode='r', buffering=None, encoding= ...
- JavaScrpt笔记之第三天
1.JavaScriot代码规范 代码规范通常包括以下几个方面: 变量和函数的命名规则 空格,缩进,注释的使用规则. 其他常用规范-- 规范的代码可以更易于阅读与维护. 2.命名规则 一般很多代码语言 ...
- [Caffe]使用经验积累
Caffe使用经验积累 本贴记录Caffe编译好了,使用过程的常用命令与常见错误解决方式.如果对编译过程还存在问题,请参考史上最全的caffe安装过程配置Caffe环境. 1 使用方法 训练网络 xx ...
- C# 匿名对象(匿名类型)、var、动态类型 dynamic
本文是要写的下篇<C#反射及优化用法>的前奏,不能算是下一篇文章的基础的基础吧,有兴趣的朋友可以关注一下. 随着C#的发展,该语音内容不断丰富,开发变得更加方便快捷,C# 的锋利尽显无疑. ...
- 网络协议UDP
------------------------------互联网协议与协议族------------------------------tcp/ip协议介绍:计算机网络协议,不同类型不同厂家之间的终 ...
- 关于Java的发展前景
各位看官觉得Java还能火几年?未来的发展方向是什么?
- HTTP协议知多少-关于http1.x、http2、SPDY的相关知识
作为网站开发的基础协议,我们知道浏览器上都有输出http这四个字母,这意味着什么呢? 这就是最基础的HTTP协议. 逐浪君今天为各位大人准备了一些HTTP技术的知识,来和大家分享. 以下图为例: 这一 ...
- 【DDD】领域驱动设计实践 —— 框架实现
本文主要了在社区服务系统(ECO)中基于SpringMVC+mybatis框架对DDD的落地实现.本文为系列文章中的其中一篇,其他内容可参考:通过业务系统的重构实践DDD. 框架实现图 该框架实现基本 ...
- java开发3轮技术面+hr面 面经(MT)
一直没打理博客园 发现博客园阅读量好大,就把前段时间写的一个面经也搬过来咯,大家一起加油.... 作者:小仇Eleven 链接:https://www.nowcoder.com/discuss/37 ...