
【慕课网实战】Spark Streaming实时流处理项目实战笔记十五之铭文升级版
铭文一级:[木有笔记]
铭文二级:
第12章 Spark Streaming项目实战
行为日志分析:
1.访问量的统计
2.网站黏性
3.推荐
Python实时产生数据
访问URL->IP信息->referer和状态码->日志访问时间->写入到文件中
本地与虚拟机都要装了python才能运行
重要代码:
#coding=UTF-8
#数组最后一个没有“,”
url_paths = [

  "class/128.html",

  "class/112.html",

  "class/143.html",

  "class/141.html",

  "learn/821",

  "course/list"

]#增强for循环
#sample(seq, n) 从序列seq中选择n个随机且独立的元素;

return ".".join([str(item) for item in slice])

def sample_url()

  return random.sample(url_paths,1)[0]

query_log = "{url}".format(url=sample_url())
if __name__ == '__main__':
main()
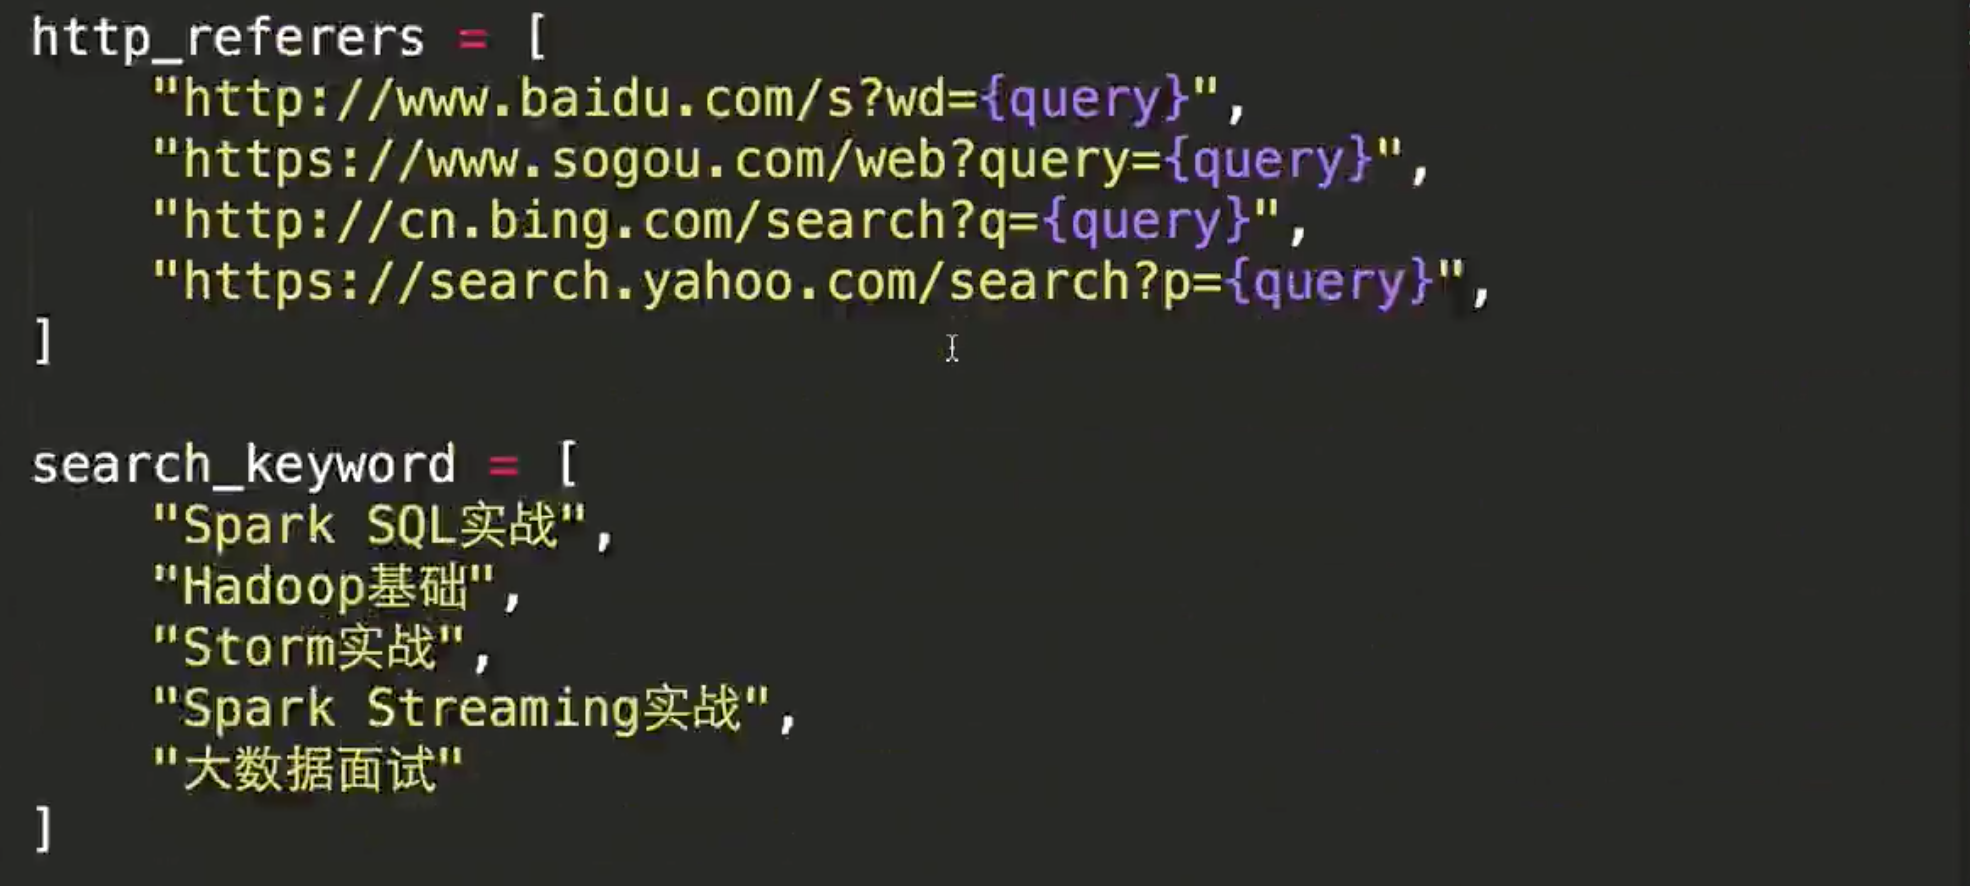
http_referers =[
"http://www.baidu.com/s?wd={query}",
"http://www.sogou.com/web?query={query}",
"http://cn.bing.com/search?q={query}",
"http://search.yahoo.com/search?p={query}"
]
time_str = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())
前面要:
import time
import random
将文件输出到一个文件:
f = open("/home/hadoop/data/project/logs/access.log","w+")
f.write(query_log + "\n")
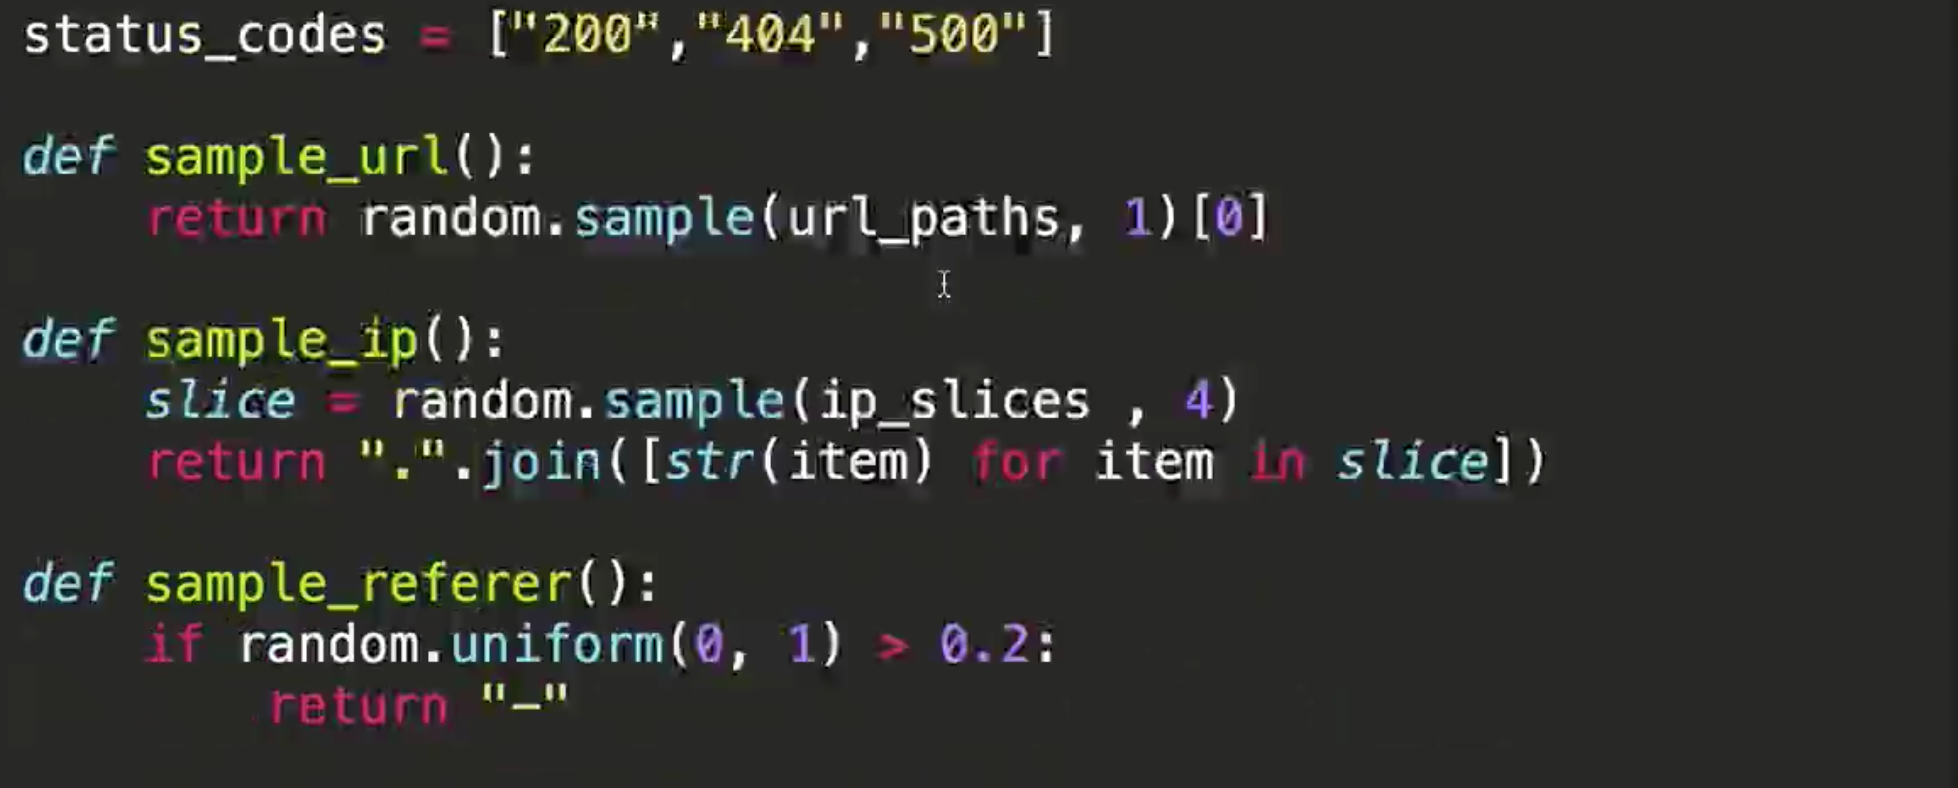
上部分参考代码:
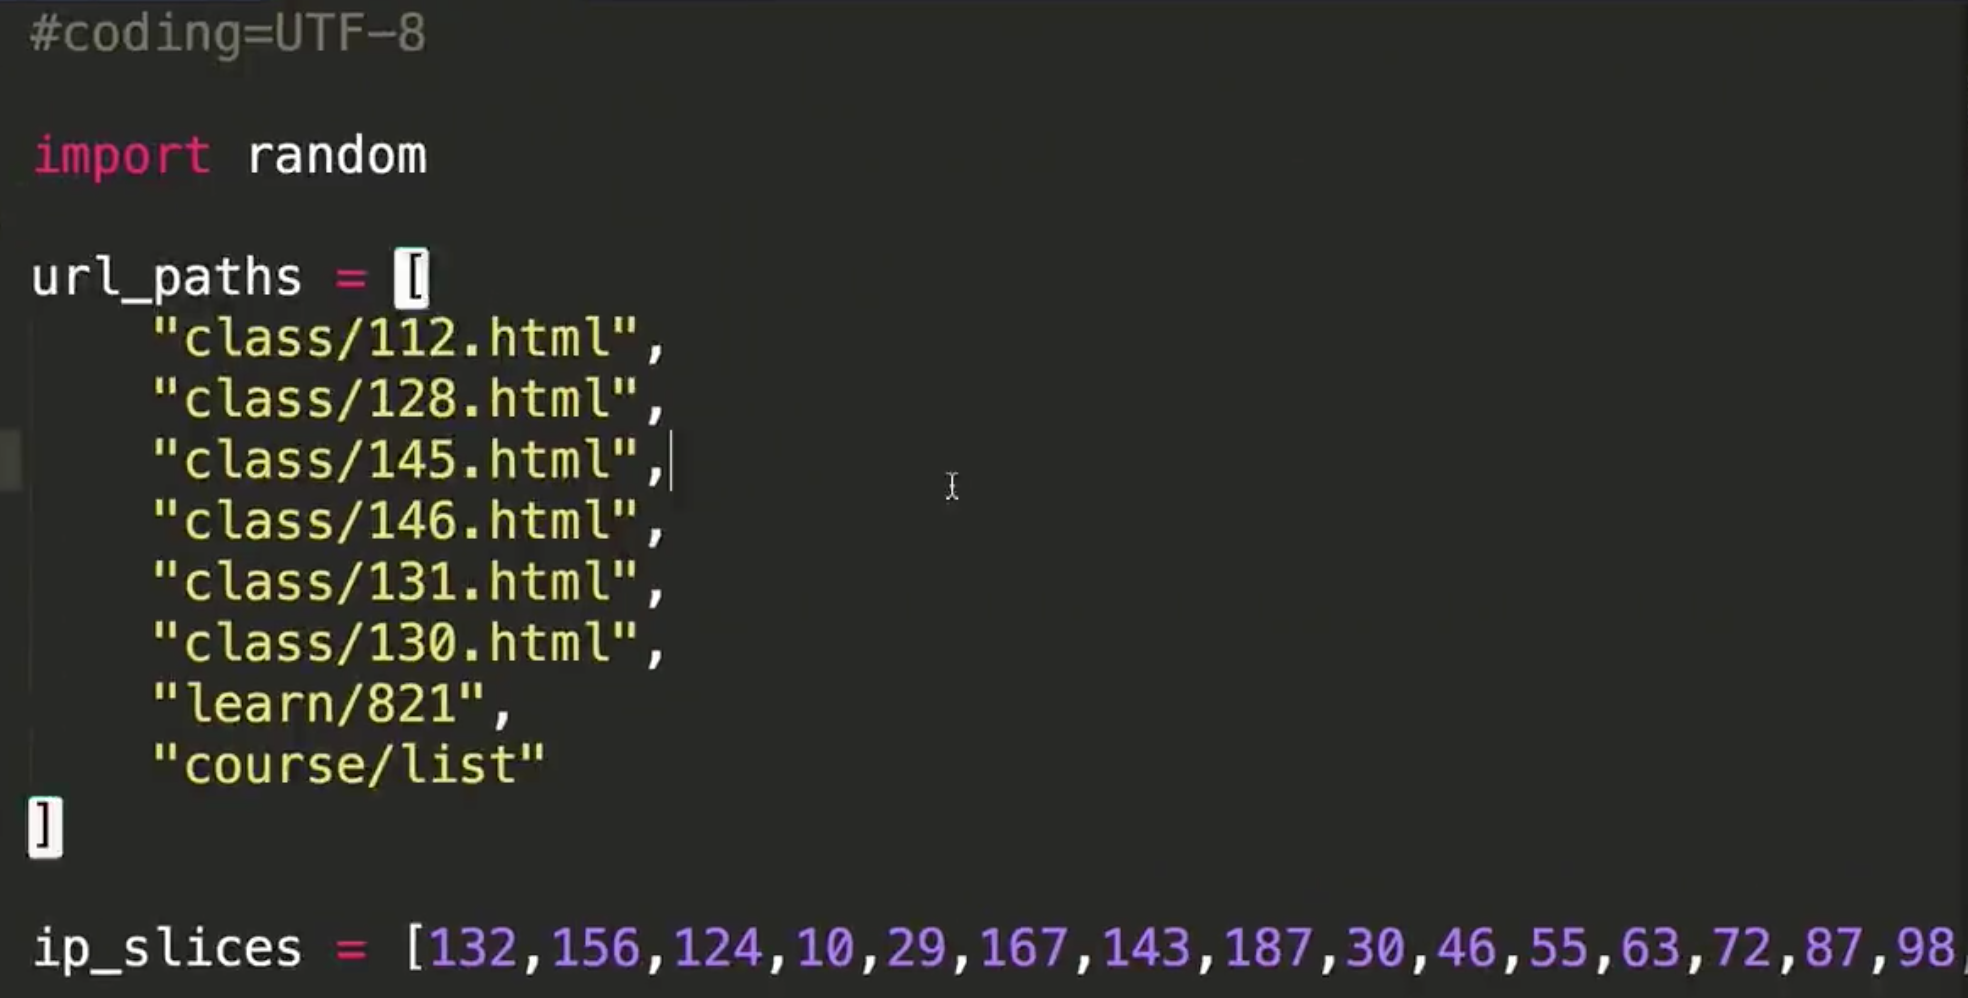
 貌似多了个逗号!!!
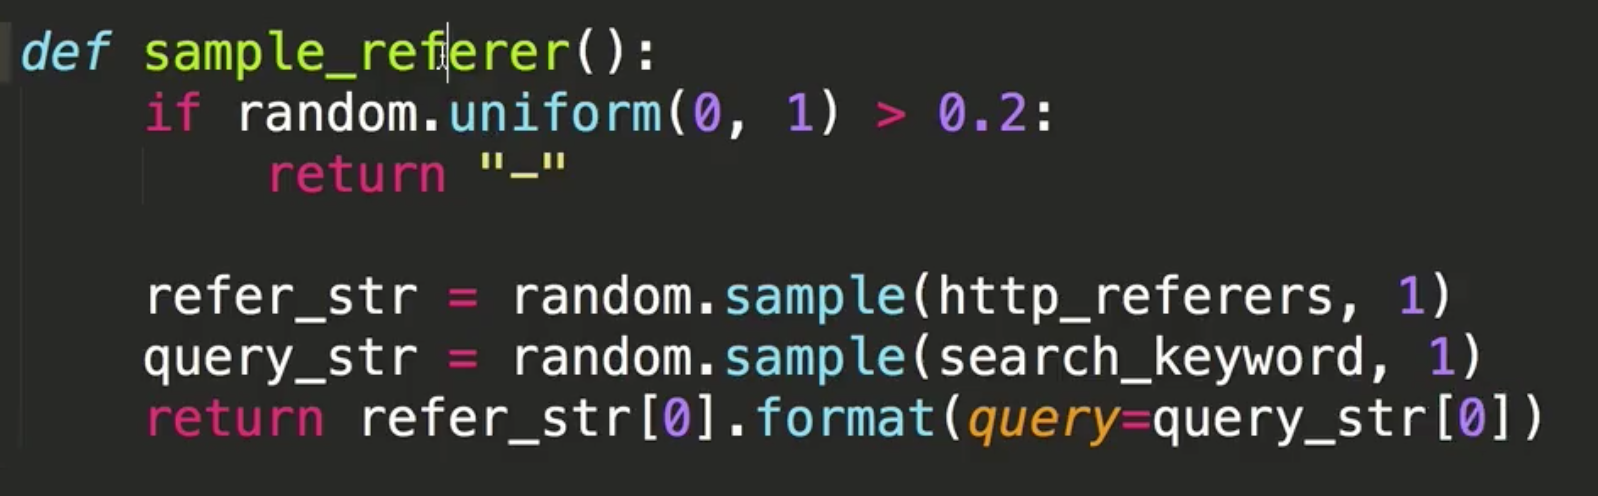
下部分参考代码:
refer_str = random.sample(http_referers, 1)
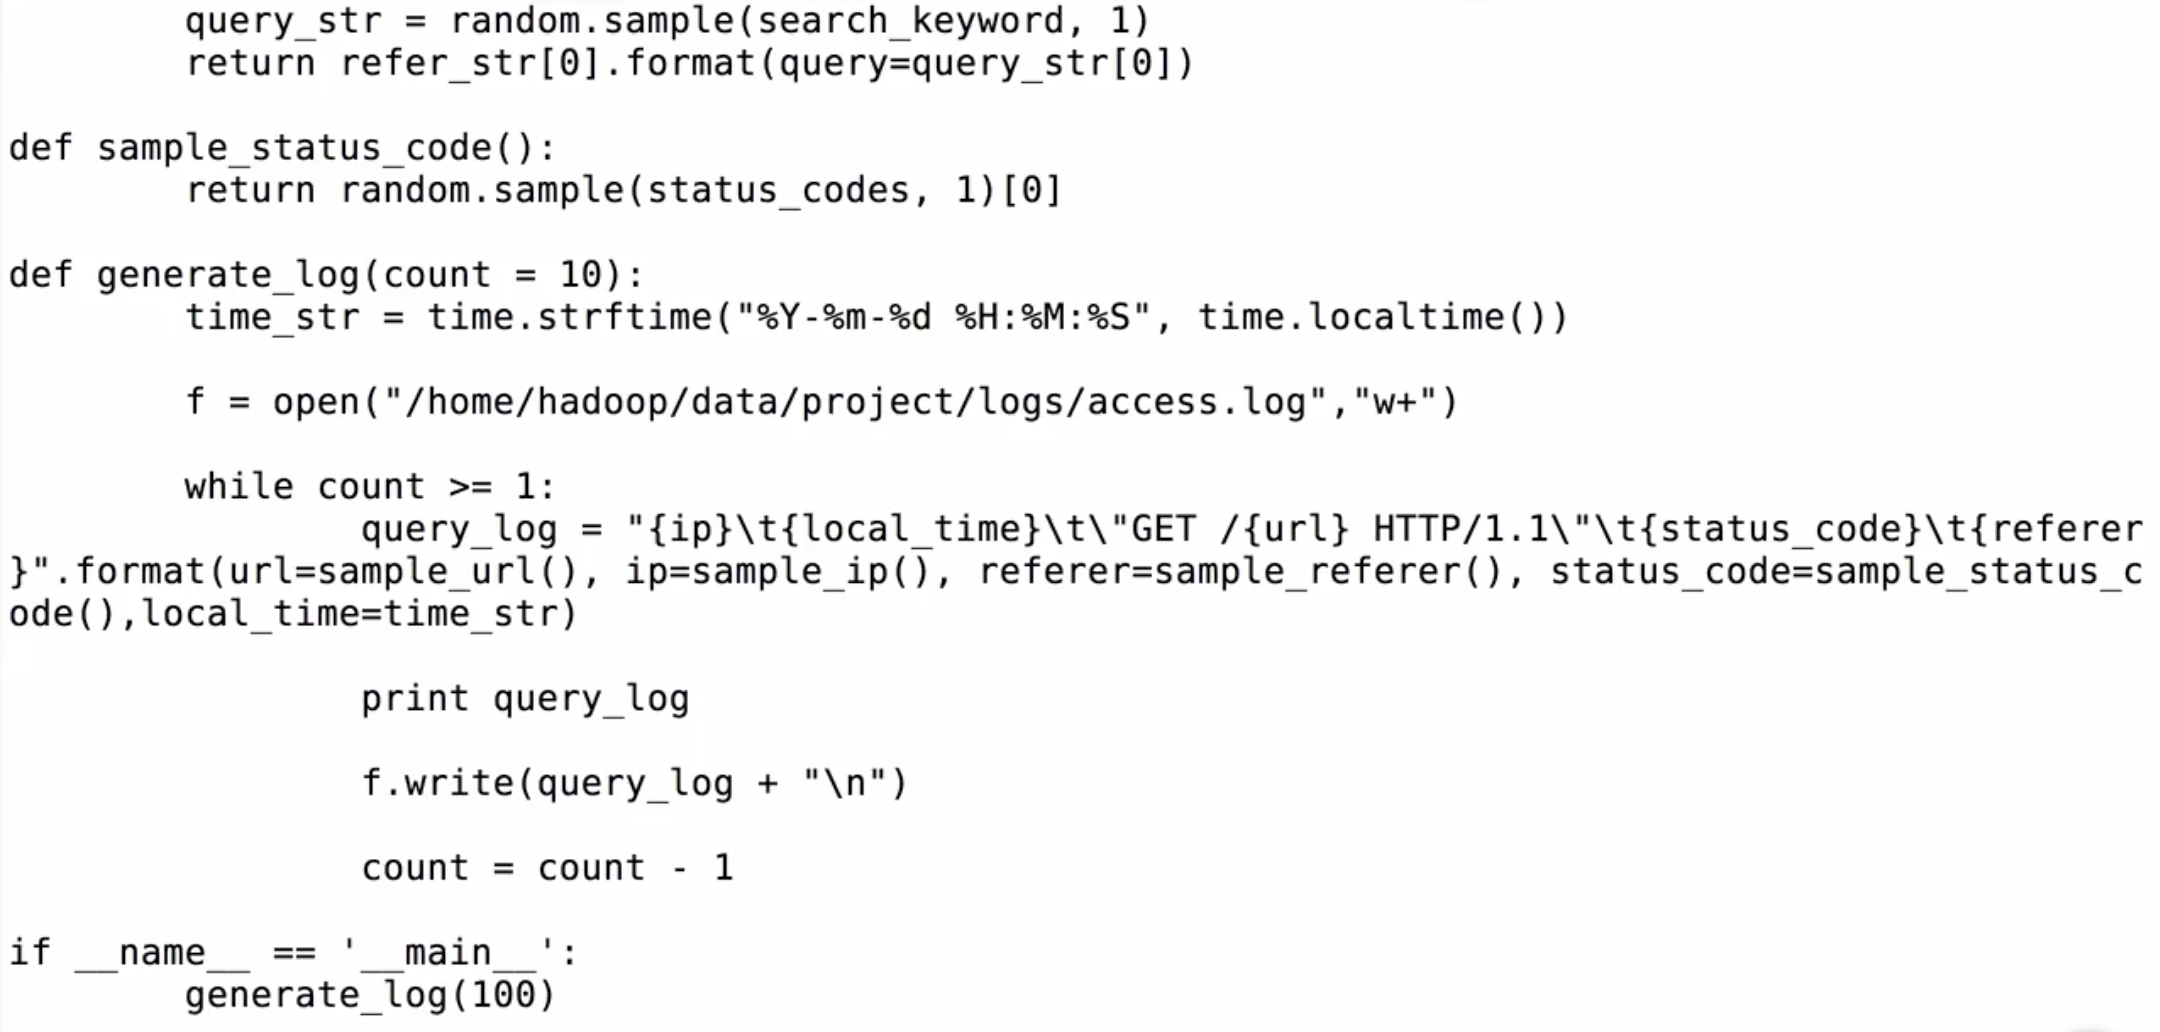
代码编辑完后,需要先创建一个logs文件夹
然后执行py文件,到logs文件夹可查看到产生的数据
查看多少条信息指令:wc -l access.log
动态添加:tail -200f access.log //然后再执行一次
铭文三级:
一张图让你学会Python基础语法(看不清可另存为):
http://blog.csdn.net/qq_30845505/article/details/51588423
python编程中的if __name__ == 'main': 的作用和原理
http://www.dengfeilong.com/post/60.html
str() 函数将对象转化为适于人阅读的形式
>>>s = 'RUNOOB'

>>> str(s)

'RUNOOB'

>>> dict = {'runoob': 'runoob.com', 'google': 'google.com'};

>>> str(dict)

"{'google': 'google.com', 'runoob': 'runoob.com'}"

>>>
但此处 ([str(item) for item in slice])意思是将数字数组转为字符数组
uniform() 方法将随机生成下一个实数,它在 [x, y) 范围内。
format函数的使用
age = 25

name = 'Caroline'

print('{0} is {1} years old. '.format(name, age)) #输出参数

print('{0} is a girl. '.format(name))

print('{0:.3} is a decimal. '.format(1/3)) #小数点后三位

print('{0:_^11} is a 11 length. '.format(name)) #使用_补齐空位

print('{first} is as {second}. '.format(first=name, second='Wendy')) #别名替换

print('My name is {0.name}'.format(open('out.txt', 'w'))) #调用方法

print('My name is {0:8}.'.format('Fred')) #指定宽度
输出:
【慕课网实战】Spark Streaming实时流处理项目实战笔记十五之铭文升级版的更多相关文章
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十之铭文升级版
铭文一级: 第八章:Spark Streaming进阶与案例实战 updateStateByKey算子需求:统计到目前为止累积出现的单词的个数(需要保持住以前的状态) java.lang.Illega ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十四之铭文升级版
铭文一级: 第11章 Spark Streaming整合Flume&Kafka打造通用流处理基础 streaming.conf agent1.sources=avro-sourceagent1 ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记二之铭文升级版
铭文一级: 第二章:初识实时流处理 需求:统计主站每个(指定)课程访问的客户端.地域信息分布 地域:ip转换 Spark SQL项目实战 客户端:useragent获取 Hadoop基础课程 ==&g ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十六之铭文升级版
铭文一级: linux crontab 网站:http://tool.lu/crontab 每一分钟执行一次的crontab表达式: */1 * * * * crontab -e */1 * * * ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十二之铭文升级版
铭文一级: ======Pull方式整合 Flume Agent的编写: flume_pull_streaming.conf simple-agent.sources = netcat-sources ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十一之铭文升级版
铭文一级: 第8章 Spark Streaming进阶与案例实战 黑名单过滤 访问日志 ==> DStream20180808,zs20180808,ls20180808,ww ==> ( ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记九之铭文升级版
铭文一级: 核心概念:StreamingContext def this(sparkContext: SparkContext, batchDuration: Duration) = { this(s ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记八之铭文升级版
铭文一级: Spark Streaming is an extension of the core Spark API that enables scalable, high-throughput, ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记七之铭文升级版
铭文一级: 第五章:实战环境搭建 Spark源码编译命令:./dev/make-distribution.sh \--name 2.6.0-cdh5.7.0 \--tgz \-Pyarn -Phado ...
随机推荐
- 协程,greenlet,gevent
""" 协程 """ ''' 协程: 类似于一个可以暂停的函数,可以多次传入数据,可以多次返回数据 协程是可交互的 耗资源大小:进程 --& ...
- ORACLE日常操作手册
转发自:http://blog.csdn.net/lichangzai/article/details/7955766 以前为开发人员编写的oracle基础操作手册,都基本的oracle操作和SQL语 ...
- mybatis sql参考
参考mybatis sql: <select id="xxx" resultType="com.xxxx.xxx.vo.xx.xx" parameterT ...
- Digital Twin的8种解读!
国际8大主流厂商对digital twin的理解,很有必要来一次汇总! 据IDC预测,2017年世界上将有40%的大型生产商都会应用虚拟仿真技术来为他们的生产过程进行建模,Digital Twin可以 ...
- Android GreenDao 在组件化项目中的一个问题 - 2018年7月5日21:15:14
组件化项目使用GreenDao时注意的事项: 1.要在组件化中的基础库(domain层)创建实体类: 2.如果sycn之后不能生产Dao文件,使用 Android Studio 的Gradle插件重新 ...
- Object.assign()怎么用?
用于对象的合并,将源对象(source)的所有可枚举属性,复制到目标对象(target). 1.以对象为参数的合并1)Object.assign方法的第一个参数是目标对象,后面的参数都是源对象 con ...
- 获取当前页面url
function getCurrUrl() { var url = ""; if (parent !== window) { try { url = window.top.loca ...
- SpringCloud-day01-简介
1.spring cloud简介 Spring Cloud是一系列框架的有序集合.它利用Spring Boot的开发便利性巧妙地简化了分布式系统基础设施的开发,如服务发现注册.配置中心.消息总线.负载 ...
- Oracle 基本语法、触发器、视图
参考文章:https://www.cnblogs.com/linjiqin/category/349944.html 数据库分类 1.小型数据库:access.foxbase 2.中型数据库:inor ...
- idea2017启动ssm项目卡在build阶段后报outofmemory
如上图,设置build process heap size(Mbytes)(构建过程堆大小(单位MB))为4000,即约4GB.之前设置的是700,修改之后问题解决. 补充:导入新项目后,此参数会初始 ...