
Python 多线程爬取站酷(zcool.com.cn)图片
极速爬取下载站酷(https://www.zcool.com.cn/)设计师/用户上传的全部照片/插画等图片。
项目地址:https://github.com/lonsty/scraper
特点:
- 极速下载:多线程异步下载,可以根据需要设置线程数
- 异常重试:只要重试次数足够多,就没有下载不下来的图片 (o)/
- 增量下载:设计师/用户有新的上传,再跑一遍程序就行了 O(∩_∩)O嗯!
- 支持代理:可以配置使用代理
环境:
python3.6及以上
1. 快速使用
1) 克隆项目到本地
git clone https://github.com/lonsty/scraper
2) 安装依赖包
cd scraper

pip install -r requirements.txt
3) 快速使用
通过用户名username下载所有图片到路径path下:
python crawler.py -u <username> -d <path>
运行截图
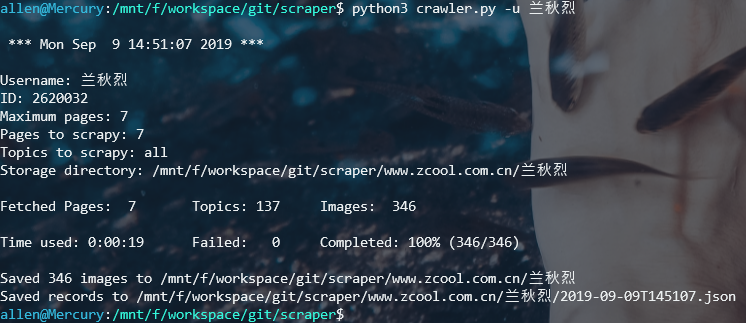
爬取结果
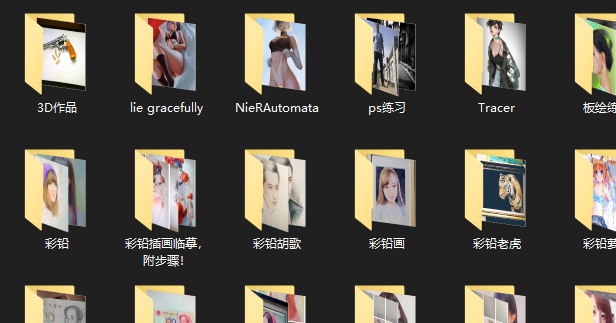
2. 使用帮助
- 查看所有命令
python crawler.py --help
Usage: crawler.py [OPTIONS]

  Use multi-threaded to download images from https://www.zcool.com.cn in

  bulk by username or ID.

Options:

  -i, --id TEXT              User id.

  -u, --username TEXT        User name.

  -d, --directory TEXT       Directory to save images.

  -p, --max-pages INTEGER    Maximum pages to parse.

  -t, --max-topics INTEGER   Maximum topics per page to parse.

  -w, --max-workers INTEGER  Maximum thread workers.  [default: 20]

  -R, --retries INTEGER      Repeat download for failed images.  [default: 3]

  -r, --redownload TEXT      Redownload images from failed records.

  -o, --override             Override existing files.  [default: False]

  --proxies TEXT             Use proxies to access websites.

                             Example:

                             '{"http": "user:passwd@www.example.com:port",

                             "https": "user:passwd@www.example.com:port"}'

  --help                     Show this message and exit.
3. 更新历史
Version 0.1.0 (2019.09.09)
主要功能:
- 极速下载:多线程异步下载,可以根据需要设置线程数
- 异常重试:只要重试次数足够多,就没有下载不下来的图片 (o)/
- 增量下载:设计师/用户有新的上传,再跑一遍程序就行了 O(∩_∩)O嗯!
- 支持代理:可以配置使用代理
Python 多线程爬取站酷(zcool.com.cn)图片的更多相关文章
- python多线程爬取斗图啦数据
python多线程爬取斗图啦网的表情数据 使用到的技术点 requests请求库 re 正则表达式 pyquery解析库,python实现的jquery threading 线程 queue 队列 ' ...
- python多线程爬取世纪佳缘女生资料并简单数据分析
一. 目标 作为一只万年单身狗,一直很好奇女生找对象的时候都在想啥呢,这事也不好意思直接问身边的女生,不然别人还以为你要跟她表白啥的,况且工科出身的自己本来接触的女生就少,即使是挨个问遍,样本量也 ...
- Python多线程爬取某网站表情包
# 爬取网络图片import requestsfrom lxml import etreefrom urllib import requestfrom queue import Queue # 导入队 ...
- 用Python爬虫爬取炉石原画卡牌图片
前段时间看了点Python的语法以及制作爬虫常用的类库,于是动手制作了一个爬虫尝试爬取一些炉石原画图片.本文仅记录对特定目标网站的分析过程和爬虫代码的编写过程.代码功能很局限,无通用性,仅作为一个一般 ...
- 【Python爬虫案例学习2】python多线程爬取youtube视频
转载:https://www.cnblogs.com/binglansky/p/8534544.html 开发环境: python2.7 + win10 开始先说一下,访问youtube需要那啥的,请 ...
- python多线程爬取-今日头条的街拍数据(附源码加思路注释)
这里用的是json+re+requests+beautifulsoup+多线程 1 import json import re from multiprocessing.pool import Poo ...
- selenium爬取优酷页面并下载图片
from selenium import webdriver import requests driver = webdriver.Chrome() #打开优酷 driver.get("ht ...
- Python爬虫入门教程: All IT eBooks多线程爬取
All IT eBooks多线程爬取-写在前面 对一个爬虫爱好者来说,或多或少都有这么一点点的收集癖 ~ 发现好的图片,发现好的书籍,发现各种能存放在电脑上的东西,都喜欢把它批量的爬取下来. 然后放着 ...
- Python爬虫之爬取站内所有图片
title date tags layut Python爬虫之爬取站内所有图片 2018-10-07 Python post 目标是 http://www.5442.com/meinv/ 如需在非li ...
随机推荐
- 【GMT43智能液晶模块】例程二十:LAN_DNS实验——域名解析
源代码下载链接: 链接:https://pan.baidu.com/s/16EW6AYpHpXljmBdNvMJM7g提取码:6lyk 复制这段内容后打开百度网盘手机App,操作更方便哦 GMT43购 ...
- 大数据web管理工具——HUE
一.概述 HUE是一个开源的Apache Hadoop UI系统,早期由Cloudera开发,后来贡献给开源社区.它是基于Python Web框架Django实现的.通过使用Hue我们可以通过浏览器方 ...
- jzy3D从入门到弃坑_4尝试使用jzy3D1.0画图失败
jzy3D从入门到弃坑_4 尝试使用jzy3D1.0画图失败 觉得有用的话,欢迎一起讨论相互学习~Follow Me 记录一下使用jzy3D1.0失败 究其原因在于 本人才疏学浅,对于JAVA ope ...
- 大数据 -- zookeeper和kafka集群环境搭建
一 运行环境 从阿里云申请三台云服务器,这里我使用了两个不同的阿里云账号去申请云服务器.我们配置三台主机名分别为zy1,zy2,zy3. 我们通过阿里云可以获取主机的公网ip地址,如下: 通过secu ...
- [原]部署kubernetes dashboard(二)
####################### 以下为声明 ##################### 此文档是之前做笔记在两台机上进行的实践,kubernetes处于不断开发阶段 不能保证每 ...
- mysql 8.0下的SELECT list is not in GROUP BY clause and contains nonaggregated column
mysql的版本 mysql> select version();+-----------+| version() |+-----------+| 8.0.12 |+-----------+ 在 ...
- SQlL Server ----- 通过年月进行查询
websit 中的代码. 不修改 对控件进行修改,展示年月 WdatePicker({ dateFmt: 'yyyy-MM', isShowToday: false, isShowClear: fa ...
- 移动APP接口安全性设计
移动APP接口是怎么保证安全性的,可以采用https,或者是非对称加密. 接口加密的目的是防止被别人用抓包工具,抓包后篡改数据. 关于加密算法常见的有对称加密(DES)和非对称加密(RSA) 对称加密 ...
- [转帖]Proof Of Work 工作量证明
Proof Of Work 工作量证明 https://www.cnblogs.com/zhang-qc/p/10451817.html 借鉴了 哈希现金(Hashcash)-1997年 英国密码学专 ...
- spring框架是怎么样通过properties来获得对象的?
首先我们要知道java获得对象的方式有四种: 1.通过new语句实例化一个对象. 2.通过反射机制创建对象. 3.通过clone()方法创建对象 3.通过反序列化的方式创建对象 在spring框架中, ...