
[Python爬虫] 之二:Selenium 调用IEDriverServer打开IE浏览器安装配置
无论是selenium2(WebDriver)还是selenium2Library,如果想要调用ie浏览器,均需以下步骤。
下载IEDriverServer。进入索引页,首先选择版本号,IEDriverServer的版本号和Selenium的版本号一定要一致,因为我选择的是selenium-3.30,所以IEDriverServer也选择的是3.30版本的。打开后的页面如下所示:

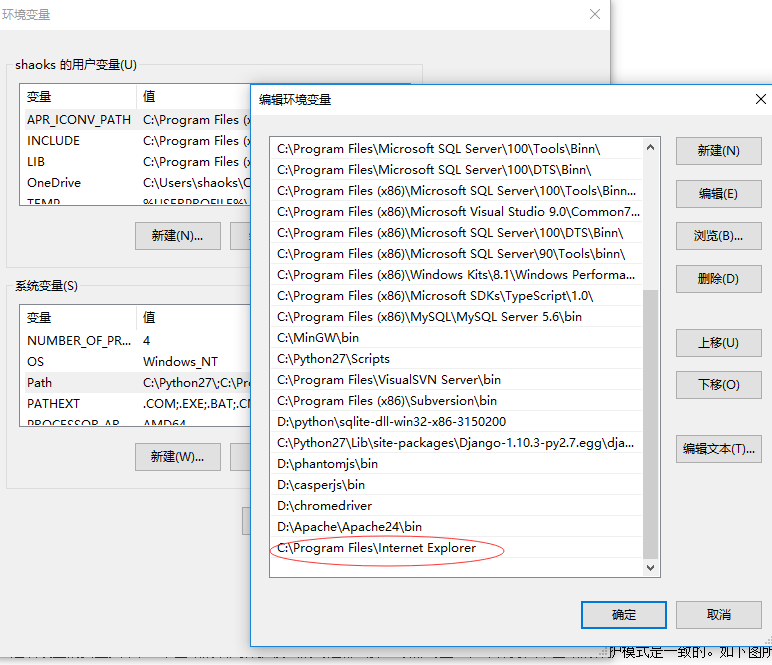
解压缩得到IEDriverServer.exe,放在IE浏览器的安装目录且同级目录下,并将其所在目录添加到环境变量

针对windows vista和windows 7上的IE7或者更高的版本,必须在IE选项设置的安全页中,4个区域的启用保护模式的勾选都去掉(或都勾上),即保持四个区域的保护模式是一致的。如下图所示:
针对IE10和更高的版本,必须在IE选项设置中的高级页中,取消增强保护模式。如下图所示:
浏览器的缩放比例必须设置为100%,这样元素定位才不会出现问题,如下图所示:
针对IE11,需要修改注册表。如果是32位的windows,key值为


HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\Internet
Explorer\Main\FeatureControl\FEATURE_BFCACHE
,如果是64位的windows,key值为
HKEY_LOCAL_MACHINE\SOFTWARE\Wow6432Node\Microsoft\Internet
Explorer\Main\FeatureControl\FEATURE_BFCACHE
如果key值不存在,就添加。之后在key内部创建一个iexplorer.exe,DWORD类型,值为0,我的windows是64位的,修改后的注册表如下图所示:

需要注意的是,修改注册表之后要重启机器,之后Selenium就可以正常打开ie浏览器。
如果浏览器还是不正常,要进行如下设置:
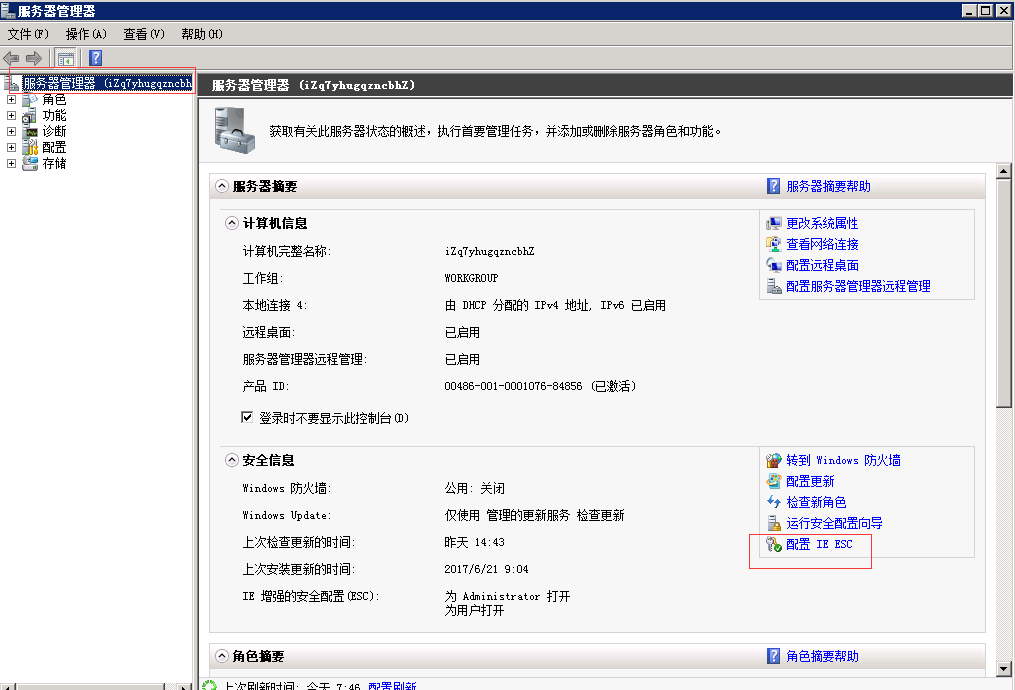

改为:
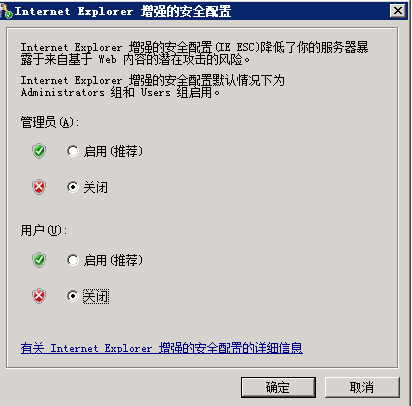
另外需要注意的时,如果进行上述设置后,下面的
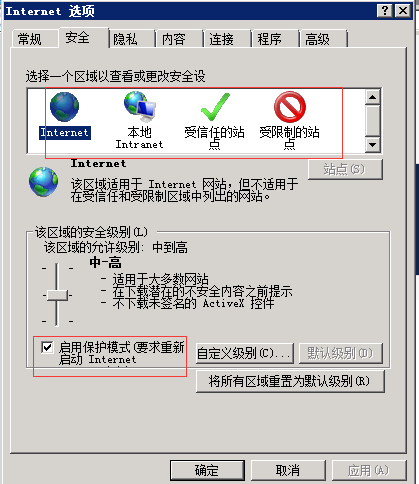
要重新设置一致,要么都选择,要都不选择。
[Python爬虫] 之二:Selenium 调用IEDriverServer打开IE浏览器安装配置的更多相关文章
- Selenium 调用IEDriverServer打开IE浏览器
Selenium 调用IEDriverServer打开IE浏览器 2016年03月30日 09:49:37 标签: selenium 14836 Selenium 调用IEDriverServer打开 ...
- [Python爬虫] 之三:Selenium 调用IEDriverServer 抓取数据
接着上一遍,在用Selenium+phantomjs 抓取数据过程中发现,有时候抓取不到,所以又测试了用Selenium+浏览器驱动的方式:具体代码如下: #coding=utf-8import os ...
- 3、Selenium调用IEDriverServer打开IE浏览器
学习Selenium时若想调用IE浏览器,均需要以下步骤 (1).http://selenium-release.storage.googleapis.com/index.html 下载IEDrive ...
- Python爬虫之设置selenium webdriver等待
Python爬虫之设置selenium webdriver等待 ajax技术出现使异步加载方式呈现数据的网站越来越多,当浏览器在加载页面时,页面上的元素可能并不是同时被加载完成,这给定位元素的定位增加 ...
- Python爬虫利器二之Beautiful Soup的用法
上一节我们介绍了正则表达式,它的内容其实还是蛮多的,如果一个正则匹配稍有差池,那可能程序就处在永久的循环之中,而且有的小伙伴们也对写正则表达式的写法用得不熟练,没关系,我们还有一个更强大的工具,叫Be ...
- python爬虫动态html selenium.webdriver
python爬虫:利用selenium.webdriver获取渲染之后的页面代码! 1 首先要下载浏览器驱动: 常用的是chromedriver 和phantomjs chromedirver下载地址 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- 2.Python爬虫入门二之爬虫基础了解
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
- Python爬虫入门二之爬虫基础了解
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
随机推荐
- Java常用工具类之MD5加密
package com.wazn.learn.util; import java.security.MessageDigest; /** * MD5加密工具类 * <功能详细描述> * * ...
- 【JAVAWEB学习笔记】11_XML
今日内容介绍 编写服务器软件,访问指定配置内容 访问tomcat下已经发布的web项目 今日内容学习目标 可以编写xml存放任意内容 通过DTD约束编写指定格式的XML 通过Schema约束编写指定格 ...
- 【SQL】175. Combine Two Tables
Table: Person +-------------+---------+ | Column Name | Type | +-------------+---------+ | PersonId ...
- luoguP4457 [BJOI2018]治疗之雨 概率期望 + 高斯消元
应该是最后一道紫色的概率了....然而颜色啥也代表不了.... 首先看懂题意: 你现在有$p$点体力,你的体力上限为$n$ 在一轮中, 1.如果你的体力没有满,你有$\frac{1}{m + 1}$的 ...
- 解决Android-studio假死机建议
背景 终于第一个ios app发布应用商店送审了,这下也有时间把以前写的android更新一版,但是很久没遇到的as假死机问题又各种折腾了一天..最终解决的方法实在是让人忍无可忍,实在是想写下来给那些 ...
- 【8.15校内测试】【队列】【manacher】
dp??不能确定转移状态.考虑用优先队列储存最优决策点,可是发现当前选择最优不能保证最后最优,在后面可以将之前用过的替换过来. 比如数据: 3 5 4 6 只储存a[i]来决策不能延展到后面的状态,因 ...
- 03-MyBatis主从实现代码读写分离应用以及实现
建立目录结构:
- JDK源码(1.7) -- java.util.Queue<E>
java.util.Queue<E> 源码分析(JDK1.7) -------------------------------------------------------------- ...
- 通过wifi上网,桥接模式下virtualBox虚拟机无法连上网的解决办法
https://jingyan.baidu.com/article/948f59242e601dd80ff5f929.html
- c# -- 解决FromsAuthentication上下文不存在
使用 FormsAuthentication.HashPasswordForStoringInConfigFile("需要加密的字符串", "MD5")这个方法 ...