
KM算法小结
最近有一个需求,主要内容如下:
APP一般刷新一次,会返回6个Item(6可能会变),每个Item都要展示一个广告,其中每个Item会发送一个请求,返回的结果是一个广告数组,比如[ad1, ad2, ad3....],不同ad含有自己的eCPM值(数值),在同一个广告数组里面,不同ad的eCPM值可以认为不会相同,但是在不同广告数组之间,可能会有相同的Ad。现在的需求是需要在6个广告数组中每一个取出一个Ad,让eCPM的和最大,但是Ad不能重复。
思考:
这道题不能简单的在每个数组内部进行排序,然后每个数组取最大值,这样的话,很可能两个数组选了同一个Ad,这在题目中是不被允许的。开始我的思路是,先针对每个数组进行从大到小的排序,如果多个数组第一个是同一个Ad,那么接着看第二个元素,第一个元素就选第二个小的那个,以此类推。但是这样室友问题的,会陷入局部最优,两个数组还好说,要是多个的话,之前你之所以选第二个元素小的那个的第一个元素,是因为你想用到第二个比较大的元素,但是针对多个,就不一定能用到了,因为你是通过多个比较出来的。
这里介绍一个算法,KM算法,可以参考:
http://www.cnblogs.com/wenruo/p/5264235.html
通过一个例子生动形象:
现在有N男N女,有些男生和女生之间互相有好感,我们将其好感程度定义为好感度,我们希望把他们两两配对,并且最后希望好感度和最大。

怎么选择最优的配对方法呢?
首先,每个女生会有一个期望值,就是与她有好感度的男生中最大的好感度。男生呢,期望值为0,就是……只要有一个妹子就可以啦,不挑~~
这样,我们把每个人的期望值标出来。

接下来,开始配对。
配对方法:
我们从第一个女生开始,分别为每一个女生找对象。
每次都从第一个男生开始,选择一个男生,使男女两人的期望和要等于两人之间的好感度。
注意:每一轮匹配,每个男生只会被尝试匹配一次!
具体匹配过程:
==============为女1找对象===============
(此时无人配对成功)
根据 “男女两人的期望和要等于两人之间的好感度”的规则
女1-男1:4+0 != 3
女1-男3:4+0 == 4
所以女1选择了男3
女1找对象成功
==============为女1找对象成功============
==============为女2找对象===============
(此时女1—男3)
根据配对原则,女2选择男3
男3有主女1,女1尝试换人
我们尝试让女1去找别人
尝试失败
为女2找对象失败!
==============为女2找对象失败============
这一轮参与匹配的人有:女1,女2,男3。
怎么办???很容易想到的,这两个女生只能降低一下期望值了,降低多少呢?
这轮
比如:女1选择男1,期望值要降低1。 女2选择男1,期望值要降低1。 女2选择男2,期望值要降低2。
于是,只要期望值降低1,就有妹子可能选择其他人。所以妹子们的期望值要降低1点。
同时,刚才被抢的男生此时非常得意,因为有妹子来抢他,于是他的期望值提高了1点(就是同妹子们降低的期望值相同)。
于是期望值变成这样(当然,不参与刚才匹配过程的人期望值不变)

==============继续为女2找对象=============
(此时女1—男3)
女2选择了男1
男1还没有被配对
女2找对象成功!
==============为女2找对象成功=============
==============为女3找对象===============
(此时女1—男3,女2-男1)
女3没有可以配对的男生……
女3找对象失败
==============为女3找对象失败============
此轮只有女3参与匹配
此时应该为女3降低期望值
降低期望值1的时候,女3-男3可以配对,所以女3降低期望值1

==============继续为女3找对象============
(此时女1—男3, 女2-男1)
女3相中了男3
此时男3已经有主女1,于是女1尝试换人
女1选择男1
而男1也已经有主女2,女2尝试换人
前面说过,每一轮匹配每个男生只被匹配一次
所以女2换人失败
女3找对象再次失败
==============为女3找对象失败============
这一轮匹配相关人员:女1,女2,女3,男1,男3
此时,只要女2降低1点期望值,就能换到男2
(前面提过 只要任意一个女生能换到任意一个没有被选择过的男生所需要降低的最小值)
我们把相应人员期望值改变一下

==============还是为女3找对象============
(此时女1—男3, 女2-男1)
女3选择了男3
男3有主女1,女1尝试换人
女1换到了男1
男1已经有主女2,女2尝试换人
女2换人男2
男2无主,匹配成功!!!
==============为女3找对象成功=============
匹配成功!!!撒花~~
到此匹配全部结束
此时
女1-男1,女2-男2,女3-男3
好感度和为最大:9
知道了这个算法以后,我们的问题怎么转化成该算法呢?在上面这个例子中,我们的左右两侧的节点个数是相同的,但是该算法针对左右两侧节点个数不同的情况同样受用,其实就可以假想为,节点连线边值为0。
在本题中,我们的左侧就是Item1到Item6,一共6个,右侧是6个广告数组中出现的所有广告Ad,我们要找的就是唯一匹配。初始化的时候,如果是Item1,它的广告数组比方是Ad1,Ad5,Ad8,这三个Ad的eCPM分别是3,6,8,那么连线的权重就是3,6,8,和其他广告连线的权重就是0。
因为我们项目是Go开发的,这里我就直接上Go的代码了,其实很好看懂。
package main

import "fmt"

const MAX = 100

const INT_MAX = int(^uint(0) >> 1)

const INT_MIN = ^INT_MAX

//const INT_MAX = 1061109567

//const INT_MIN = -1061109567

var sx []bool //记录寻找增广路时点集x,y里的点是否搜索过

var sy []bool

var match []int //match[i]记录y[i]与x[match[i]]相对应

var weight [][]int

var Cx []int

var Cy []int

func search_path(u int) bool {          //给x[u]找匹配,这个过程和匈牙利匹配是一样的

    sx[u] = true

    for v := 0; v < len(weight[0]); v++ {

        if !sy[v] && Cx[u] + Cy[v] == weight[u][v] {

            sy[v] = true

            if match[v] == -1 || search_path(match[v]) {  //如果第v个y点还没被占,或者第v个y点还可以找到其他可搭配的x点

                match[v] = u

                return true

            }

        }

    }

    return false

}

//weight是权重

func Kuhn_Munkras(max_weight bool) int {

    //如果求最小匹配,则要将边权取反

    if !max_weight {

        for i := 0; i < len(weight); i++ {

            for j := 0; j < len(weight[0]); j++ {

                weight[i][j] = -weight[i][j]

            }

        }

    }

    //初始化顶标,Cx[i]设置为max(weight[i][j] | j=0,..,n-1 ), Cy[i]=0;

    //Cy的顶标都是0

    for i := 0; i < len(Cx); i++ {

        Cx[i] = INT_MIN

        for j := 0; j < len(weight[0]); j++ {

            if Cx[i] < weight[i][j] {

                Cx[i] = weight[i][j]

            }

        }

    }

    fmt.Println(Cx, Cy)

    for i := 0; i < len(match); i++ {

        match[i] = -1

    }

    //不断修改顶标,直到找到完备匹配或完美匹配

    for u := 0; u < len(weight); u++ {   //为x里的每一个点找匹配

        for {

            for index,_ := range sx {

                sx[index] = false

            }

            for index,_ := range sy{

                sy[index] = false

            }

            if search_path(u) {//x[u]在相等子图找到了匹配,继续为下一个点找匹配

                break

            }

            //如果在相等子图里没有找到匹配,就修改顶标,直到找到匹配为止

            //首先找到修改顶标时的增量inc, min(Cx[i] + Cy [i] - weight[i][j],inc);,Cx[i]为搜索过的点,Cy[i]是未搜索过的点,因为现在是要给u找匹配,所以只需要修改找的过程中搜索过的点,增加有可能对u有帮助的边

            inc := INT_MAX

            for i :=0; i < len(weight); i++ {

                if sx[i] {

                    for j := 0;j < len(weight[0]); j++ {

                        if !sy[j] && (Cx[i] + Cy[j] - weight[i][j]) < inc {

                            inc = Cx[i] + Cy[j] - weight[i][j]

                        }

                    }

                }

            }

            //找不到可以加入的边,返回失败(即找不到完美匹配)

            if inc == INT_MAX {

                return -1

            }

            //找到增量后修改顶标,因为sx[i]与sy[j]都为真,则必然符合Cx[i] + Cy [j] =weight[i][j],然后将Cx[i]减inc,Cy[j]加inc不会改变等式,但是原来Cx[i] + Cy [j] !=weight[i][j]即sx[i]与sy[j]最多一个为真,Cx[i] + Cy [j] 就会发生改变,从而符合等式,边也就加入到相等子图中

            for i := 0; i < len(weight); i++ {

                if sx[i] { //如果点x在S集合里

                    Cx[i] -= inc

                }

            }

            for j := 0; j < len(weight[0]); j++ {

                if(sy[j]){//如果点y在T集合里

                    Cy[j] += inc

                }

            }

        }

    }

    sum := 0;

    for i := 0; i < len(weight[0]); i++ {

        if match[i] > -1 {

            sum += weight[match[i]][i]

        }

    }

    if !max_weight {

        sum = -sum

        return sum

    }

    return sum

}

func main() {

    sx = make([]bool, 3)

    sy = make([]bool, 3)

    match = make([]int, 3)

    //weight = append(weight, []int{3, 0, 4, 1})

    //weight = append(weight, []int{2, 1, 3, 1})

    //weight = append(weight, []int{0, 0, 5, 1})

    weight = [][]int{

        {3, 0, 4},

        {2, 1, 3},

        {0, 0, 5},

    }

    Cx = make([]int, 3)

    Cy = make([]int, 3)

    sum := Kuhn_Munkras(true)

    fmt.Println(sum)

    fmt.Println(match)

}
运行代码:
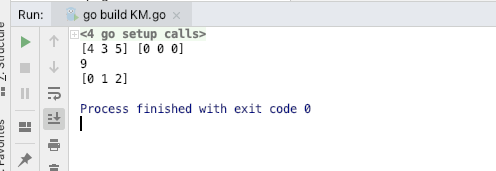
代码中都有注释,就是之前例子中的数据,可以对照着看。
应魏印福要求,我把转换二分图的过程,以及构造生成数组的过程也写出来了,如下:
package main

import (

    "fmt"

    "math/rand"

    "sort"

)

const MAX = 100

const INT_MAX = int(^uint(0) >> 1)

const INT_MIN = ^INT_MAX

//const INT_MAX = 1061109567

//const INT_MIN = -1061109567

var sx []bool //记录寻找增广路时点集x,y里的点是否搜索过

var sy []bool

var match []int //match[i]记录y[i]与x[match[i]]相对应

var weight [][]int

var Cx []int

var Cy []int

func search_path(u int) bool {          //给x[u]找匹配,这个过程和匈牙利匹配是一样的

    sx[u] = true

    for v := 0; v < len(weight[0]); v++ {

        if !sy[v] && Cx[u] + Cy[v] == weight[u][v] {

            sy[v] = true

            if match[v] == -1 || search_path(match[v]) {  //如果第v个y点还没被占,或者第v个y点还可以找到其他可搭配的x点

                match[v] = u

                return true

            }

        }

    }

    return false

}

//weight是权重

func Kuhn_Munkras(max_weight bool) int {

    //如果求最小匹配,则要将边权取反

    if !max_weight {

        for i := 0; i < len(weight); i++ {

            for j := 0; j < len(weight[0]); j++ {

                weight[i][j] = -weight[i][j]

            }

        }

    }

    //初始化顶标,Cx[i]设置为max(weight[i][j] | j=0,..,n-1 ), Cy[i]=0;

    //Cy的顶标都是0

    for i := 0; i < len(Cx); i++ {

        Cx[i] = INT_MIN

        for j := 0; j < len(weight[0]); j++ {

            if Cx[i] < weight[i][j] {

                Cx[i] = weight[i][j]

            }

        }

    }

    //fmt.Println(Cx, Cy)

    for i := 0; i < len(match); i++ {

        match[i] = -1

    }

    //不断修改顶标,直到找到完备匹配或完美匹配

    for u := 0; u < len(weight); u++ {   //为x里的每一个点找匹配

        for {

            for index,_ := range sx {

                sx[index] = false

            }

            for index,_ := range sy{

                sy[index] = false

            }

            if search_path(u) {//x[u]在相等子图找到了匹配,继续为下一个点找匹配

                break

            }

            //如果在相等子图里没有找到匹配,就修改顶标,直到找到匹配为止

            //首先找到修改顶标时的增量inc, min(Cx[i] + Cy [i] - weight[i][j],inc);,Cx[i]为搜索过的点,Cy[i]是未搜索过的点,因为现在是要给u找匹配,所以只需要修改找的过程中搜索过的点,增加有可能对u有帮助的边

            inc := INT_MAX

            for i :=0; i < len(weight); i++ {

                if sx[i] {

                    for j := 0;j < len(weight[0]); j++ {

                        if !sy[j] && (Cx[i] + Cy[j] - weight[i][j]) < inc {

                            inc = Cx[i] + Cy[j] - weight[i][j]

                        }

                    }

                }

            }

            //找不到可以加入的边,返回失败(即找不到完美匹配)

            if inc == INT_MAX {

                return -1

            }

            //找到增量后修改顶标,因为sx[i]与sy[j]都为真,则必然符合Cx[i] + Cy [j] =weight[i][j],然后将Cx[i]减inc,Cy[j]加inc不会改变等式,但是原来Cx[i] + Cy [j] !=weight[i][j]即sx[i]与sy[j]最多一个为真,Cx[i] + Cy [j] 就会发生改变,从而符合等式,边也就加入到相等子图中

            for i := 0; i < len(weight); i++ {

                if sx[i] { //如果点x在S集合里

                    Cx[i] -= inc

                }

            }

            for j := 0; j < len(weight[0]); j++ {

                if(sy[j]){//如果点y在T集合里

                    Cy[j] += inc

                }

            }

        }

    }

    sum := 0;

    for i := 0; i < len(weight[0]); i++ {

        if match[i] > -1 {

            sum += weight[match[i]][i]

        }

    }

    if !max_weight {

        sum = -sum

        return sum

    }

    return sum

}

/**

生成器

第一个参数是itemNum的数量,也是数组的个数,第二个参数是每个数组的元素个数

 */

func generater(itemNum int, num int) [][]int {

    itemList := make([][]int, 0)

    for n := 0; n < itemNum; n++ {

        list := make([]int, 0)

        for i := 0; i < num; i++ {

            rand := randInt(1, 20)

            for find(rand, list){

                rand = randInt(1, 20)

            }

            list = append(list, rand)

            sort.Sort(sort.Reverse(sort.IntSlice(list)))

        }

        itemList = append(itemList, list)

    }

    return itemList

}

//查找切片中是否存在某个数

func find(target int, list []int) bool {

    for _, num := range list {

        if num == target {

            return true

        }

    }

    return false

}

func randInt(min int, max int) int {

    return min + rand.Intn(max - min)

}

/**

初始化方法

 */

func initMethod() {

    ints := generater(6, 8)

    Cx = make([]int, len(ints))

    CyList := []int{}

    for i := 0; i < len(ints); i++ {

        for j := 0; j < len(ints[0]); j++ {

            CyList = append(CyList, ints[i][j])

        }

    }

    CyList = RemoveRepByMap(CyList)

    Cy = make([]int, len(CyList))

    //fmt.Println(len(ints))

    //fmt.Println(CyList)

    sx = make([]bool, len(ints))

    sy = make([]bool, len(CyList))

    match = make([]int, len(CyList))

    //weight = append(weight, []int{3, 0, 4, 1})

    //weight = append(weight, []int{2, 1, 3, 1})

    //weight = append(weight, []int{0, 0, 5, 1})

    weight = make([][]int, 0)

    for i := 0; i < len(ints); i++ {

        weightlist := make([]int, len(CyList))

        for j := 0; j < len(CyList); j++ {

            if find(CyList[j], ints[i]) {

                weightlist[j] = CyList[j]

            } else {

                weightlist[j] = 0

            }

        }

        weight = append(weight, weightlist)

    }

    fmt.Println("weight:", weight)

}

// 通过map主键唯一的特性过滤重复元素

func RemoveRepByMap(slc []int) []int {

    result := []int{}

    tempMap := map[int]byte{}  // 存放不重复主键

    for _, e := range slc {

        l := len(tempMap)

        tempMap[e] = 0

        if len(tempMap) != l{  // 加入map后,map长度变化,则元素不重复

            result = append(result, e)

        }

    }

    return result

}

func main() {

    initMethod()

    sum := Kuhn_Munkras(true)

    fmt.Println("sum:", sum)

    fmt.Println("match:", match)

}
参考
https://blog.csdn.net/li13168690086/article/details/81557890
https://blog.csdn.net/x_y_q_/article/details/51927054
https://www.cnblogs.com/xiaochaoqun/p/7207658.html
http://www.cnblogs.com/wenruo/p/5264235.html
KM算法小结的更多相关文章
- 二分图最大权匹配——KM算法
前言 这东西虽然我早就学过了,但是最近才发现我以前学的是假的,心中感慨万千(雾),故作此篇. 简介 带权二分图:每条边都有权值的二分图 最大权匹配:使所选边权和最大的匹配 KM算法,全称Kuhn-Mu ...
- C#排序算法小结
前言 算法这个东西其实在开发中很少用到,特别是web开发中,但是算法也很重要,因为任何的程序,任何的软件,都是由很多的算法和数据结构组成的.但是这不意味着算法对于每个软件设计人员的实际工作都是很重要的 ...
- 匈牙利算法与KM算法
匈牙利算法 var i,j,k,l,n,m,v,mm,ans:longint; a:..,..]of longint; p,f:..]of longint; function xyl(x,y:long ...
- 【HDU2255】奔小康赚大钱-KM算法
Time Limit: 1000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others) Problem Description ...
- HDU2255-奔小康赚大钱-二分图最大权值匹配-KM算法
二分图最大权值匹配问题.用KM算法. 最小权值的时候把权值设置成相反数 /*-------------------------------------------------------------- ...
- KM算法及其优化的学习笔记&&bzoj2539: [Ctsc2000]丘比特的烦恼
感谢 http://www.cnblogs.com/vongang/archive/2012/04/28/2475731.html 这篇blog里提供了3个链接……基本上很明白地把KM算法是啥讲清楚 ...
- poj 2195 KM算法
题目链接:http://poj.org/problem?id=2195 KM算法模板~ 代码如下: #include "stdio.h" #include "string ...
- hdu 2255 奔小康赚大钱--KM算法模板
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=2255 题意:有N个人跟N个房子,每个人跟房子都有一定的距离,现在要让这N个人全部回到N个房子里面去,要 ...
- HDU(2255),KM算法,最大权匹配
题目链接 奔小康赚大钱 Time Limit: 1000/1000MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others) Total Su ...
随机推荐
- 185. [USACO Oct08] 挖水井
185. [USACO Oct08] 挖水井(点击转到COGS) 输入文件:water.in 输出文件:water.out 时间限制:1 s 内存限制:128 MB 描述 农夫约翰决定给他 ...
- 转 U-BOOT之stage1
前言 本文主要是基于大家比较熟悉的 s3c2410 ,对移植 u-boot 时 stage1 过程进行一个分析,网上关于之方面的资料很多,但是几乎都只是对代码作注解,容易让人产生知其一不知其二的感觉, ...
- Windbg SOS 加载技巧(.net framwork 2.0)
1.打开windbg,加载dump.使用命令确定dump的clr版本:lm vm mscorwks 或者lm vm clr(!eeversion可以查看加载后的sos版本) 2.找到对应的mscorw ...
- Myeclispe 代码自动补全
1.Myeclispe—>Preference 2.Java->Editor->Content Assist 3.Auto activation for java 补全(.abcde ...
- C/JS_实现冒泡排序
冒泡排序算法的运作如下:(从后往前) 比较相邻的元素.如果第一个比第二个大,就交换他们两个. 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对.在这一点,最后的元素应该会是最大的数. 针对所 ...
- 微信小程序中的单位
vw:viewpoint width,视窗宽度,1vw等于视窗宽度的1%. vh:viewpoint height,视窗高度,1vh等于视窗高度的1%. rpx:rpx单位是微信小程序中css的尺寸单 ...
- mount 命令用法
mount 功能: 加载指定的文件系 统:mount可将指定设备中指定的文件系统加载到 Linux目录下(也就是装载点).可将经常使用的设备写入文件/etc/fastab,以使系 统在每次启动时自动加 ...
- springboot配置双数据源 MySQL和SqlServer
1. pom文件的驱动jar包加上去, compile 'com.microsoft.sqlserver:mssql-jdbc:6.2.2.jre8' 2. application.yml sprin ...
- 使用log4net生成日志文件
(一)使用log4net生成日志文件 1.引入log4net.dll 1.1 Nuget安装 或 http://logging.apache.org/log4net/下载log4net的源代码,编 ...
- java后台服务器启动脚本
最近由于经常在项目上线或者调试中启动服务,由于要设置环境变量这些,所以为了方便写了个启动脚本,希望能够帮助大家,也算是给自己做个小笔记: example_project_start.sh: # /bi ...