前言
在我们日常业务开发过程中,或多或少都会用到并发的功能。那么在用到并发功能的过程中,就肯定会碰到下面这个问题
通常有点年纪的程序员或许都听说这样一个说法 (其中 N 代表 CPU 的个数)
CPU 密集型应用,线程池大小设置为 N + 1
IO 密集型应用,线程池大小设置为 2N
首先我们从反面来看,假设这个说法是成立的,那我们在一台服务器上部署多少个服务都无所谓了。因为线程池的大小只能服务器的核数有关,所以这个说法是不正确的。那具体应该怎么设置大小呢?
假设这个应用是两者混合型的,其中任务即有 CPU 密集,也有 IO 密集型的,那么我们改怎么设置呢?是不是只能抛硬盘来决定呢?
那么我们到底该怎么设置线程池大小呢?有没有一些具体实践方法来指导大家落地呢?让我们来深入地了解一下。
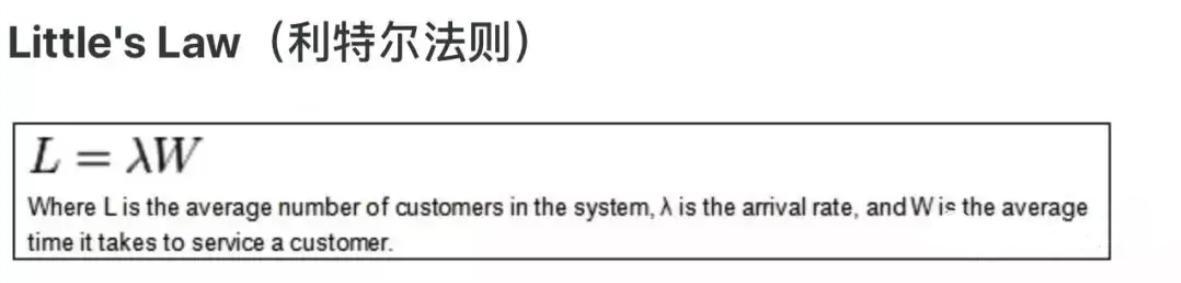
一个系统请求数等于请求的到达率与平均每个单独请求花费的时间之乘积
假设服务器单核的,对应业务需要保证请求量(QPS):10 ,真正处理一个请求需要 1 秒,那么服务器每个时刻都有 10 个请求在处理,即需要 10 个线程
同样,我们可以使用利特尔法则(Little’s law)来判定线程池大小。我们只需计算请求到达率和请求处理的平均时间。然后,将上述值放到利特尔法则(Little’s law)就可以算出系统平均请求数。估算公式如下
*线程池大小 = ((线程 IO time + 线程 CPU time )/线程 CPU time ) CPU数目**
具体实践
一个请求所消耗的时间 (线程 IO time + 线程 CPU time)
该请求计算时间 (线程 CPU time)
CPU 数目
请求消耗时间
Web 服务容器中,可以通过 Filter 来拦截获取该请求前后消耗的时间
public class MoniterFilter implements Filter { private static final Logger logger = LoggerFactory.getLogger(MoniterFilter.class); @Override public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException { long start = System.currentTimeMillis(); HttpServletRequest httpRequest = (HttpServletRequest) request; HttpServletResponse httpResponse = (HttpServletResponse) response; String uri = httpRequest.getRequestURI(); String params = getQueryString(httpRequest); try { chain.doFilter(httpRequest, httpResponse); } finally { long cost = System.currentTimeMillis() - start; logger.info("access url [{}{}], cost time [{}] ms )", uri, params, cost); } private String getQueryString(HttpServletRequest req) { StringBuilder buffer = new StringBuilder("?"); Enumeration<String> emParams = req.getParameterNames(); try { while (emParams.hasMoreElements()) { String sParam = emParams.nextElement(); String sValues = req.getParameter(sParam); buffer.append(sParam).append("=").append(sValues).append("&"); } return buffer.substring(0, buffer.length() - 1); } catch (Exception e) { logger.error("get post arguments error", buffer.toString()); } return ""; } }
CPU 计算时间
CPU 计算时间 = 请求总耗时 - CPU IO time
假设该请求有一个查询 DB 的操作,只要知道这个查询 DB 的耗时(CPU IO time),计算的时间不就出来了嘛,我们看一下怎么才能简洁,明了的记录 DB 查询的耗时。
通过(JDK 动态代理/ CGLIB)的方式添加 AOP 切面,来获取线程 IO 耗时。代码如下,请参考:
public class DaoInterceptor implements MethodInterceptor { private static final Logger logger = LoggerFactory.getLogger(DaoInterceptor.class); @Override public Object invoke(MethodInvocation invocation) throws Throwable { StopWatch watch = new StopWatch(); watch.start(); Object result = null; Throwable t = null; try { result = invocation.proceed(); } catch (Throwable e) { t = e == null ? null : e.getCause(); throw e; } finally { watch.stop(); logger.info("({}ms)", watch.getTotalTimeMillis()); } return result; } }
CPU 数目
逻辑 CPU 个数 ,设置线程池大小的时候参考的 CPU 个数
cat /proc/cpuinfo| grep "processor"| wc -l
总结
合适的配置线程池大小其实很不容易,但是通过上述的公式和具体代码,我们就能快速、落地的算出这个线程池该设置的多大。
不过最后的最后,我们还是需要通过压力测试来进行微调,只有经过压测测试的检验,我们才能最终保证的配置大小是准确的。
最后
欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!
- Java并发--线程池的使用
在前面的文章中,我们使用线程的时候就去创建一个线程,这样实现起来非常简便,但是就会有一个问题: 如果并发的线程数量很多,并且每个线程都是执行一个时间很短的任务就结束了,这样频繁创建线程就会大大降低系统 ...
- java 并发线程池的理解和使用
一.为什么要用线程池 合理利用线程池能够带来三个好处. 第一:降低资源消耗.通过重复利用已创建的线程降低线程创建和销毁造成的消耗. 第二:提高响应速度.当任务到达时,任务可以不需要的等到线程创建就能立 ...
- Java并发——线程池Executor框架
线程池 无限制的创建线程 若采用"为每个任务分配一个线程"的方式会存在一些缺陷,尤其是当需要创建大量线程时: 线程生命周期的开销非常高 资源消耗 稳定性 引入线程池 任务是一组逻辑 ...
- Java并发——线程池原理
"池"技术对我们来说是非常熟悉的一个概念,它的引入是为了在某些场景下提高系统某些关键节点性能,最典型的例子就是数据库连接池,JDBC是一种服务供应接口(SPI),具体的数据库连接实 ...
- java并发线程池---了解ThreadPoolExecutor就够了
总结:线程池的特点是,在线程的数量=corePoolSize后,仅任务队列满了之后,才会从任务队列中取出一个任务,然后构造一个新的线程,循环往复直到线程数量达到maximumPoolSize执行拒绝策 ...
- Java并发-线程池篇-附场景分析
作者:汤圆 个人博客:javalover.cc 前言 前面我们在创建线程时,都是直接new Thread(): 这样短期来看是没有问题的,但是一旦业务量增长,线程数过多,就有可能导致内存异常OOM,C ...
- Java并发—线程池框架Executor总结(转载)
为什么引入Executor线程池框架 new Thread()的缺点 每次new Thread()耗费性能 调用new Thread()创建的线程缺乏管理,被称为野线程,而且可以无限制创建,之间相互竞 ...
- Java并发 线程池
线程池技术就是事先创建一批线程,这批线程被放入到一个池子里,在没有请求到达服务端时候,这些线程都是处于待命状态,当请求到达时候,程序会从线程池里取出一个线程,这个线程处理到达的请求,请求处理完毕,该线 ...
- Java高并发 -- 线程池
Java高并发 -- 线程池 主要是学习慕课网实战视频<Java并发编程入门与高并发面试>的笔记 在使用线程池后,创建线程变成了从线程池里获得空闲线程,关闭线程变成了将线程归坏给线程池. ...
随机推荐
- php Swoole实现毫秒级定时任务
项目开发中,如果有定时任务的业务要求,我们会使用linux的crontab来解决,但是它的最小粒度是分钟级别,如果要求粒度是秒级别的,甚至毫秒级别的,crontab就无法满足,值得庆幸的是swoole ...
- 如何解决Redis缓存雪崩、缓存穿透、缓存并发等5大难题
缓存雪崩 数据未加载到缓存中,或者缓存同一时间大面积的失效,从而导致所有请求都去查数据库,导致数据库CPU和内存负载过高,甚至宕机. 比如一个雪崩的简单过程: 1.redis集群大面积故障 2.缓存失 ...
- Ajax与Http协议
目录 Ajax与Http协议详解 Xhr对象 xhr对象发送请求整体感知 xhr对象的常用属性和方法 xhr对象发送post请求 xhr对象的兼容性问题 请求超时timeout与监听超时ontimeo ...
- APACHE HADOOP安装
0.安装前准备 0.1 关闭防火墙 service iptables status service iptables stop 0.2 关闭Selinux 很多稀奇古怪的问题都是SELINUX导致的. ...
- OAuth 2.0 概念及授权流程梳理
本文可以转载,但请注明出处https://www.cnblogs.com/hellxz/p/oauth2_process.html OAuth2 的概念 OAuth是一个关于授权的开放网络标准,OAu ...
- Winows下安装RabbitMQ
RabbitMQ的简介 RabbitMQ是一套开源(MPL)的消息队列服务软件,是由 LShift 提供的一个 Advanced Message Queuing Protocol (AMQP) 的开源 ...
- react可拖动的好用的树结构插件
react tree 可拖动树结构: github地址: github地址:react-sortable-tree 安装: NPM npm install react-sortable-tree –s ...
- 月下无限连?拒绝无休止switch!
拒绝无休止switch 一.前言 前天碰到个需求,其实很简单,就是Excel导入,Excel模板长下面这样: 按我平常的逻辑是这样做的: 用文件输入流读取Excel,根据Excel的版本生成不同的对象 ...
- Python中的Base64编码的加密与解密
Base64 可以干些啥? Base64编码的作用: 由于某些系统中只能使用ASCII字符.Base64就是用来将非ASCII字符的数据转换成ASCII字符的一种方法. 图片(and种子)base64 ...
- NoSql中的CAP原则
C:一致性 .A:可用性.P:分区容错性 Partition tolerance(分区容错性): 大多数分布式系统都分布在多个子网络.每个子网络就叫做一个区(partition).分区容错的意思是,区 ...