
elasticsearch7.5.0+kibana-7.5.0+cerebro-0.8.5集群生产环境安装配置及通过elasticsearch-migration工具做新老集群数据迁移
一、服务器准备
目前有两台128G内存服务器,故准备每台启动两个es实例,再加一台虚机,共五个节点,保证down一台服务器两个节点数据不受影响。
二、系统初始化
参见我上一篇kafka系统初始化:https://www.cnblogs.com/mkxfs/p/12030331.html
三、安装elasticsearch7.5.0
1.因zookeeper和kafka需要java启动
首先安装jdk1.8环境
yum install java-1.8.0-openjdk-devel.x86_64 -y
2.官网下载es7.5.0
cd /opt
wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-7.5.0-linux-x86_64.tar.gz
tar -zxf elasticsearch-7.5.0-linux-x86_64.tar.gz
mv elasticsearch-7.5.0 elasticsearch9300
创建es数据目录
mkdir -p /data/es9300
mkdir -p /data/es9301
3.修改es配置文件
vim /opt/elasticsearch9300/config/elasticsearch.yml
最后添加:
cluster.name: en-es
node.name: node-1
path.data: /data/es9300
path.logs: /opt/elasticsearch9300/logs
bootstrap.memory_lock: true
network.host: 0.0.0.0
http.port: 9200
transport.tcp.port: 9300
cluster.routing.allocation.same_shard.host: true
cluster.initial_master_nodes: ["192.168.0.16:9300", "192.168.0.16:9301","192.168.0.17:9300", "192.168.0.17:9301","192.168.0.18:9300"]
discovery.zen.ping.unicast.hosts: ["192.168.0.16:9300", "192.168.0.16:9301","192.168.0.17:9300", "192.168.0.17:9301", "192.168.0.18:9300"]
discovery.zen.minimum_master_nodes: 3
node.max_local_storage_nodes: 2
http.cors.enabled: true
http.cors.allow-origin: "*"
http.cors.allow-credentials: true
http.cors.allow-headers: Authorization,X-Requested-With,Content-Length,Content-Type
4.修改jvm堆内存大小
vim /opt/elasticsearch9300/config/jvm.options
-Xms25g
-Xmx25g
5.部署本机第二个节点
cp -r /opt/elasticsearch9300 /opt/elasticsearch9301
vim /opt/elasticsearch9301/config/elasticsearch.yml
最后添加:
cluster.name: en-es
node.name: node-2
path.data: /data/es9301
path.logs: /opt/elasticsearch9301/logs
bootstrap.memory_lock: true
network.host: 0.0.0.0
http.port: 9201
transport.tcp.port: 9301
cluster.routing.allocation.same_shard.host: true
cluster.initial_master_nodes: ["192.168.0.16:9300", "192.168.0.16:9301","192.168.0.17:9300", "192.168.0.17:9301", "192.168.0.18:9300"]
discovery.zen.ping.unicast.hosts: ["192.168.0.16:9300", "192.168.0.16:9301","192.168.0.17:9300", "192.168.0.17:9301", "192.168.0.18:9300"]
discovery.zen.minimum_master_nodes: 3
node.max_local_storage_nodes: 2
http.cors.enabled: true
http.cors.allow-origin: "*"
http.cors.allow-credentials: true
http.cors.allow-headers: Authorization,X-Requested-With,Content-Length,Content-Type
6.继续安装其他三个节点,注意端口号
7.启动elasticsearch服务
因为elasticsearch不允许root用户启动,故添加es账号
groupadd es
useradd es -g es
授权es目录给es用户
chown -R es:es es9300
chown -R es:es es9301
chown -R es:es /data/es9300
chown -R es:es /data/es9301
启动es服务
su - es -c "/opt/elasticsearch9300/bin/elasticsearch -d"
su - es -c "/opt/elasticsearch9301/bin/elasticsearch -d"
查看es日志和端口,没有报错,启动成功即可。
四、安装kibana-7.5.0
1.官网下载kibana-7.5.0
cd /opt
wget https://artifacts.elastic.co/downloads/kibana/kibana-7.5.0-linux-x86_64.tar.gz
tar -zxf kibana-7.5.0-linux-x86_64.tar.gz
2.修改kibana配置文件
vim /opt/kibana-7.5.0-linux-x86_64/config/kibana.yml
server.host: "192.168.0.16"
3.启动kibana
添加kibana日志目录
mkdir /opt/kibana-7.5.0-linux-x86_64/logs
kibana也需要es用户启动
授权kibana目录给es
chown -R es:es kibana-7.5.0-linux-x86_64
启动:
su - es -c "nohup /opt/kibana-7.5.0-linux-x86_64/bin/kibana &>>/opt/kibana-7.5.0-linux-x86_64/logs/kibana.log &"
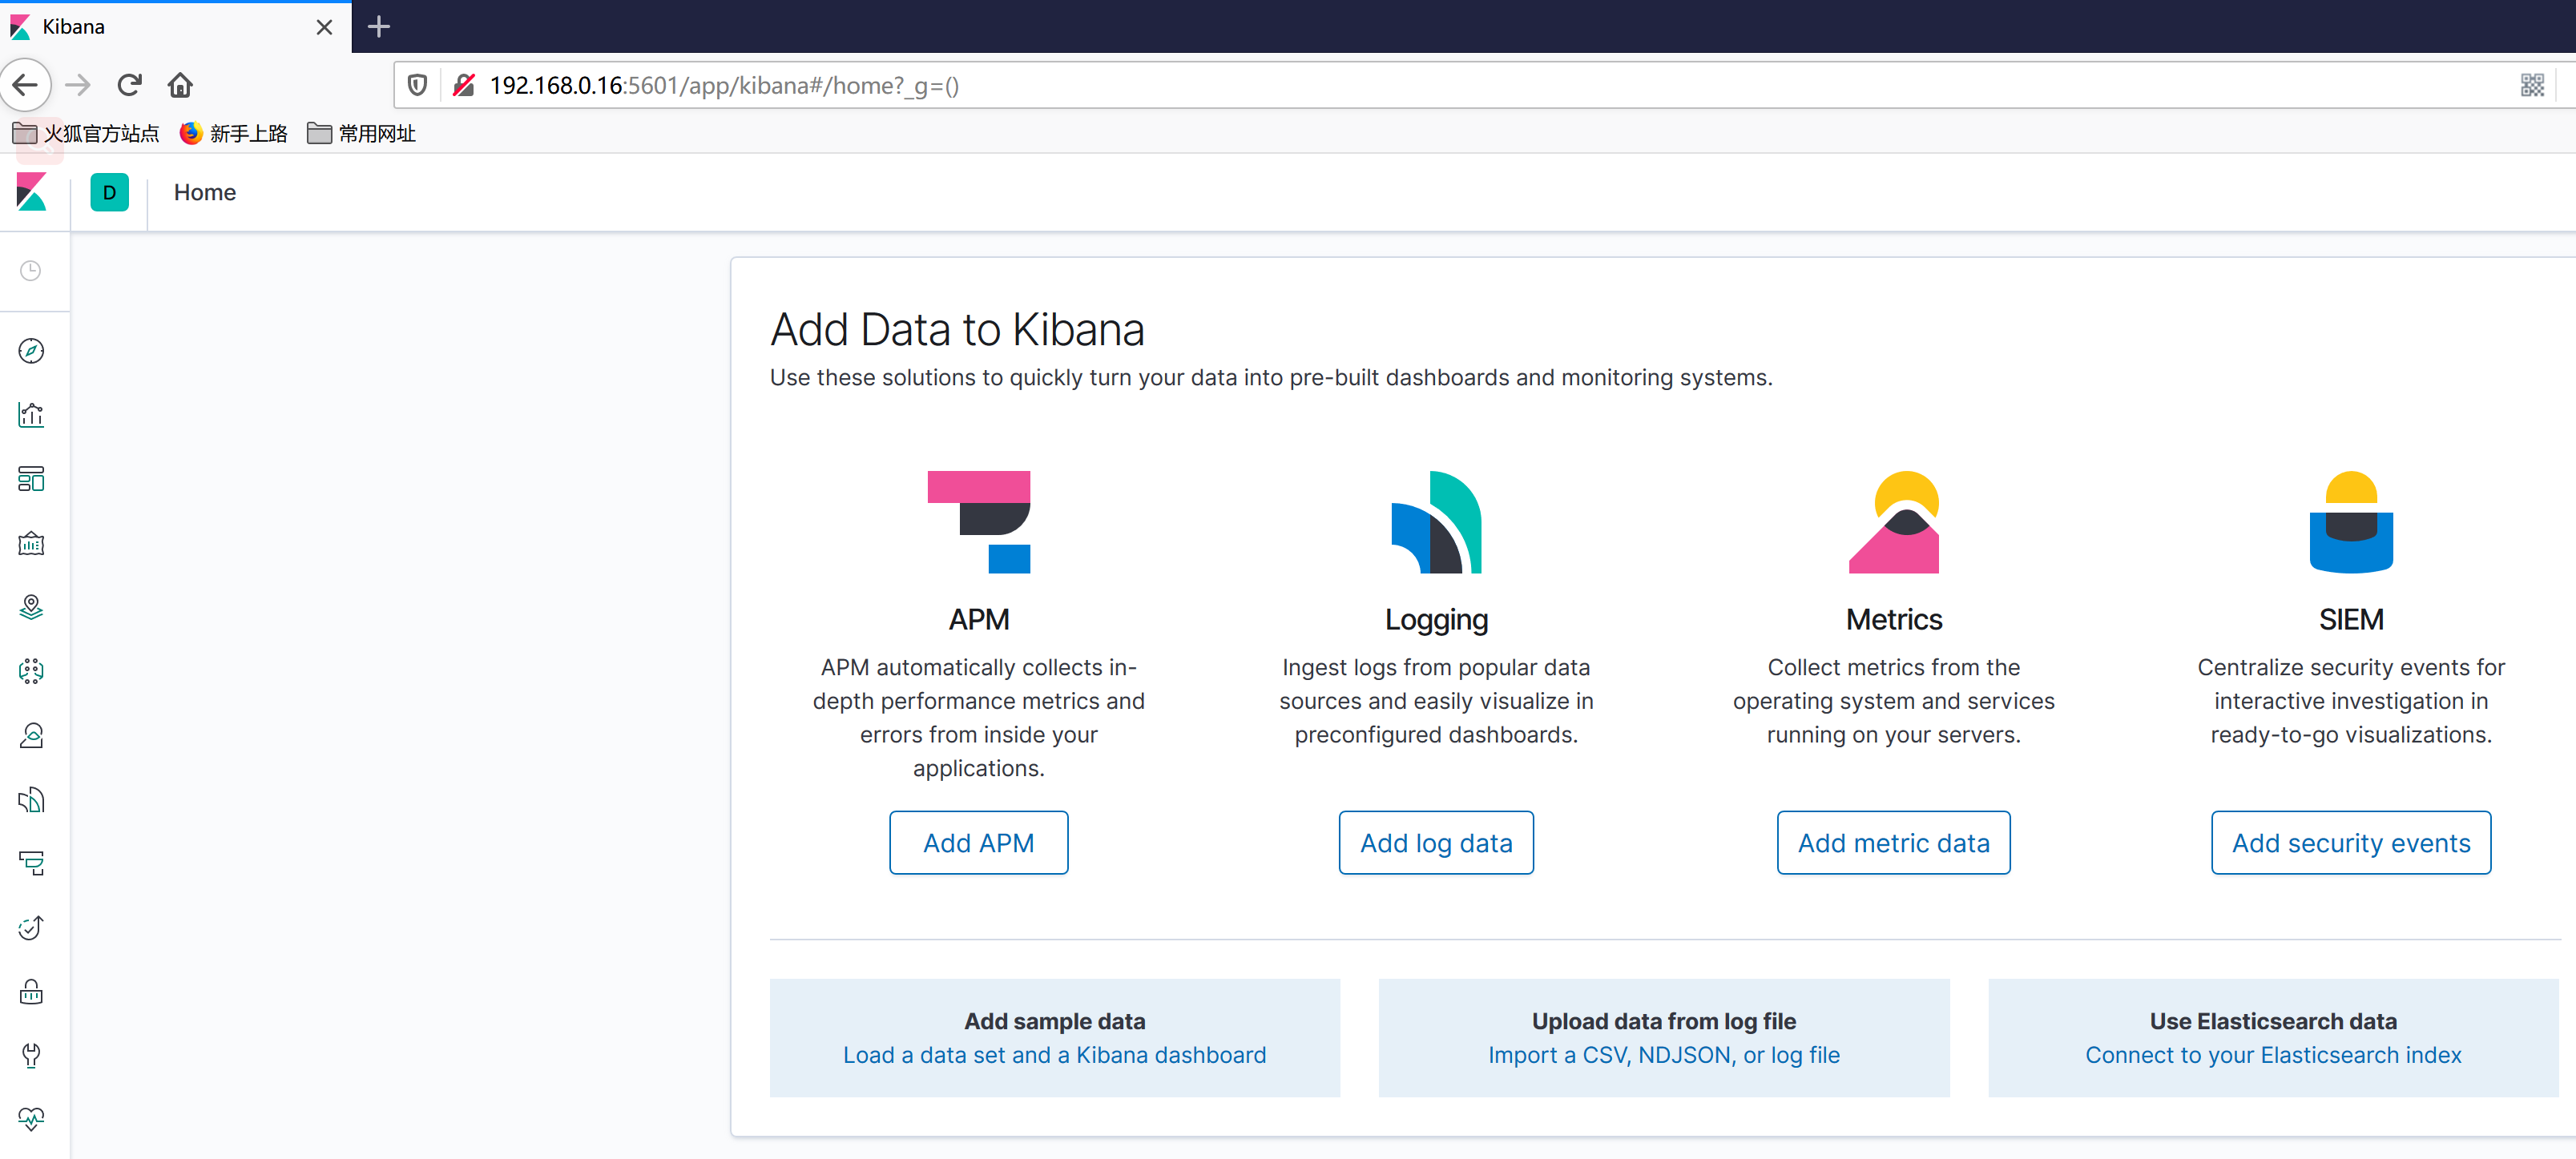
4.通过浏览器访问kibana
http://192.168.0.16:5601
五、安装es监控管理工具cerebro-0.8.5
1.下载cerebro-0.8.5release版
cd /opt
wget https://github.com/lmenezes/cerebro/releases/download/v0.8.5/cerebro-0.8.5.tgz
tar -zxf cerebro-0.8.5.tgz
2.修改cerebro配置
vim /opt/cerebro-0.8.5/conf/application.conf
hosts = [
{
host = "http://192.168.0.16:9200"
name = "en-es"
headers-whitelist = [ "x-proxy-user", "x-proxy-roles", "X-Forwarded-For" ]
}
3.启动cerebro
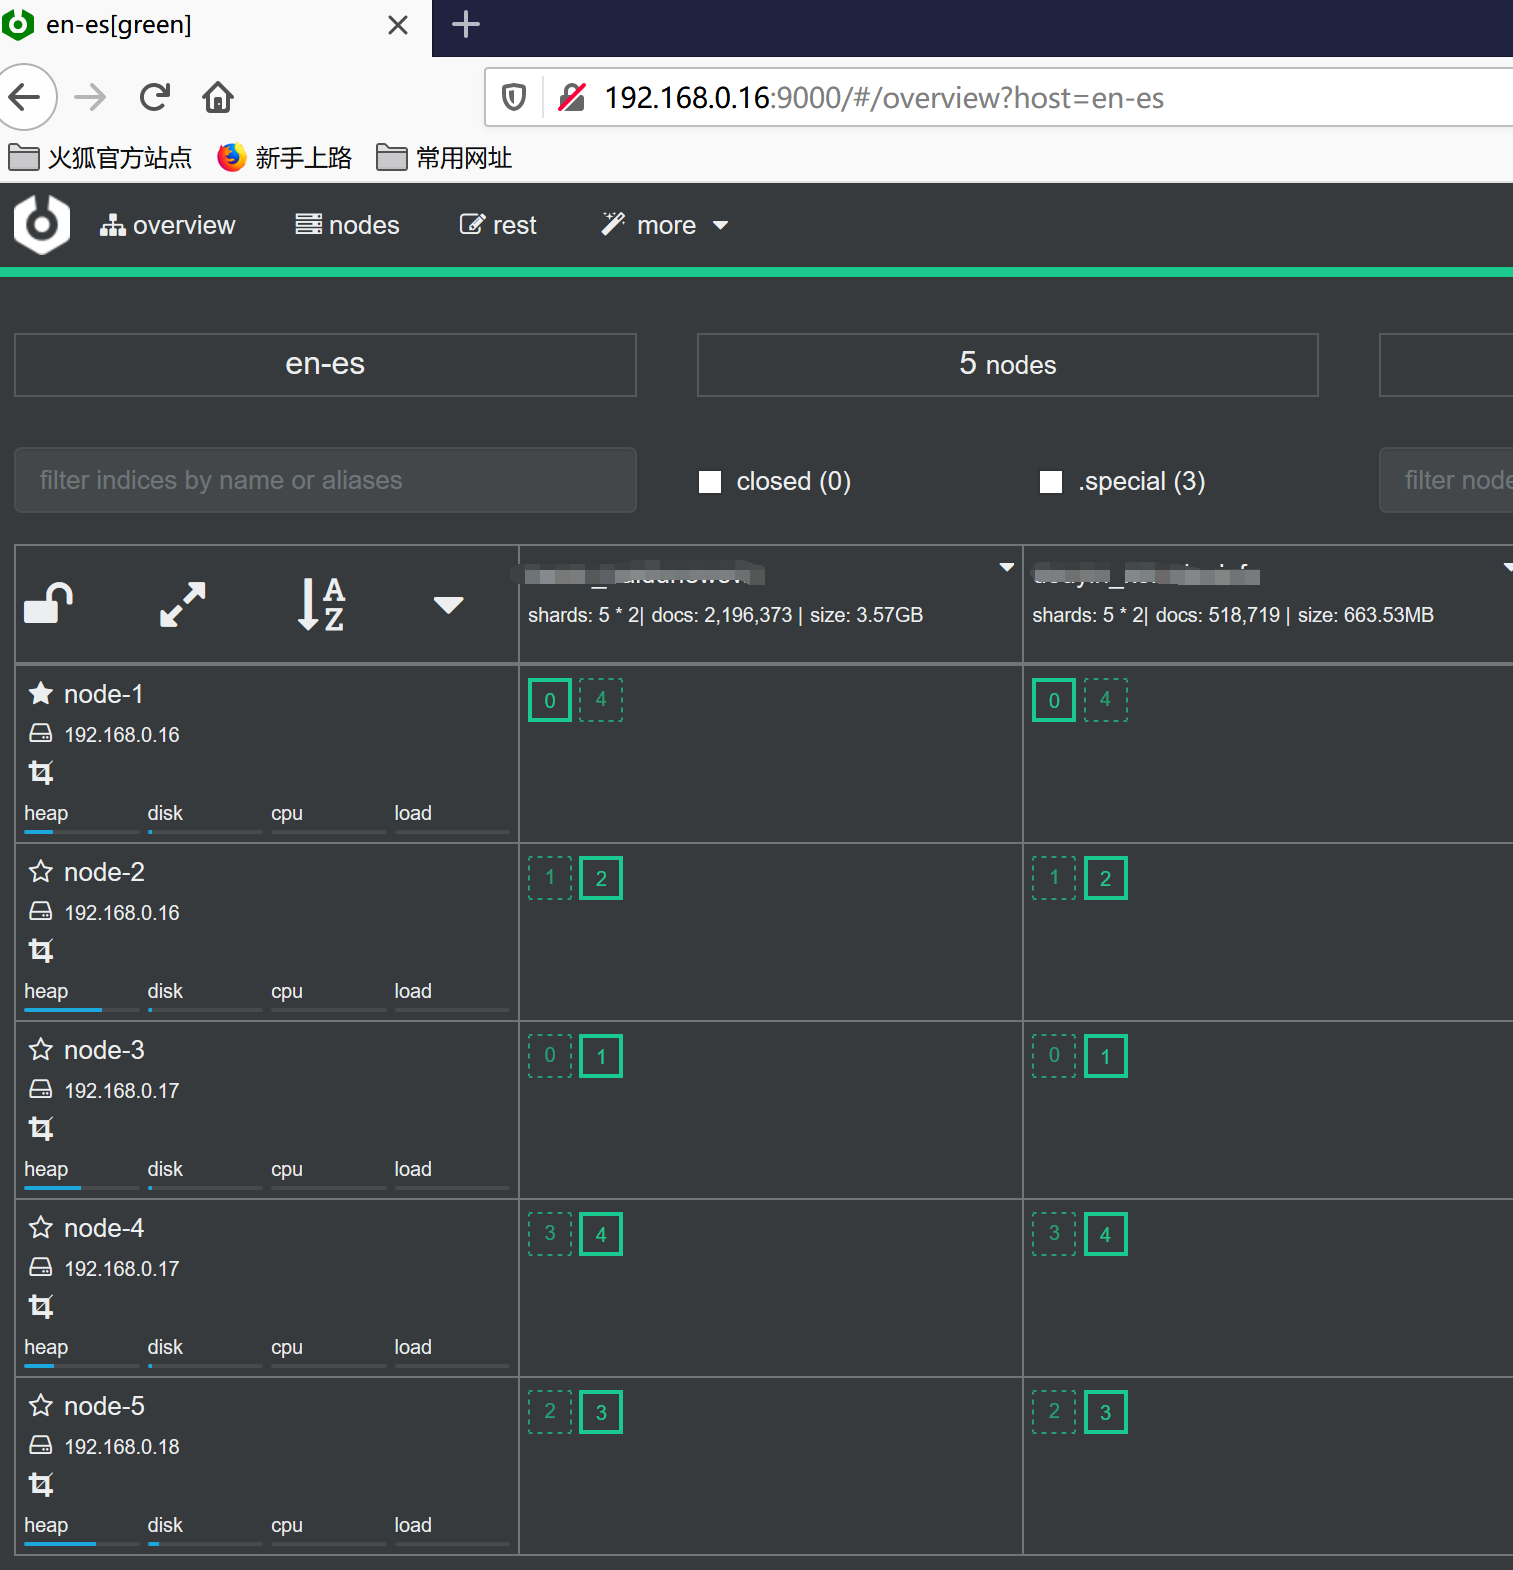
nohup /opt/cerebro-0.8.5/bin/cerebro -Dhttp.port=9000 -Dhttp.address=192.168.0.16 &>/dev/null &
4.通过浏览器访问
六、通过elasticsearch-migration将老集群数据迁移到新集群上
1.在16上安装elasticsearch-migration
cd /opt
wget https://github.com/medcl/esm-v1/releases/download/v0.4.3/linux64.tar.gz
tar -zxf linux64.tar.gz
mv linux64 elasticsearch-migration
2.停止老集群所有写入操作,开始迁移
/opt/elasticsearch-migration/esm -s http://192.168.0.66:9200 -d http://192.168.0.16:9200 -x indexname -w=5 -b=10 -c 10000 >/dev/null
3.等待迁移完成,一小时大约迁移7000w文档,40G左右,同时最多建议迁移两个索引

elasticsearch7.5.0+kibana-7.5.0+cerebro-0.8.5集群生产环境安装配置及通过elasticsearch-migration工具做新老集群数据迁移的更多相关文章
- vue-cli 3.0 axios 跨域请求代理配置及生产环境 baseUrl 配置
1. 开发环境跨域配置 在 vue.config.js 文件中: module.exports = { runtimeCompiler: true, publicPath: '/', // 设置打包文 ...
- Ubuntu15.10下Hadoop2.6.0伪分布式环境安装配置及Hadoop Streaming的体验
Ubuntu用的是Ubuntu15.10Beta2版本,正式的版本好像要到这个月的22号才发布.参考的资料主要是http://www.powerxing.com/install-hadoop-clus ...
- fedora gtk+ 2.0环境安装配置
1.安装gtk yum install gtk2 gtk2-devel gtk2-devel-docs 2.测试是否安装成功 pkg-config --cflags --libs gtk+-2.0 执 ...
- Android Studio 1.0 苹果电脑安装配置
前言 近日Google终于不负众望,发布了期待已久的Android Studio 1.0正式版.小编自己是Android开发者,之前使用过Eclipse,也试用过Android Studio 0. ...
- Nacos 发布 1.0.0 GA 版本,可大规模投入到生产环境
经过 3 个 RC 版本的社区体验之后,Nacos 正式发布 1.0.0 GA 版本,在架构.功能和 API 设计上进行了全方位的重构和升级. 1.0.0 版本的发布标志着 Nacos 已经可以大规模 ...
- aws ec2 安装Elastic search 7.2.0 kibana 并配置 hanlp 分词插件
文章大纲 Elastic search & kibana & 分词器 安装 版本控制 下载地址 Elastic search安装 kibana 安装 分词器配置 Elastic sea ...
- ELK(elasticsearch+logstash+kibana)入门到熟练-从0开始搭建日志分析系统教程
#此文篇幅较长,涵盖了elk从搭建到运行的知识,看此文档,你需要会点linux,还要看得懂点正则表达式,还有一个聪明的大脑,如果你没有漏掉步骤的话,还搭建不起来elk,你来打我. ELK使用elast ...
- Kibana,Logstash 和 Cerebro 的安装运行
公号:码农充电站pro 主页:https://codeshellme.github.io 1,安装 Kibana Kibana 用于数据可视化,我们可以进入到 Kibana 下载页面下载 Kibana ...
- linux 搭建elk6.8.0集群并破解安装x-pack
一.环境信息以及安装前准备 1.组件介绍 *Filebeat是一个日志文件托运工具,在你的服务器上安装客户端后,filebeat会监控日志目录或者指定的日志文件,追踪读取这些文件(追踪文件的变化,不停 ...
随机推荐
- 工作常用4种Java线程锁的特点,性能比较、使用场景
多线程的缘由 在出现了进程之后,操作系统的性能得到了大大的提升.虽然进程的出现解决了操作系统的并发问题,但是人们仍然不满足,人们逐渐对实时性有了要求. 使用多线程的理由之一是和进程相比,它是一种非常花 ...
- .NET Core 3.0 使用Nswag生成Api文档和客户端代码
摘要 在前后端分离.Restful API盛行的年代,完美的接口文档,成了交流的纽带.在项目中引入Swagger (也称为OpenAPI),是种不错的选择,它可以让接口数据可视化.下文将会演示 利用N ...
- 《面试官之你说我听》:简明的图解Redis RDB持久化、AOF持久化
欢迎关注文章这一系列,一起学习 <提升能力,涨薪可待篇> <面试知识,工作可待篇> <实战演练,拒绝996篇> 如果此文对你有帮助.喜欢的话,那就点个赞呗,点个关注 ...
- 和SharpDX坑爹的Variant刚正面
和SharpDX坑爹的Variant刚正面 几个月前我写了和篇文章<.NET中生成动态验证码>文章,其实里面藏着一个大坑.运行里面的代码,会发现运行的gif图片并没有循环播放: 细心的网友 ...
- 【Android - 组件】之Activity生命周期的全面分析
Activity是Android四大组件之首,其重要性不言而喻,Activity的生命周期更是我们了解Android工作机制的重中之重.我们一般将Activty的生命周期做两种情况下的理解,即正常情况 ...
- Spring 框架基础(06):Mvc架构模式简介,执行流程详解
本文源码:GitHub·点这里 || GitEE·点这里 一.SpringMvc框架简介 1.Mvc设计理念 MVC是一种软件设计典范,用一种业务逻辑.数据.界面显示分离的方法组织代码,将业务逻辑聚集 ...
- python模块IO
Python之模块IO io概叙 io模块提供了python用于处理各种类型I/O的主要工具,主要有三种类型的I/O:文本I/O,二进制I/O和原始I/O:这些都是通用类型,各种后备存储可使用其中的每 ...
- 对于web前端的理解
对于web前端的理解 其实写这篇文章的首要目的是为了准备一道面试题——你对前端的看法是什么?本文不会仅从技术角度去考虑这个问题,还会依据这个社会的变革去讨论这个问题.本文仅代表个人观点,不喜勿喷. W ...
- PyCharm 2019.3激活破解教程(永久)
2019.12.02 jetbrains公司发布了Python的最强编辑器PyCharm 2019.3版本.本次大版本主要对Jupyter notebooks .MongoDB.Python3.8功能 ...
- Python 中如何实现参数化测试?
Python 中如何实现参数化测试? 之前,我曾转过一个单元测试框架系列的文章,里面介绍了 unittest.nose/nose2 与 pytest 这三个最受人欢迎的 Python 测试框架. 本文 ...