
爬虫---PyQuert简介
今天写一篇最近刚学习的一个第3方库pyquery,pyquery比bs4,lxml更强大的一个网页解析工具。
什么是pyQuery
Pyquery是python的第3方库,PyQuery库也是一个非常强大又灵活的网页解析库,它提供了和jQuery 类似的语法来解析HTML 文梢,支持css 选择器,使用非常方便。Beautifu l Soup 一样,初始化PyQuery 的时候,也需要传入HTML 文本来初始化一个PyQue1y对象。它的初始化方式有多种,比如直接传入字符串,传入URL,传人文件名
官方文档:http://pyquery.readthedocs.io/en/latest/
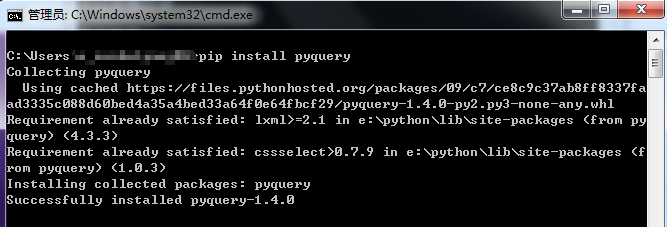
安装PyQuery
# pip安装

pip install pyquery
PyQuery使用
写一个简单的html供下面学习
text =
'''

<html>

<body>

<div id="test">

<ul class="list">

<li class="item-0"><a href="link1.html">今天天气</a></li>

<li class="item-1"><a href="link2.html">明天天气</a></li>

<li class="item-2"><a href="link3.html">后天天气</a></li>

<li class="item-3"><a href="link4.html">周末天气</a></li>

</ul>

</div>

</body>

</html>

'''
基本css选择器
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

# 通过css选择器先查找id再查找class

item = doc('#test .list')

print(item)

代码结果:

<ul class="list">

<li class="item-0"><a href="link1.html">今天天气</a></li>

<li class="item-1"><a href="link2.html">明天天气</a></li>

<li class="item-2"><a href="link3.html">后天天气</a></li>

<li class="item-3"><a href="link4.html">周末天气</a></li>

</ul>
查找子节点
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

# 通过css选择器先查找id再查找class

item = doc('#test .list')

# 查找子节点li
child = item.children('li')
# 或者使用find()函数
# child = item.find('li')
print(child)

代码结果:

<li class="item-0"><a href="link1.html">今天天气</a></li>

<li class="item-1"><a href="link2.html">明天天气</a></li>

<li class="item-2"><a href="link3.html">后天天气</a></li>

<li class="item-3"><a href="link4.html">周末天气</a></li>
查找父节点
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

# 通过css选择器先查找id再查找class

item = doc('#test .list')

# 查找父节点

container = item.parent()

print(container)

代码结果:

<div id="test">

<ul class="list">

<li class="item-0"><a href="link1.html">今天天气</a></li>

<li class="item-1"><a href="link2.html">明天天气</a></li>

<li class="item-2"><a href="link3.html">后天天气</a></li>

<li class="item-3"><a href="link4.html">周末天气</a></li>

</ul>

</div>
查找兄弟节点
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

# 查找兄弟其中一个

item = doc('.item-0')

# 查找兄弟节点

xiongdi = item.siblings('li')

print(xiongdi)

代码结果:

<li class="item-1"><a href="link2.html">明天天气</a></li>

<li class="item-2"><a href="link3.html">后天天气</a></li>

<li class="item-3"><a href="link4.html">周末天气</a></li>
遍历读取内容
1、遍历读取a标签
这个地方需要使用一个方法items(),使用该方法后得到一个生成器
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

item = doc('.list a').items()

for i in item:

    print(i)

代码结果:

<a href="link1.html">今天天气</a>

<a href="link2.html">明天天气</a>

<a href="link3.html">后天天气</a>

<a href="link4.html">周末天气</a>
2、获取href的值
这个地方需要用到attr()方法
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

item = doc('.list a').items()

for i in item:

    print(i.attr('href'))

代码结果:

link1.html

link2.html

link3.html

link4.html
3、获取a标签下的文字
通过调用text()方法来实现
# 导入pyquery

from pyquery import PyQuery as pq

# 创建对象

doc = pq(text)

item = doc('.list a').items()

for i in item:

    print(i.text())

代码结果:

今天天气

明天天气

后天天气

周末天气
下一篇通过简单的案例更加深刻的了解pyquery库~~~~
写了一些简单的介绍,还是那一句话,方法多多种,喜欢那种用那种~~~大家喜欢的话,也可以点个关注哈
爬虫---PyQuert简介的更多相关文章
- Python 爬虫一 简介
什么是爬虫? 爬虫可以做什么? 爬虫的本质 爬虫的基本流程 什么是request&response 爬取到数据该怎么办 什么是爬虫? 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间 ...
- 【搜索引擎Jediael开发笔记1】搜索引擎初步介绍及网络爬虫
详细可参考 (1)书箱:<这就是搜索引擎><自己动手写网络爬虫><解密搜索引擎打桩实践> (2)[搜索引擎基础知识1]搜索引擎的技术架构 (3)[搜索引擎基础知识2 ...
- 97、爬虫框架scrapy
本篇导航: 介绍与安装 命令行工具 项目结构以及爬虫应用简介 Spiders 其它介绍 爬取亚马逊商品信息 一.介绍与安装 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, ...
- 爬虫框架 Scrapy
一 介绍 crapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前Scrapy的用途十分广泛,可用 ...
- Python 爬虫七 Scrapy
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- 爬虫框架之Scrapy
一.介绍 二.安装 三.命令行工具 四.项目结构以及爬虫应用简介 五.Spiders 六.Selectors 七.Items 八.Item Pipelin 九. Dowloader Middeware ...
- 爬虫基础线程进程学习-Scrapy
性能相关 学习参考:http://www.cnblogs.com/wupeiqi/articles/6229292.html 在编写爬虫时,性能的消耗主要在IO请求中,当单进程单线程模式下请求URL时 ...
- 爬虫、框架scrapy
阅读目录 一 介绍 二 安装 三 命令行工具 四 项目结构以及爬虫应用简介 五 Spiders 六 Selectors 七 Items 八 Item Pipeline 九 Dowloader Midd ...
- 爬虫之Scrapy详解
性能相关 在编写爬虫时,性能的消耗主要在IO请求中,当单进程单线程模式下请求URL时必然会引起等待,从而使得请求整体变慢. import requests def fetch_async(url): ...
随机推荐
- 微信小程序中换行,空格(多个空格)写法
在小程序中HTML的网页实体无法正常使用,小程序中的写法为: 一.空格,换行 <text>你好!\t七月流火啊!\n我在下一行</text> \t 空格( 多个只会显示一个空格 ...
- 微信小程序开发者工具构建npm提示没找到node_modules目录
一.官网给的文档写的不够充分,需要你充分理解npm的使用方法,才能明白的: 二.第一步:先在你电脑上安装npm 参考下面文章 https://www.cnblogs.com/zmdComeOn/p/1 ...
- gcc栈溢出保护机制:stack-protector
关键词:stack-protector.stack-protector-strong.stack-protector-all等等. 1. gcc栈保护机制stack-protector简介 gcc提供 ...
- X短期项目总结
刚退出了一个项目,简称为X项目.这个项目中,还是遇到了不少问题,也解决了部分问题,还是挺有收获的,所以总结一下. 虽然标题说是短期项目总结,但其实这个项目并不短, 持续了约3年时间. 所谓的短,只是我 ...
- linux,xshell命令
一. linux 1.Linux发行版 <1> 常见的发行版本如下: Ubuntu Redhat Fedora openSUSE Linux Mint Debian Manjaro M ...
- mysql和oracle分页
mysql分页 关键字limit,limit m,n 其中m表示起始位置的下标,下标从0开始.n表示要显示的条数,比如要查询一个表的第2到5条数据. ,; oracle分页 关键字rownum, ro ...
- 参数检查(@property)
绑定属性时,如果直接把属性暴露出去,虽然写起来很简单,但无法对参数进行检查,导致属性被随便修改 因此,可以通过在类内定义get()获取属性值,定义set()对属性值进行设定并对设定值进行检查 但通过定 ...
- ES5提取公共变量
在ES5中,请求地址前缀等需要作为公共变量提出. 则需在common.js写上 Object.defineProperty(window,'base',{ value:"http://xx. ...
- Java Arrays类方法
1:概述 主要谈一谈 Java使用fork/koin类 实现的并发排序 以及对于Stream流的支持的splitetor mismatch() -> 寻找两个数组 第一次出现数据不一致的下 ...
- spring的事件机制实战
理论 在分布式场景下,实现同步转异步的方式有三种方式: 1.异步线程池执行:比如借助@Asyn注解,放到spring自带的线程池中去执行: 2.放到消息队列中,在消费者的代码中异步的消费,执行相关的逻 ...