
算法与数据结构基础 - 字典树(Trie)
Trie基础
Trie字典树又叫前缀树(prefix tree),用以较快速地进行单词或前缀查询,Trie节点结构如下:
//208. Implement Trie (Prefix Tree)
class TrieNode{

public:

    TrieNode* children[]; //或用链表、map表示子节点

    bool isWord; //标识该节点是否为单词结尾

    TrieNode(){

        memset(children,,sizeof(children));

        isWord=false;

    }

};
插入单词的方法如下:
    void insert(string word) {

        TrieNode* p=root;

        for(auto w:word){

            if(p->children[w-'a']==NULL) p->children[w-'a']=new TrieNode;

            p=p->children[w-'a'];

        }

        p->isWord=true;

    }
假如有单词序列 ["a", "to", "tea", "ted", "ten", "i", "in", "inn"],则完成插入后有如下结构:
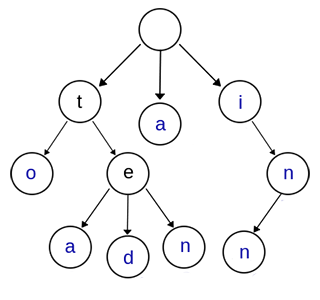
Trie的root节点不包含字符,以上蓝色节点表示isWord标记为true。在建好的Trie结构里查找单词或单词前缀的方法如下:
    /** Returns if the word is in the trie. */

    bool search(string word) {

        TrieNode* p=root;

        for(auto w:word){

            if(p->children[w-'a']==NULL) return false;

            p=p->children[w-'a'];

        }

        return p->isWord;

    }

    /** Returns if there is any word in the trie that starts with the given prefix. */

    bool startsWith(string prefix) {

        TrieNode* p=root;

        for(auto w:prefix){

            if(p->children[w-'a']==NULL) return false;

            p=p->children[w-'a'];

        }

        return true;

    }
相关LeetCode题:
208. Implement Trie (Prefix Tree) 题解
Trie与Hash table比较
同样用于快速查找,经常会拿Hash table和Trie相互比较。从以上Trie的构建和查找代码可知,构建Trie的时间复杂度和文本长度线性相关、查找时间复杂度和单词长度线性相关;对Trie空间复杂度来说,如果数据按前缀聚拢,那么有利于减少Trie的存储空间。
对Hash table而言,虽然查找过程是O(1),但另需考虑hash函数本身的时间消耗;另对于字符串prefix查找问题,并不能直接用Hash table解决,要么做一些提前功夫,将各个prefix也提前存入Hash table。
相关LeetCode题:
648. Replace Words Trie题解 HashTable题解
Trie的应用
Trie除了可以用于字符串检索、前缀匹配外,还可以用于词频统计、字符串排序、搜索自动补全等场景。
相关LeetCode题:
642. Design Search Autocomplete System 题解
算法与数据结构基础 - 字典树(Trie)的更多相关文章
- 字典树(Trie)详解
详解字典树(Trie) 本篇随笔简单讲解一下信息学奥林匹克竞赛中的较为常用的数据结构--字典树.字典树也叫Trie树.前缀树.顾名思义,它是一种针对字符串进行维护的数据结构.并且,它的用途超级广泛.建 ...
- 『字典树 trie』
字典树 (trie) 字典树,又名\(trie\)树,是一种用于实现字符串快速检索的树形数据结构.核心思想为利用若干字符串的公共前缀来节约储存空间以及实现快速检索. \(trie\)树可以在\(O(( ...
- [POJ] #1002# 487-3279 : 桶排序/字典树(Trie树)/快速排序
一. 题目 487-3279 Time Limit: 2000MS Memory Limit: 65536K Total Submissions: 274040 Accepted: 48891 ...
- 算法与数据结构基础 - 广度优先搜索(BFS)
BFS基础 广度优先搜索(Breadth First Search)用于按离始节点距离.由近到远渐次访问图的节点,可视化BFS 通常使用队列(queue)结构模拟BFS过程,关于queue见:算法与数 ...
- 算法与数据结构基础 - 二叉树(Binary Tree)
二叉树基础 满足这样性质的树称为二叉树:空树或节点最多有两个子树,称为左子树.右子树, 左右子树节点同样最多有两个子树. 二叉树是递归定义的,因而常用递归/DFS的思想处理二叉树相关问题,例如Leet ...
- 算法与数据结构基础 - 图(Graph)
图基础 图(Graph)应用广泛,程序中可用邻接表和邻接矩阵表示图.依据不同维度,图可以分为有向图/无向图.有权图/无权图.连通图/非连通图.循环图/非循环图,有向图中的顶点具有入度/出度的概念. 面 ...
- 算法与数据结构基础 - 深度优先搜索(DFS)
DFS基础 深度优先搜索(Depth First Search)是一种搜索思路,相比广度优先搜索(BFS),DFS对每一个分枝路径深入到不能再深入为止,其应用于树/图的遍历.嵌套关系处理.回溯等,可以 ...
- 字典树trie学习
字典树trie的思想就是利用节点来记录单词,这样重复的单词可以很快速统计,单词也可以快速的索引.缺点是内存消耗大 http://blog.csdn.net/chenleixing/article/de ...
- 算法与数据结构基础 - 堆(Heap)和优先级队列(Priority queue)
堆基础 堆(Heap)是具有这样性质的数据结构:1/完全二叉树 2/所有节点的值大于等于(或小于等于)子节点的值: 图片来源:这里 堆可以用数组存储,插入.删除会触发节点shift_down.shif ...
随机推荐
- POJ 2728:Desert King(最优比率生成树)
http://poj.org/problem?id=2728 题意:有n个点,有三个属性代表每个点在平面上的位置,和它的高度.点与点之间有一个花费:两点的高度差:还有一个长度:两点的距离.现在要让你在 ...
- 28nm工艺下,自动生成管脚排列文件,给设计加PAD,并在PAD上面打Label的流程(含Tcl脚本)
本文转自:自己的微信公众号<数字集成电路设计及EDA教程> 里面主要讲解数字IC前端.后端.DFT.低功耗设计以及验证等相关知识,并且讲解了其中用到的各种EDA工具的教程. 考虑到微信公众 ...
- pdfminer获取整页文本
#! python2 # coding: utf-8 import sys from cStringIO import StringIO from pdfminer import pdfinterp ...
- Java设计模式学习笔记(三) 工厂方法模式
前言 本篇是设计模式学习笔记的其中一篇文章,如对其他模式有兴趣,可从该地址查找设计模式学习笔记汇总地址 1. 简介 上一篇博客介绍了简单工厂模式,简单工厂模式存在一个很严重的问题: 就是当系统需要引入 ...
- GitHub使用整理——关于上传Keil工程一些注意的点
git上传警告warning: LF will be replaced by CRLF 在上传keil工程时,会遇到warning: LF will be replaced by CRLF警告: wa ...
- Java编程思想:File类list()方法
import java.util.regex.Pattern; import java.io.File; import java.io.FilenameFilter; public class Tes ...
- Java编程思想:构建复杂模型
import sun.nio.cs.Surrogate; import java.util.ArrayList; import java.util.Random; public class Test ...
- 【题解】P2916 [USACO08NOV]安慰奶牛Cheering up the Cow-C++
原题传送门 这道题用最小生成树来完成,我选用的是kruskal(克鲁斯卡尔)来完成.这道题目在克鲁斯卡尔模板的基础上,有变动的地方只有2处:1.因为必须从一个点出发,而最小生成树最后会让所有点都连通, ...
- NOIP2018普及T2暨洛谷P5016 龙虎斗
题目链接:https://www.luogu.org/problemnew/show/P5016 分析: 这是一道模拟题.看到题目,我们首先要把它细致的读明白,模拟题特别考察细节,往往会有想不到的坑点 ...
- 开源一个好用的nodejs访问mysql类库
一.背景问题 自nodejs诞生以来出现了一大批的web框架如express koa2 egg等等,前端可以不再依赖后端可以自己控制服务端的逻辑.原来的后端开发同学的阵地前端如今同样也写的风生水起,撸 ...