
Adaboost原理推导
Adaptive Boosting是一种迭代算法。每轮迭代中会在训练集上产生一个新的学习器,然后使用该学习器对所有样本进行预测,以评估每个样本的重要性(Informative)。换句话来讲就是,算法会为每个样本赋予一个权重,每次用训练好的学习器标注/预测各个样本,如果某个样本点被预测的越正确,则将其权重降低;否则提高样本的权重。权重越高的样本在下一个迭代训练中所占的比重就越大,也就是说越难区分的样本在训练过程中会变得越重要;
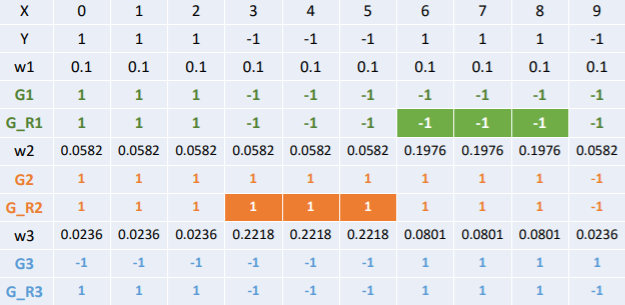
先记住这个图:


整个迭代过程直到错误率足够小或者达到一定的迭代次数为止。
分类
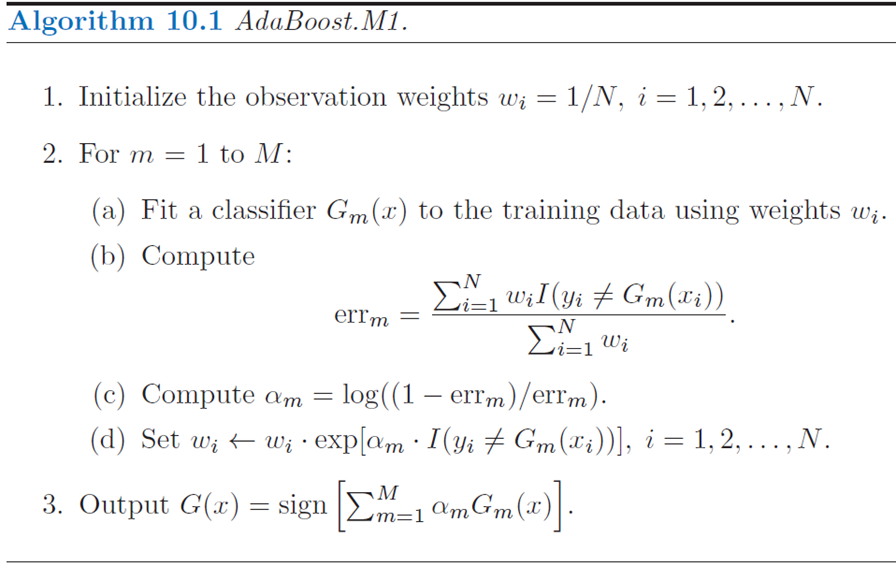
首先看一下原来的论文上的伪代码:
Adaboost算法将基分类器的线性组合作为强分类器,同时给分类误差率较小的基本分类器以大的权重值,给分类误差率较大的基分类器以小的权重值;构建的线性组合为:
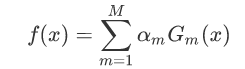
最终分类器是在线性组合的基础上进行Sign函数转换:
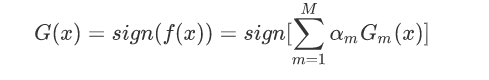
因为G(x)是经过sign化的所以得出的值是-1或1,这时候损失函数自然就是那些被分类错误的样本平均个数了:
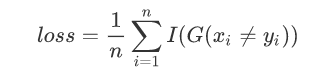
对于这样一个损失函数难以进行求导,所以这里使用下面这个函数代替:
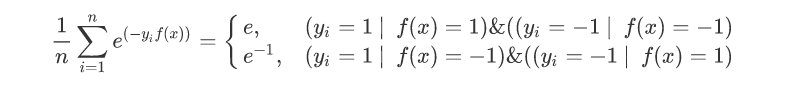
In [1]: import numpy as np
In [2]: np.exp(1)Out[2]: 2.718281828459045
In [3]: 1/np.exp(1)Out[3]: 0.36787944117144233
所以损失函数可以改变为:
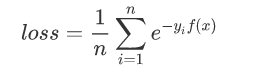
根据刚开始的图示我们可以得出:
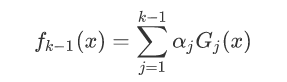
由于这里每个模型都是上一个模型得来的:
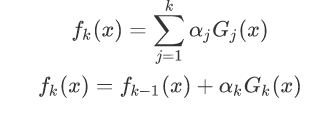
将fk(x)带入到损失函数中:
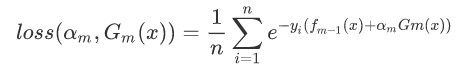
剩下的就是走机器学习的老套路求导求值,这时候就先构造参数:
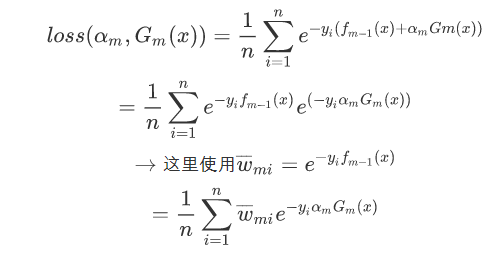
使下列公式达到最小值的αm和Gm就是AdaBoost算法的最终求解值。
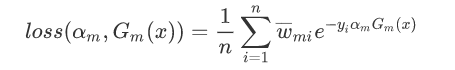
G这个分类器在训练的过程中,是为了让误差率最小,所以可以认为G越小其实就是误差率越小。
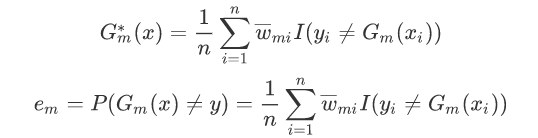
对于αm而言,通过求导然后令导数为零,可以得到公式(log对象可以以e为底也可以以2为底):
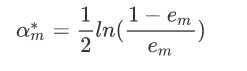
举个栗子
| 序号 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| x | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
| y | 1 | 1 | 1 | -1 | -1 | -1 | 1 | 1 | 1 | -1 |
x是特征,y是标签,令权值分布
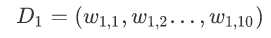
在这里:
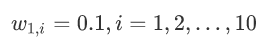
在权值分布为D1的训练数据中,当阀值为2.5的时候,误差率最低,所以这时候的基本分类器为:
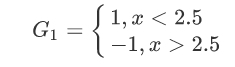
G1(x)在训练数据集上的误差率:

计算模型G1的系数:

更新数据集的权值分布:
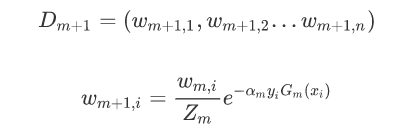
注意这里的Zm是为了归一化:

更新后的结果:
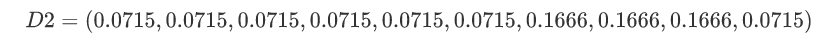
D2中分类正确的样本权值减小,错误分类的样本权值提高。
然后利用D2在训练样本中寻找误差率最低的基本分类器,在继续进行迭代。
......(这里再循环两次)
得到:

所以将新的函数f(x),放入sign()分类器中,从而输出结果:
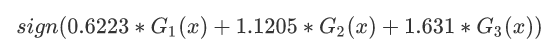
分类器sign(f3(x))在训练数据集上有0个误分类点;结束循环。

而在实际应用中我们还会添加一个缩减系数:
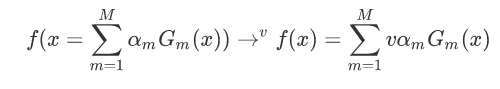
优点:
可以处理连续值和离散值;模型的鲁棒性比较强;解释强,结构简单。
缺点:
对异常样本敏感,异常样本可能会在迭代过程中获得较高的权重值,最终影响模型效果
实现代码:
import pandas as pd
import numpy as np
import math
df = pd.DataFrame([[0,1],[1,1],[2,1],[3,-1],[4,-1],
[5,-1],[6,1],[7,1],[8,1],[9,-1]])
w =np.ones(df.shape[0])/df.shape[0] #初始化权值分布
from sklearn.tree import DecisionTreeClassifier
X = df.iloc[:,[0]]
Y = df.iloc[:,[-1]]
model = DecisionTreeClassifier(max_depth=1).fit(X,Y,sample_weight=w) ##训练第1个模型
model1 = model
# print(w)
# print(w * model.predict(X))
# print(Y.values.T[0])
# print(model.predict(X) != Y.values.T[0])
e = sum(w*(model.predict(X) != Y.values.T[0])) #误差率
# print(e) #0.30000000000000004
a = 1/2*math.log((1-e)/e) #学习器系数
# print(a)
a1 = a
z = sum(w*np.exp(-1*a*Y.values.T[0]*model.predict(X))) #规范因子
w = w/z*np.exp(-1*a*Y.values.T[0]*model.predict(X))#更新权值分布
model = DecisionTreeClassifier(max_depth=1).fit(X,Y,sample_weight=w)##训练第2个模型
model2 = model
e = sum(w*(model.predict(X) != Y.values.T[0]))
a = 1/2*math.log((1-e)/e)
a2 = a
z = sum(w*np.exp(-1*a*Y.values.T[0]*model.predict(X)))
w = w/z*np.exp(-1*a*Y.values.T[0]*model.predict(X))
model = DecisionTreeClassifier(max_depth=1).fit(X,Y,sample_weight=w)##训练第3个模型
model3 = model
e = sum(w*(model.predict(X) != Y.values.T[0]))
a = 1/2*math.log((1-e)/e)
a3 = a
y_ = np.sign(a1*model1.predict(X)+a2*model2.predict(X)+a3*model3.predict(X))##模型组合
print(y_)
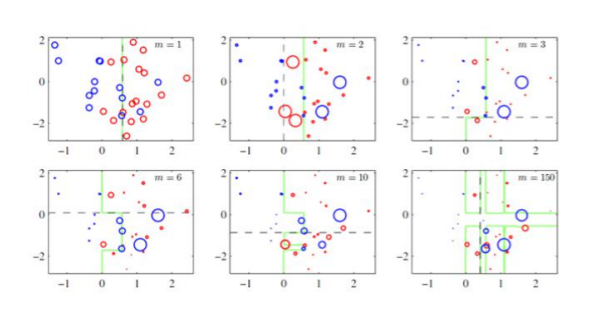
最后实在不懂boosting是怎么回事的,就看一下下面的图:
Adaboost原理推导的更多相关文章
- 集成学习之Boosting —— AdaBoost原理
集成学习大致可分为两大类:Bagging和Boosting.Bagging一般使用强学习器,其个体学习器之间不存在强依赖关系,容易并行.Boosting则使用弱分类器,其个体学习器之间存在强依赖关系, ...
- AdaBoost原理详解
写一点自己理解的AdaBoost,然后再贴上面试过程中被问到的相关问题.按照以下目录展开. 当然,也可以去我的博客上看 Boosting提升算法 AdaBoost 原理理解 实例 算法流程 公式推导 ...
- Adaboost原理及目标检测中的应用
Adaboost原理及目标检测中的应用 whowhoha@outlook.com Adaboost原理 Adaboost(AdaptiveBoosting)是一种迭代算法,通过对训练集不断训练弱分类器 ...
- 机器学习之AdaBoost原理与代码实现
AdaBoost原理与代码实现 本文系作者原创,转载请注明出处: https://www.cnblogs.com/further-further-further/p/9642899.html 基本思路 ...
- 机器学习-分类器-Adaboost原理
Adaboost原理 Adaboost(AdaptiveBoosting)是一种迭代算法,通过对训练集不断训练弱分类器,然后把这些弱分类器集合起来,构成强分类器.adaboost算法训练的过程中,初始 ...
- 降维算法----PCA原理推导
1.从几何的角度去理解PCA降维 以平面坐标系为例,点的坐标是怎么来的? 图1 ...
- PCA主成分分析算法的数学原理推导
PCA(Principal Component Analysis)主成分分析法的数学原理推导1.主成分分析法PCA的特点与作用如下:(1)是一种非监督学习的机器学习算法(2)主要用于数据的降维(3)通 ...
- Adaboost原理及相关推导
提升思想 一个概念如果存在一个多项式的学习算法能够学习它,并且正确率很高,那么,这个概率是强可学习的.一个概念如果存在一个多项式的学习算法能够学习它,并且学习的正确率仅比随机猜测略好,那么,这个概念是 ...
- AdaBoost原理,算法实现
前言: 当做重要决定时,大家可能综合考虑多个专家而不是一个人的意见.机器学习处理问题也是如此,这就是元算法背后的思路.元算法是对其他算法进行组合的一种方式,前几天看了一个称作adaboost方法的介绍 ...
随机推荐
- fprintf函数将格式打印到文件,非常好用(怎么没早点发现这个函数)
/* fprintf example */ #include <stdio.h> int main () { FILE * pFile; int n; ]; pFile = fopen ( ...
- 常用json解析库比较及选择 fastjson & gson
一.常用json解析库比较及选择 1.简介 fastjson和gson是目前比较常用的json解析库,并且现在我们项目代码中,也在使用这两个解析库. fastjson 是由阿里开发的,号称是处理jso ...
- WPF使用AForge实现Webcam预览(一)
本文简略地介绍一下如果使用AForge来实现前置/后置摄像头的预览功能. 要使用AForge,就需要添加AForge NuGet相关包的引用,这些包依赖的其他包会自动安装. AForge.Contro ...
- 让VC2012生成的程序支持XP系统(修改mkspecs\win32-msvc2012\qmake.conf,QT的DLL都是支持XP的,只与EXE有关)good
如果用的编译器是VC2012以上,那么默认生成出的程序是不能运行在XP系统上的.所以需要修改链接参数 我们要做的是修改qmake.conf文件中的参数,文件路径根据开发环境不同而不同下面以5.1.1 ...
- Building PySide on Microsoft Windows
Prerequisites MS Visual Studio Express 2008 [microsoft.com] NOTE: Visual Studio Express 2010 is not ...
- Qt+QZXing编写识别二维码的程序
本人最近在用Qt编写程序,需要用编写二维码识别功能.在网上搜寻一番,找到了QZXing.配置过程中确实出了一大把汗,这里我写这篇文章记录配置方法,替后人省一把汗吧!我的开发环境:MSVC2010 + ...
- 为什么API多用C而不是C++,为什么C++程序大多不使用异常
读Defective C++随笔 不尽知用兵之害者,则不能尽知用兵之利也 ——<孙子兵法> 1.为什么API多用C而不是C++以前就一直很奇怪,为什么API大都用C的方式提供,即使有C++ ...
- 学习Java,值得你留意的问题(1)更名为《学习Java,容易被你忽略的小细节(1)》
记得大二快要结束的时候,有个女孩子突然问我“你会Java吗,帮我做大作业好吗?” 实话说,那个女孩真的很漂亮,我当时也非常想帮她.但是我从来没有接触过Java,让我在短短的几天内完成Java程序设计课 ...
- 条款10:令operator= 返回一个reference to *this
关于赋值,可以写成连锁形式: int x, y, z; x = y = z = 15; //赋值连锁形式 赋值采用右结合律,故上述赋值被解析为: x = (y = (z = 15)); 为了实现连锁赋 ...
- Spring中如何获取request的方法汇总及其线程安全性分析
前言 本文将介绍在Spring MVC开发的web系统中,获取request对象的几种方法,并讨论其线程安全性.下面话不多说了,来一起看看详细的介绍吧. 概述 在使用Spring MVC开发Web系统 ...