
Spark Streaming实时计算
spark批处理模式:
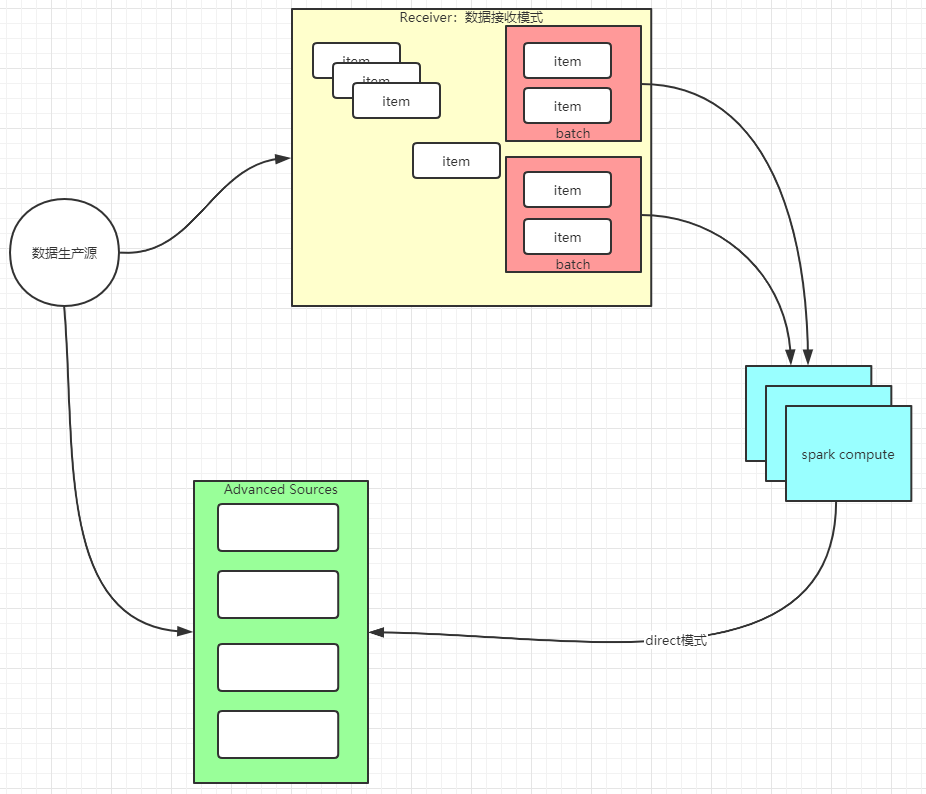
receiver模式:接收数据流,负责数据的存储维护,缺点:数据维护复杂(可靠性,数据积压等),占用计算资源(core,memory被挤占)
direct模式:数据源由三方组件完成,spark只负责数据拉取计算,充分利用资源计算
window计算:
  def windowApi(): Unit = {

    val conf: SparkConf = new SparkConf().setAppName("sparkstream").setMaster("local[2]")

    val sc = new SparkContext(conf)

    val ssc = new StreamingContext(sc, Duration(1000))

    ssc.sparkContext.setLogLevel("ERROR")

    val resource: ReceiverInputDStream[String] = ssc.socketTextStream("localhost",8889)

    val format: DStream[(String, Int)] = resource.map(_.split(" ")).map(x=>(x(0),1))

    //统计每次看到的10s的历史记录

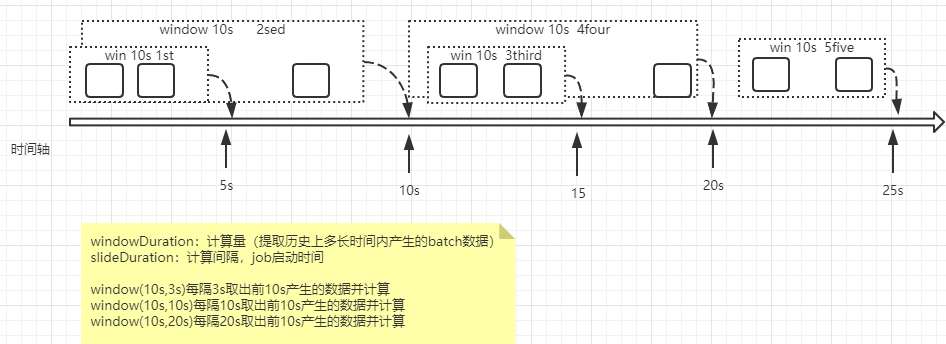
    //windowDuration窗口一次最多批次量,slideDuration滑动间隔(job启动间隔),最好等于winduration

    val res: DStream[(String, Int)] = format.reduceByKeyAndWindow(_+_,Duration(10000),Duration(1000))//每一秒计算最后10s内的数据

    res.print()

    ssc.start()

    ssc.awaitTermination()

  }
window处理流程:
执行流程:
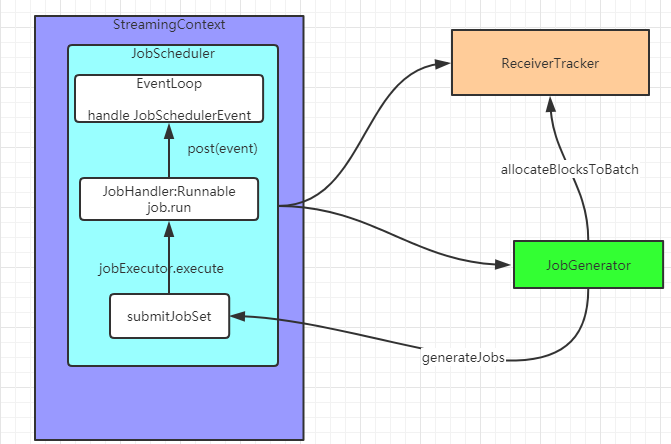
说明:Receiver模式下,接收器创建数据块,每间隔blockInterval 时间产生新的数据块,块的个数N = batchInterval/blockInterval。这些数据块由当前executor的BlockManager发送到其它executor的BlockManager,driver追踪块的位置为下一步计算准备
1,JobScheduler通过EventLoop消息处理机制处理job事件(jobStart,jobCompletion,jobError对job进行标记)使用ThreadPoolExecutor为每个job维护一个thread执行job.run
2,JobGenerator负责job生成,执行checkpoint,清理DStream产生的元数据,触发receiverTracker为下一批次数据建立block块的标记
stream合并与转换:
每个DStream对应一种处理,对于数据源有多种特征需要多个DStream分别处理,最后将结果在一起处理,val joinedStream = windowedStream1.join(windowedStream2)
    val conf: SparkConf = new SparkConf().setAppName("sparkstream").setMaster("local[2]")

    val sc = new SparkContext(conf)

    val ssc = new StreamingContext(sc, Duration(1000))

    ssc.sparkContext.setLogLevel("ERROR")

    val resource: ReceiverInputDStream[String] = ssc.socketTextStream("localhost",8889)

    val format: DStream[(String, Int)] = resource.map(_.split(" ")).map(x=>(x(0),1))

    //transform  加工转换处理

        val res: DStream[(String, Int)] = format.transform( //返回值是RDD

          (rdd )  =>{

            val rddres: RDD[(String, Int)] = rdd.map(x => (x._1, x._2 * 10))//做转换

            rddres

          }

        )

    //末端处理

    format.foreachRDD(    //StreamingContext  有一个独立的线程执行while(true)下面的代码是放到执行线程去执行

      (rdd)=>{

        rdd.foreachPartition { partitionOfRecords =>

//          val connection = createNewConnection()

//          to redis or mysql

//          partitionOfRecords.foreach(record => connection.send(record))

//          connection.close()

        }

      }

    )
Caching / Persistence
在使用window统计时(reduceByWindow ,reduceByKeyAndWindow,updateStateByKey)Dstream会自动调用persist将结果缓存到内存(data serialized)
Checkpointing 保存两种类型数据存储
Metadata:driver端需要的数据
Configuration: application配置信息conf
DStream operations: 定义的Dstream操作集合
Incomplete batches:在队列内还没计算完成的bactch数据
Data checkpointing:已经计算完成的状态数据
设置checkpoint
val ssc = new StreamingContext(...)

ssc.checkpoint(checkpointDirectory)

dstream.checkpoint(checkpointInterval).

......

// Get StreamingContext from checkpoint data or create a new one

val context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext _)

context.
checkpoint依赖外存储,随着batch处理间隔的变短,会使吞吐量显著降低,因此存储间隔要合理设置,系统默认最少10s调用一次,官方建议5s-10s
Spark Streaming实时计算的更多相关文章
- Spark Streaming实时计算框架介绍
随着大数据的发展,人们对大数据的处理要求也越来越高,原有的批处理框架MapReduce适合离线计算,却无法满足实时性要求较高的业务,如实时推荐.用户行为分析等. Spark Streaming是建立在 ...
- 【Streaming】30分钟概览Spark Streaming 实时计算
本文主要介绍四个问题: 什么是Spark Streaming实时计算? Spark实时计算原理流程是什么? Spark 2.X下一代实时计算框架Structured Streaming Spark S ...
- Spark练习之通过Spark Streaming实时计算wordcount程序
Spark练习之通过Spark Streaming实时计算wordcount程序 Java版本 Scala版本 pom.xml Java版本 import org.apache.spark.Spark ...
- 【转】Spark Streaming 实时计算在甜橙金融监控系统中的应用及优化
系统架构介绍 整个实时监控系统的架构是先由 Flume 收集服务器产生的日志 Log 和前端埋点数据, 然后实时把这些信息发送到 Kafka 分布式发布订阅消息系统,接着由 Spark Streami ...
- spark streaming 实时计算
spark streaming 开发实例 本文将分以下几部分 spark 开发环境配置 如何创建spark项目 编写streaming代码示例 如何调试 环境配置: spark 原生语言是scala, ...
- 大数据开发实战:Spark Streaming流计算开发
1.背景介绍 Storm以及离线数据平台的MapReduce和Hive构成了Hadoop生态对实时和离线数据处理的一套完整处理解决方案.除了此套解决方案之外,还有一种非常流行的而且完整的离线和 实时数 ...
- 50、Spark Streaming实时wordcount程序开发
一.java版本 package cn.spark.study.streaming; import java.util.Arrays; import org.apache.spark.SparkCon ...
- Dream_Spark-----Spark 定制版:005~贯通Spark Streaming流计算框架的运行源码
Spark 定制版:005~贯通Spark Streaming流计算框架的运行源码 本讲内容: a. 在线动态计算分类最热门商品案例回顾与演示 b. 基于案例贯通Spark Streaming的运 ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记八之铭文升级版
铭文一级: Spark Streaming is an extension of the core Spark API that enables scalable, high-throughput, ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记二之铭文升级版
铭文一级: 第二章:初识实时流处理 需求:统计主站每个(指定)课程访问的客户端.地域信息分布 地域:ip转换 Spark SQL项目实战 客户端:useragent获取 Hadoop基础课程 ==&g ...
随机推荐
- Django路由层之路由分发 名称空间 虚拟环境 视图层之三板斧 JsonRsponse对象 request对象获取文件 FBV与CBV CBV源码剖析 模板层
目录 路由层之路由分发 路由层之名称空间 方式1:名称空间 方式2:别名不冲突即可 虚拟环境 pycharm创建虚拟环境 命令行形式创建虚拟环境 视图层之三板斧 HttpRsponse render ...
- kali使用命令ifconfig查询ip地址一直为127.0.0.1的解决办法
解决方法: 执行命令:dhclient -v,即可解决
- 02- 快速入门MybatisPlus
创建表 现有一张 User 表,其表结构如下: id name age email 1 Jone 18 test1@baomidou.com 2 Jack 20 test2@baomidou.com ...
- History模式的配置细节
旧文从语雀迁移过来,原日期:2021-09-13 前言 我们知道,vue 单页面应用打包出来是静态资源,一般需要 nginx 或者其他服务器访问:当如果 Vue Router 是采用 History ...
- [Leetcode]反转字符串中的单词 III
题目 代码 class Solution { public: string reverseWords(string s) { for(int i=0,j=0;j<=s.size();j++) { ...
- 《深度探索C++对象模型》第六章 执行期语意学
new运算符和delete运算符 运算符new看似是一个简单的运算,比如: int *pi=new int(5); 但是它实际由两个步骤完成: 1.通过适当的new运算符函数实体,配置所需的内存: / ...
- 解决angular11+zorro使用table组件排序失效以及分页组件失效问题,附完整DEMO代码
关于这个排序失效问题的核心点,跟这个有关系:[nzFrontPagination]="false" 关于分页组件失效的问题,是你获取数据以后,需要给页码,页数,总条数都要重新赋值, ...
- 超级容易理解的Three.js中的物体rotation
假设模特头朝着自己现在躺在地上 那么改变Y就是等于躺着转圈圈 mesh.rotation.set( 0,Math.PI/1.2,0); 改变X就意味着,这个是本来模特头朝着自己躺着,然后站起来了,后脑 ...
- java入门与进阶P-5.5+P-5.6
投票统计 写一个程序,输入数量不确定的[0,9]范围内的整数,统计每一中数字出现的次数,输入-1表示结束 循环遍历 通常都是使用for循环,让循环变量i从0到<数组的length,这样循环体内最 ...
- Linux密钥认证
网站集群批量管理-秘钥认证 一.概述 管理更加轻松:两个节点,通过秘钥形式进行访问,不需要输入密码,单向 应用场景: 一些服务在使用前要求做秘钥认证 手动写批量管理脚本 名字:秘钥认证,免密码登录,双 ...