
【大数据课程】高途课程实践-Day03:Scala实现商品实时销售统计
〇、概述
1、实现内容
使用Scala编写代码,通过Flink的Source、Sink以及时间语义实现实时销量展示
2、过程
(1)导包并下载依赖
(2)创建数据源数据表并写⼊数据
(3)在Mysql数据库中创建统计结果表
(4)编写Flink计算代码
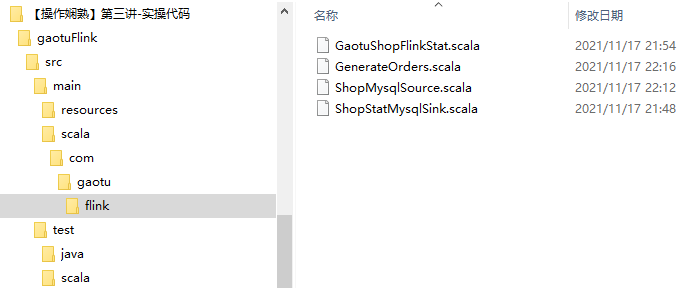
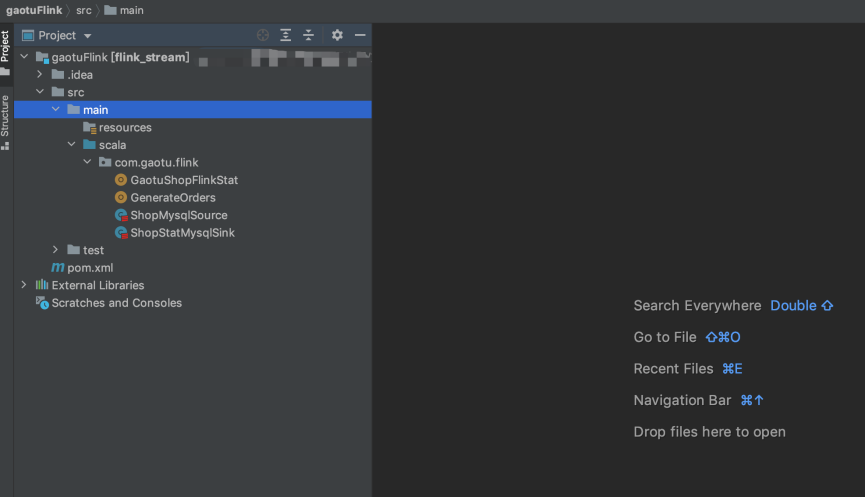
a.参考ShopMysqlSource.scala 代码,进⾏Flink Source 编写,从Mysql读取数据
b.参考GaotuShopFlinkStat.scala代码,进⾏统计逻辑的编写,进⾏FlinkSQL 查询
c.参考ShopStatMysqlSink.scala 代码,进⾏FlinkSink 编写,存⼊数据到Mysql
一、导包并下载依赖
二、创建数据源数据表并写⼊数据
参考执⾏GenerateOrders.scala 代码
package com.gaotu.flink

import org.apache.commons.lang.time.FastDateFormat

import java.sql.DriverManager

import java.sql.Connection

import java.util.concurrent.TimeUnit

import scala.util.Random

/**

 * 向Mysql数据库中添加数据

 * CREATE TABLE `g_orders` (

      `id` int(11) NOT NULL AUTO_INCREMENT COMMENT '交易id',

      `stock_name` varchar(20)DEFAULT NULL COMMENT '商品名称',

      `user_id` int(11) DEFAULT NULL COMMENT '用户id',

      `deal_status` varchar(20) DEFAULT NULL COMMENT '交易状态',

      `stock_cnt` int(11) DEFAULT NULL COMMENT '商品数量',

      `deal_amount` double DEFAULT NULL COMMENT '订单金额',

      `oper_time` bigint  COMMENT '处理时间',

      PRIMARY KEY (`id`)

    ) ENGINE=InnoDB AUTO_INCREMENT=120 DEFAULT CHARSET=utf8;

 *

 */

object GenerateOrders {

  def main(args: Array[String]): Unit = {

    val driver = "com.mysql.cj.jdbc.Driver"

    val url = "jdbc:mysql://localhost/plato"

    val username = "root"

    val password = "root"

    var connection:Connection = null

    //商品数组

    val stocks = Array("HUAWEI Mate40","Apple iphone13","Apple MacBook Pro 14"

      ,"ThinkBook 14p","RedmiBook Pro14","飞鹤星飞帆幼儿奶粉","爱他美 幼儿奶粉"

      ,"李宁运动男卫裤","小米踏步机椭圆机","欧莱雅面膜","御泥坊面膜","欧莱雅男士套装","金六福白酒"

      ,"牛栏山42度","茅台飞天")

    val amount = Array(6569.00,6099.00,14999.00,6799.00,4899.00,275,392,199,1299.00,599,399,389,469,175,1399.00)

    try {

      Class.forName(driver)

      connection = DriverManager.getConnection(url, username, password)

      val ps = connection.createStatement()

      for (i <- 1 to 10000){

        val formater = FastDateFormat.getInstance("yyyy-MM-dd HH:mm:ss")

        val item = scala.util.Random.nextInt(14)

        val deal_time = formater.format(System.currentTimeMillis())

        val stock_name = stocks(item)

        val user_id = Random.nextInt(100)

        val deal_status = "有效"

        val stock_cnt = Random.nextInt(20)

        val deal_amount = amount(item)

        val oper_time = System.currentTimeMillis()

        val query = s"insert into g_orders(deal_time,stock_name,user_id,deal_status,stock_cnt,deal_amount,oper_time) values('$deal_time', '$stock_name', $user_id, '$deal_status', $stock_cnt, $deal_amount, $oper_time)"

        ps.addBatch(query)

        println(query)

        TimeUnit.SECONDS.sleep(1)

      }

      ps.executeBatch()

    } catch {

      case e => e.printStackTrace

    }

    connection.close()

  }

}
三、在Mysql数据库中创建统计结果表
-- 统计结果表
 CREATE TABLE `g_orders_stat` (
 `stock_name` varchar(20)DEFAULT NULL COMMENT '商品名称',
 `order_cnt` int(11) DEFAULT NULL COMMENT '商品数量',
 `stock_sales_cnt` int(11) DEFAULT NULL COMMENT '商品数量',
 `stock_sales_amt` double DEFAULT NULL COMMENT '商品数量'
 ) ENGINE=InnoDB AUTO_INCREMENT=120 DEFAULT CHARSET=utf8;
四、编写Flink计算代码
1、参考ShopMysqlSource.scala 代码,进⾏Flink Source 编写,从Mysql读取数据
package com.gaotu.flink

import org.apache.flink.streaming.api.functions.source.RichSourceFunction

import org.apache.flink.streaming.api.functions.source.SourceFunction.SourceContext

import java.sql.{Connection, DriverManager, PreparedStatement}

import java.util.concurrent.TimeUnit

/*

 * Mysql Source

*/

class ShopMysqlSource extends RichSourceFunction[(Int, String, Int, Double, Long)] {

  val driver = "com.mysql.cj.jdbc.Driver"

  val url = "jdbc:mysql://localhost/plato"

  val username = "root"

  val password = "root"

  override def run(ctx: SourceContext[(Int, String, Int, Double, Long)]): Unit = {

    // 1. 加载MYSQL驱动

    Class.forName(driver)

    // 2. 建立MYSQL链接

    var connection: Connection = DriverManager.getConnection(url, username, password)

    var max_id = 0

    // 3. 创建PreparedStatement

    val sql = s"select id,stock_name,stock_cnt,deal_amount,oper_time from plato.g_orders where id > ${max_id} ;"

    // 4. 执行Sql查询

    val ps: PreparedStatement = connection.prepareStatement(sql)

    for(i <- 0 until 500) {

      val queryRequest = ps.executeQuery()

      // 5. 遍历结果

      while (queryRequest.next()) {

        val id = queryRequest.getInt("id")

        val stock_name = queryRequest.getString("stock_name")

        val stock_cnt = queryRequest.getInt("stock_cnt")

        val deal_amount = queryRequest.getDouble("deal_amount")

        val deal_time = queryRequest.getLong("oper_time")

        ctx.collect((id, stock_name, stock_cnt, deal_amount, deal_time))

        if(max_id < id){

          max_id = id

        }

      }

      TimeUnit.SECONDS.sleep(1)

    }

  }

  override def cancel(): Unit = {}

}
2、参考GaotuShopFlinkStat.scala代码,进⾏统计逻辑的编写,进⾏FlinkSQL 查询
package com.gaotu.flink

import org.apache.flink.api.scala._

import org.apache.flink.streaming.api.TimeCharacteristic

import org.apache.flink.streaming.api.functions.AssignerWithPeriodicWatermarks

import org.apache.flink.streaming.api.scala.{DataStream, StreamExecutionEnvironment}

import org.apache.flink.streaming.api.watermark.Watermark

import org.apache.flink.table.api.{Table, TableEnvironment}

import org.apache.flink.table.api.scala._

/**

 * 实时统计逻辑

 */

object GaotuShopFlinkStat {

  def main(args: Array[String]): Unit = {

    val env = StreamExecutionEnvironment.getExecutionEnvironment   // 1.创建流处理环境

    env.setStreamTimeCharacteristic(TimeCharacteristic.EventTime)  // 2.设置处理时间为事件

    val tableEnv = TableEnvironment.getTableEnvironment(env)       // 3.获取Table运行环境

    val orderDataStream = env.addSource(new ShopMysqlSource)       // 4.获取自定义数据源

    // 5.添加水印,允许延迟2秒

    val watermarkDataStream:DataStream[(Int, String, Int, Double, Long)] = orderDataStream.assignTimestampsAndWatermarks(

      new AssignerWithPeriodicWatermarks[(Int, String, Int, Double, Long)]{

        var currentTimestamp: Long = _

        val delayTime = 2000  // 允许延迟2秒

        override def getCurrentWatermark: Watermark = {                // 生成一个水印时间

          val watermark = new Watermark(currentTimestamp - delayTime)  // 让时间窗口延迟2秒计算

          watermark

        }

        //  从订单中获取对应的时间戳

        override def extractTimestamp(element: (Int, String, Int, Double, Long), previousElementTimestamp: Long): Long = {

          val oper_time = element._5  // 获取订单的事件时间(下单时的时间)

          currentTimestamp = Math.max(currentTimestamp, oper_time) // 当前时间与事件时间对比,获取最大值

          currentTimestamp

        }

      } )

    // 6.注册LinkSQL数据表

    tableEnv.registerDataStream("g_order", watermarkDataStream, 'id,'stock_name,'stock_cnt,'deal_amount,'oper_time,'createTime.rowtime)

    // 7.编写SQL语句进行统计

    val sql =

      """

        | select

        |     stock_name

        |     ,count(id) as order_cnt

        |     ,sum(stock_cnt) as stock_sales_cnt

        |     ,sum(deal_amount) as stock_sales_amt

        | from g_order

        | group by

        | tumble(createTime, interval '5' second ),

        | stock_name

        |""".stripMargin

    // 8.执行sql语句

    val table: Table = tableEnv.sqlQuery(sql)

    table.printSchema()

    // 9.将SQL的执行结果写入到Mysql中

    tableEnv.toAppendStream[(String, Long, Int, Double)](table).addSink(new ShopStatMysqlSink)

    // 10.执行任务

    env.execute()

  }

}
3、参考ShopStatMysqlSink.scala 代码,进⾏FlinkSink 编写,存⼊数据到Mysql
package com.gaotu.flink

import org.apache.flink.configuration.Configuration

import org.apache.flink.streaming.api.functions.sink.RichSinkFunction

import java.sql.{Connection, DriverManager, PreparedStatement}

/**

 * Mysql Sink

 *

 * CREATE TABLE `g_orders_stat` (

  `stock_name` varchar(20)DEFAULT NULL COMMENT '商品名称',

  `order_cnt` int(11) DEFAULT NULL COMMENT '商品数量',

  `stock_sales_cnt` int(11) DEFAULT NULL COMMENT '商品数量',

  `stock_sales_amt` double DEFAULT NULL COMMENT '商品数量'

  ) ENGINE=InnoDB AUTO_INCREMENT=120 DEFAULT CHARSET=utf8;

 *

 */

class ShopStatMysqlSink extends RichSinkFunction[(String, Long, Int, Double)] {

  val driver = "com.mysql.cj.jdbc.Driver"

  val url = "jdbc:mysql://localhost/plato"

  val username = "root"

  val password = "root"

  var connection: Connection = null

  var ps: PreparedStatement = null

  override def open(parameters: Configuration): Unit = {

    Class.forName(driver) // 1. 加载驱动

    connection = DriverManager.getConnection(url, username, password)  // 2. 创建连接

    val sql = "insert into g_orders_stat (stock_name,order_cnt,stock_sales_cnt,stock_sales_amt) values (?,?,?,?);" // 3. 获得执行语句

    ps = connection.prepareStatement(sql)

  }

  override def invoke(value: (String, Long, Int, Double)): Unit = {// 4. 插入数据

    try {

      ps.setString(1, value._1)

      ps.setLong(2, value._2)

      ps.setInt(3, value._3)

      ps.setDouble(4, value._4)

      ps.execute()

    } catch {

      case e: Exception => println(e.getMessage)

    }

  }

  // 5. 关闭连接操作

  override def close(): Unit = {

    if(connection != null) {

      connection.close()

    }

    if(ps != null) {

      ps.close()

    }

  }

}
【大数据课程】高途课程实践-Day03:Scala实现商品实时销售统计的更多相关文章
- MySQL在大数据、高并发场景下的SQL语句优化和"最佳实践"
本文主要针对中小型应用或网站,重点探讨日常程序开发中SQL语句的优化问题,所谓“大数据”.“高并发”仅针对中小型应用而言,专业的数据库运维大神请无视.以下实践为个人在实际开发工作中,针对相对“大数据” ...
- WOT干货大放送:大数据架构发展趋势及探索实践分享
WOT大数据处理技术分会场,PingCAP CTO黄东旭.易观智库CTO郭炜.Mob开发者服务平台技术副总监林荣波.宜信技术研发中心高级架构师王东及商助科技(99Click)顾问总监郑泉五位讲师, ...
- 大数据量高并发的数据库优化详解(MSSQL)
转载自:http://www.jb51.net/article/71041.htm 如果不能设计一个合理的数据库模型,不仅会增加客户端和服务器段程序的编程和维护的难度,而且将会影响系统实际运行的性能. ...
- 网易大数据平台的Spark技术实践
网易大数据平台的Spark技术实践 作者 王健宗 网易的实时计算需求 对于大多数的大数据而言,实时性是其所应具备的重要属性,信息的到达和获取应满足实时性的要求,而信息的价值需在其到达那刻展现才能利益最 ...
- 王家林的81门一站式云计算分布式大数据&移动互联网解决方案课程第14门课程:Android软硬整合设计与框架揭秘: HAL&Framework &Native Service &App&HTML5架构设计与实战开发
掌握Android从底层开发到框架整合技术到上层App开发及HTML5的全部技术: 一次彻底的Android架构.思想和实战技术的洗礼: 彻底掌握Andorid HAL.Android Runtime ...
- IT大数据服务管理高级课程(IT服务,大数据,云计算,智能城市)
个人简历 金石先生是马克思主义中国化的研究学者,上海财经大学经济学和管理学硕士,中国民主建国会成员,中国特色社会主义人文科技管理哲学的理论奠基人之一.金石先生博学多才,对问题有独到见解.专于工作且乐于 ...
- 大数据量高并发的数据库优化,sql查询优化
一.数据库结构的设计 如果不能设计一个合理的数据库模型,不仅会增加客户端和服务器段程序的编程和维护的难度,而且将会影响系统实际运行的性能.所以,在一个系统开始实施之前,完备的数据库模型的设计是必须的. ...
- DB开发之大数据量高并发的数据库优化
一.数据库结构的设计 如果不能设计一个合理的数据库模型,不仅会增加客户端和服务器段程序的编程和维护的难度,而且将会影响系统实际运行的性能.所以,在一个系统开始实施之前,完备的数据库模型的设计是必须的. ...
- 大数据量高并发访问SQL优化方法
保证在实现功能的基础上,尽量减少对数据库的访问次数:通过搜索参数,尽量减少对表的访问行数,最小化结果集,从而减轻网络负担:能够分开的操作尽量分开处理,提高每次的响应速度:在数据窗口使用SQL时,尽量把 ...
- windows下大数据开发环境搭建(3)——Scala环境搭建
一.所需环境 ·Java 8 二.下载Scala https://www.scala-lang.org/download/ 三.配置环境变量 SCALA_HOME: C:\scala Path: ...
随机推荐
- containerd使用总结
# 安装 yum install -y yum-utils yum-config-manager --add-repo http://mirrors.aliyun.com/docker-ce/linu ...
- Form表单数据
官方文档地址:https://fastapi.tiangolo.com/zh/tutorial/request-forms/ 接收的不是 JSON,而是表单字段时,要使用 Form 要使用表单,需预先 ...
- EFK-2:ElasticSearch高性能高可用架构
转载自:https://mp.weixin.qq.com/s?__biz=MzUyNzk0NTI4MQ==&mid=2247483811&idx=1&sn=a413dea65f ...
- 03_配置Java环境变量
配置Java环境变量 右键我的电脑-属性-高级系统设置-环境变量 系统变量-新建-变量名JAVA_HOME,变量值为JDK安装路径 系统变量-新建-变量名CLASSPATH,变量值为英文输入法下的. ...
- HM VNISEdit2.0.3修正版
HM VNISEdit,曾经是NSIS最强最佳开源免费编辑器/IDE,但2003年至今原作者已经接近20年未再更新,随着NSIS3.X版本的普及,NIS Edit不可避免的出现了大大小小的各种BUG, ...
- C语言下for循环的一点技巧总结
for循环是普遍应用与各种计算机语言的一种循环方式. 一般情况下, for循环规则:for(条件一:条件二:条件三) 条件一为满足条件,也就是条件一为1时,进入这个for循环.条件二为循环条件,也就是 ...
- aws-cli命令-ec2实例相关的操作
aws上可以使用aws-cli的方式管理实例,记录一些常用的操作 1.启动.关闭.终止实例(目前笔者发现只能通过指定实例ID进行管理) # 启动/关闭/重启 指定的实例 aws ec2 start-i ...
- 在Tomcat中启用虚拟线程特性
前提 趁着国庆前后阅读了虚拟线程相关的源码,写了一篇<虚拟线程 - VirtualThread源码透视>,里面介绍了虚拟线程的实现原理和使用示例.需要准备做一下前期准备: 安装OpenJD ...
- 使用FreeMarker配置动态模板
FreeMarker动态模板 目录 FreeMarker动态模板 前言 准备工作 FreeMarker 代码构建 项目结构 创建 Configuration 实例 调用 模板文件 调用结果 Tips ...
- 前端框架Vue------>第二天学习(1)插槽
欢迎加入刚建立的社区:http://t.csdn.cn/Q52km 加入社区的好处: 1.专栏更加明确.便于学习 2.覆盖的知识点更多.便于发散学习 3.大家共同学习进步 3.不定时的发现金红包(不多 ...