
spark sql优化
1、内存优化
1.1、RDD
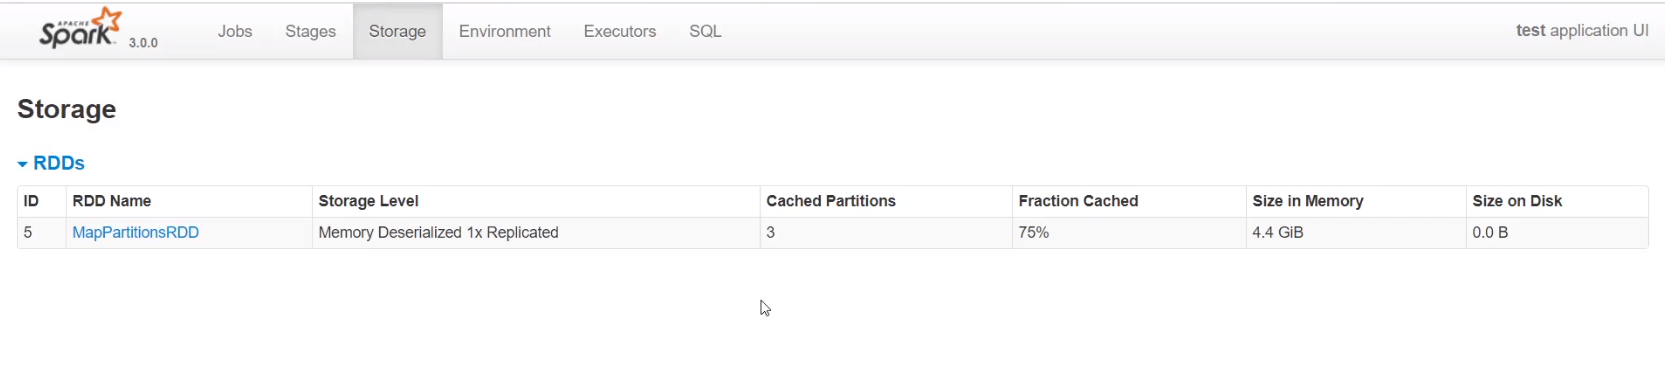
RDD默认cache仅使用内存
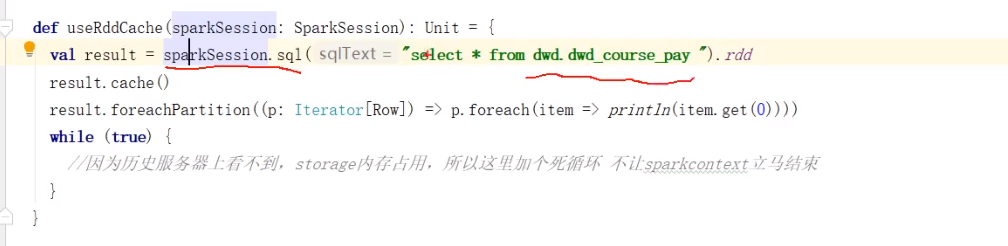
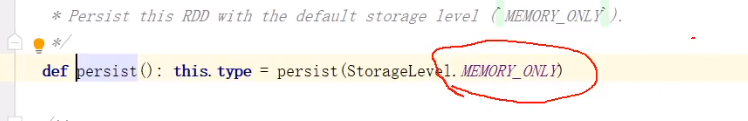
可以看到使用默认cache时,四个分区只在内存中缓存了3个分区,4.4G的数据
使用kryo序列化+MEMORY_ONLY_SER
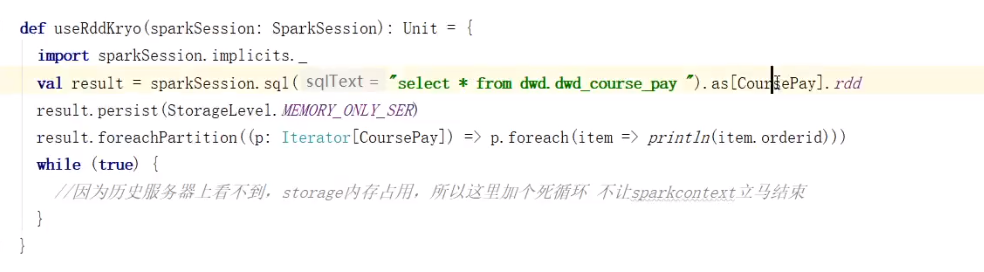

可以看到缓存了四个分区的全部数据,且只缓存了1445.8M
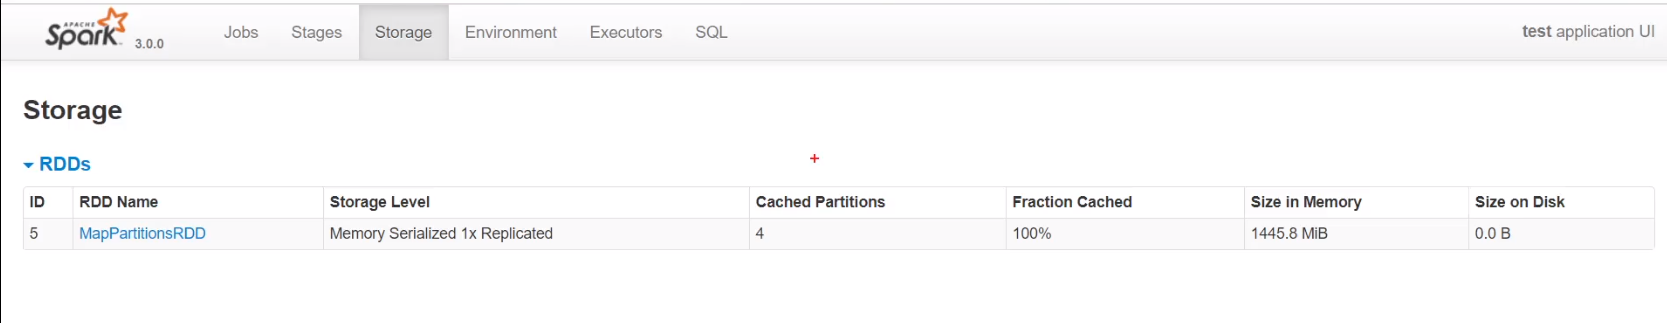
所以这两种缓存方式如何选择,官网建议
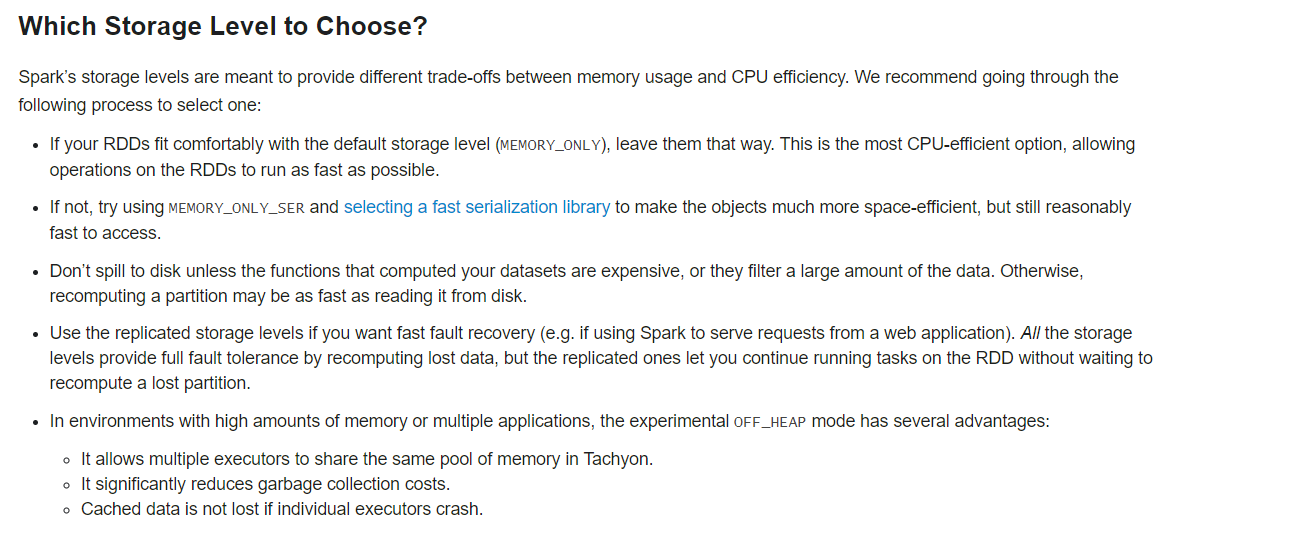
也就是说集群资源足够使用默认cache,资源紧张使用kryo序列化+MEMORY_ONLY_SER
1.2、DataFrame与DataSet
DataSet不使用Java和Kryo序列化,它使用特殊的编码器序列化
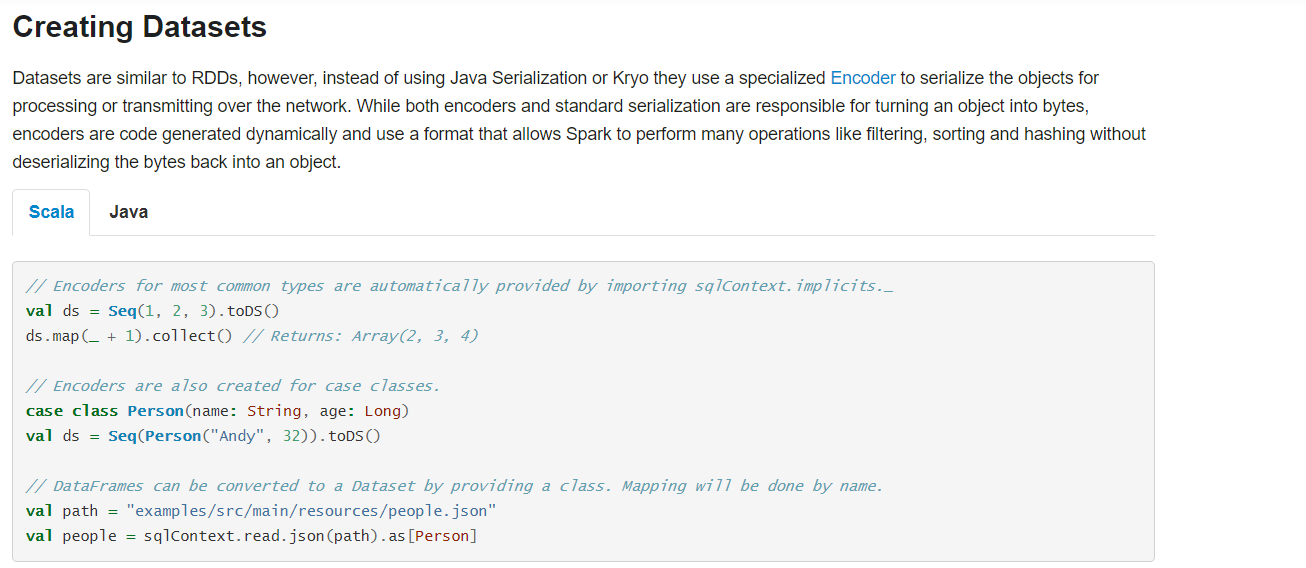
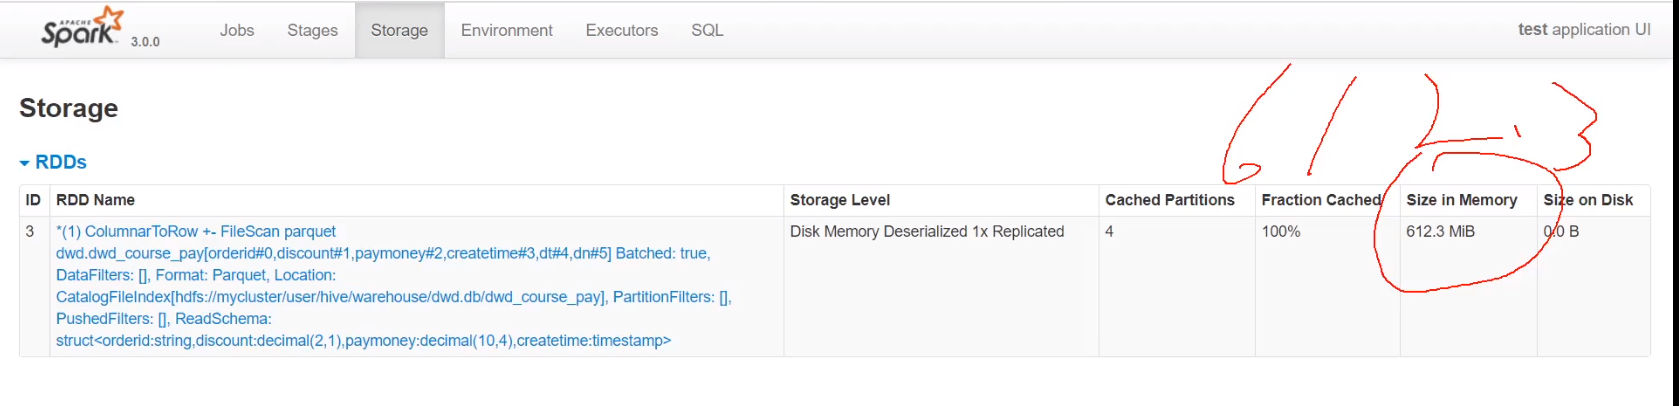
使用默认cache,保存在内存和磁盘
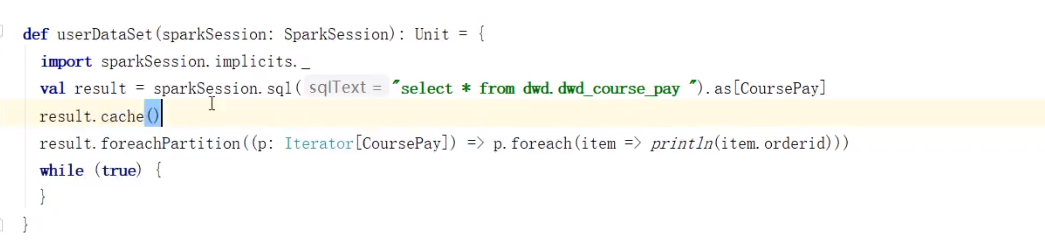
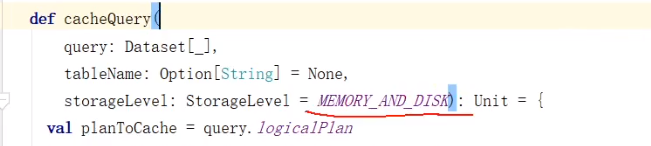
同样多的数据也是全部缓存,只使用了内存612.3M
使用序列化缓存时比使用默认缓存还多缓存了30M,共646.2M
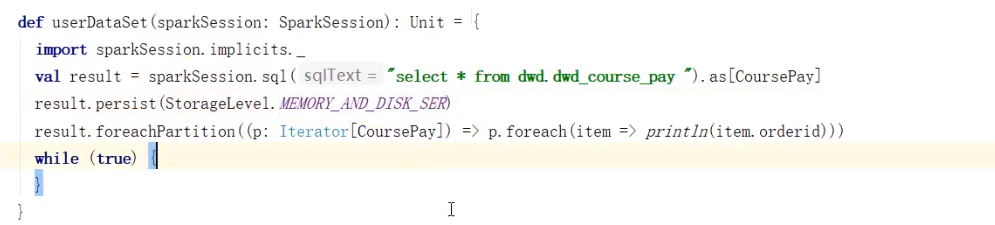

df和ds直接使用默认cache即可
2、小文件过多问题
2.1、RDD中并行度设置
spark.default.parallelism
For distributed shuffle operations like reduceByKey and join, the largest number of partitions in a parent RDD. For operations like parallelize with no parent RDDs, it depends on the cluster manager:
Local mode: number of cores on the local machine
Mesos fine grained mode: 8
Others: total number of cores on all executor nodes or 2, whichever is larger
Default number of partitions in RDDs returned by transformations like join, reduceByKey, and parallelize when not set by user.
2.2、spark sql
Spark SQL can cache tables using an in-memory columnar format by calling sqlContext.cacheTable("tableName") or dataFrame.cache(). Then Spark SQL will scan only required columns and will automatically tune compression to minimize memory usage and GC pressure. You can call sqlContext.uncacheTable("tableName") to remove the table from memory.
建议如果下面无其它任务,缓存可以不释放,有其它任务要释放
算子方式
result.unpersist
spark.sql.shuffle.partitions Configures the number of partitions to use when shuffling data for joins or aggregations.
默认200
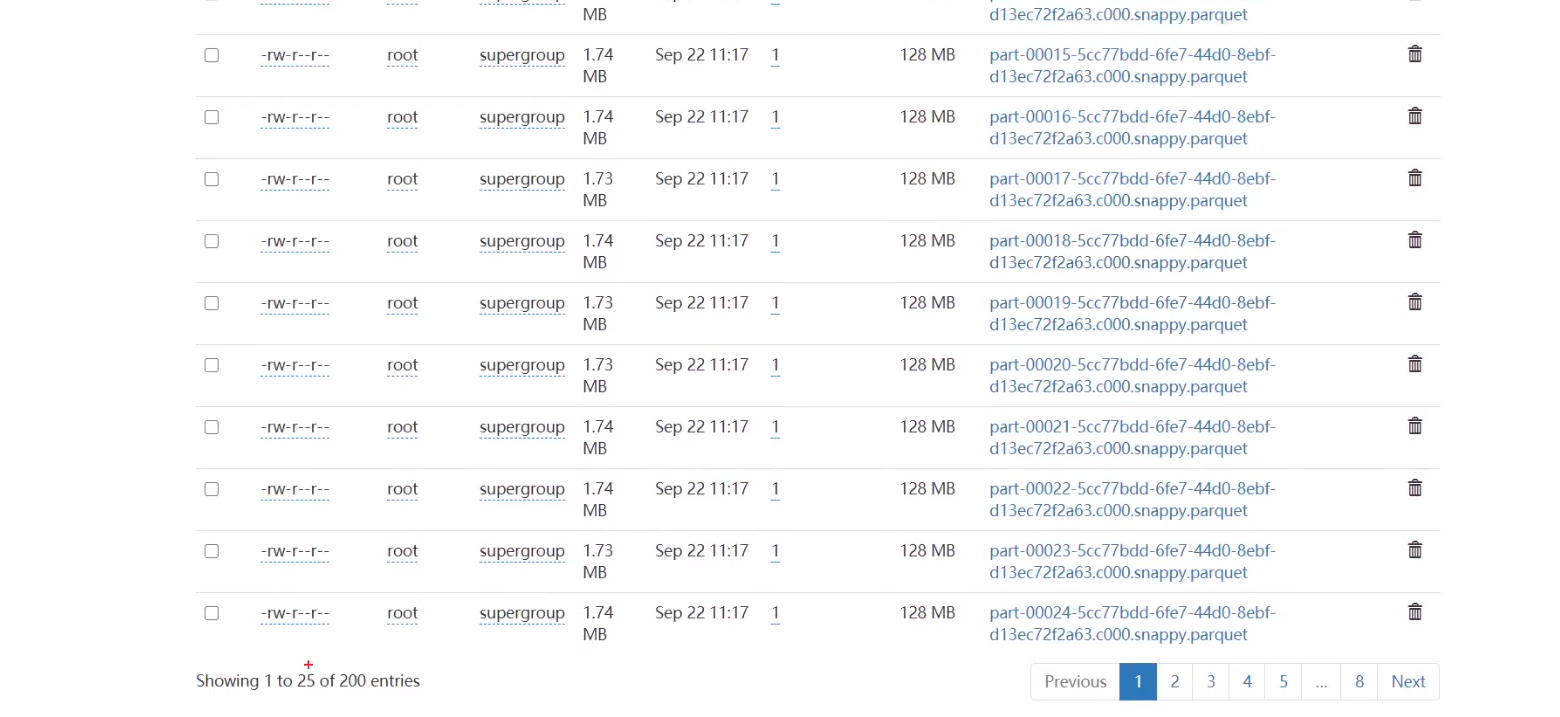
如不减少分区,join后hadoop上会有200个小文件

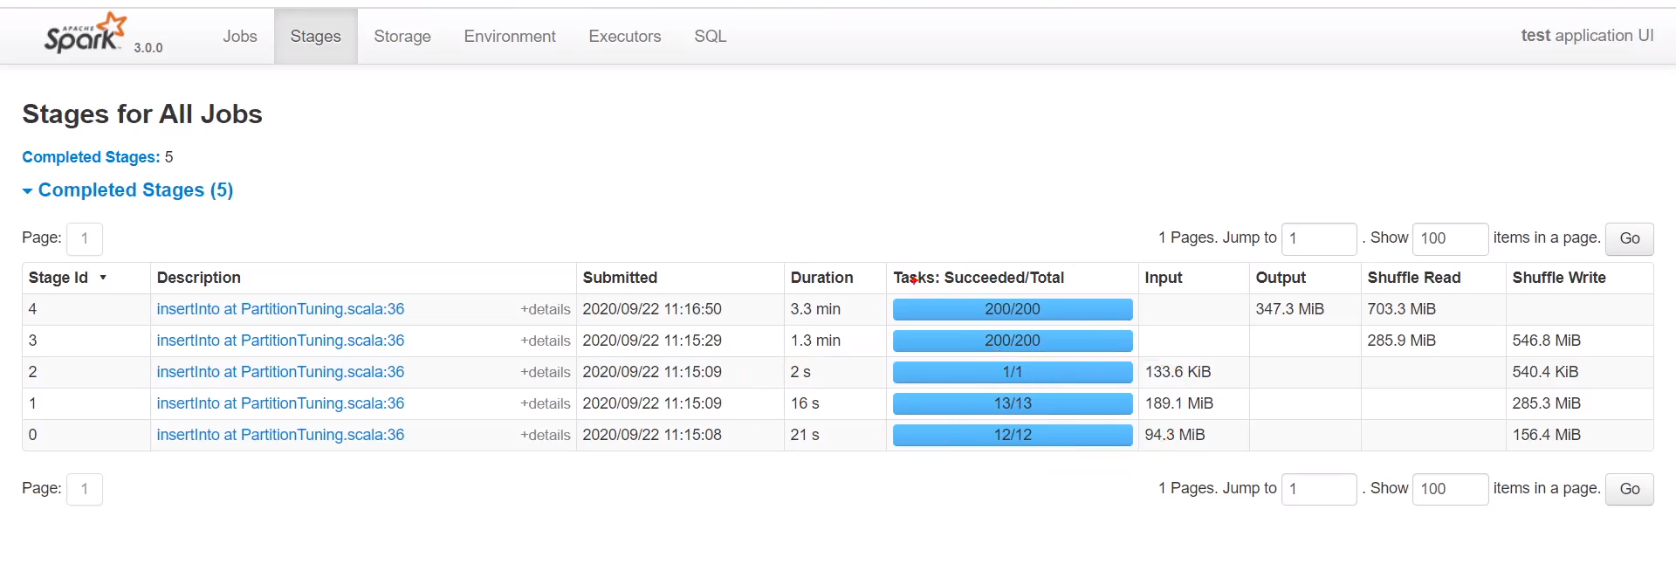
前三个stage为读文件(控制不了),后两个stage为join并行度,为200
1、使用coalesce算子缩小分区,不能大于原有分区数值
2、如果数值小于vcore,有些vcore就不会工作,速度会慢
如压缩成1,并行度就是1只有一个vcore在工作,不会shuffle,如果数据量很大且参数很小,可能会产生oom
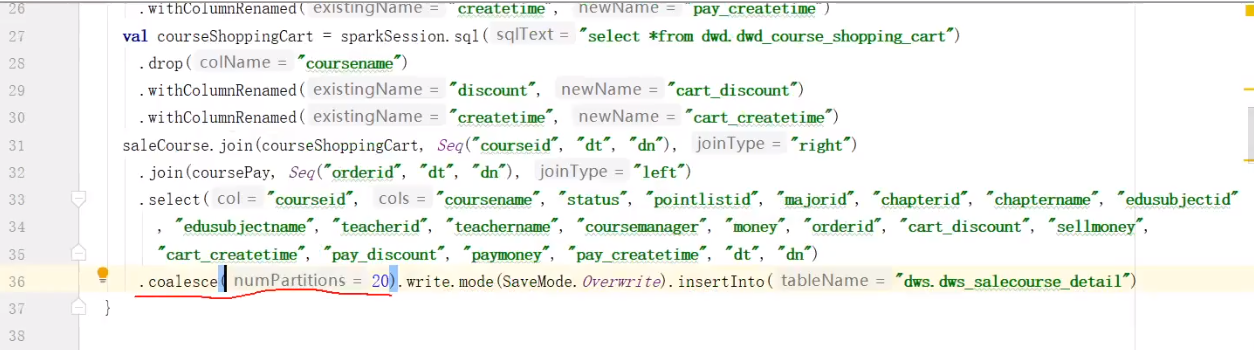
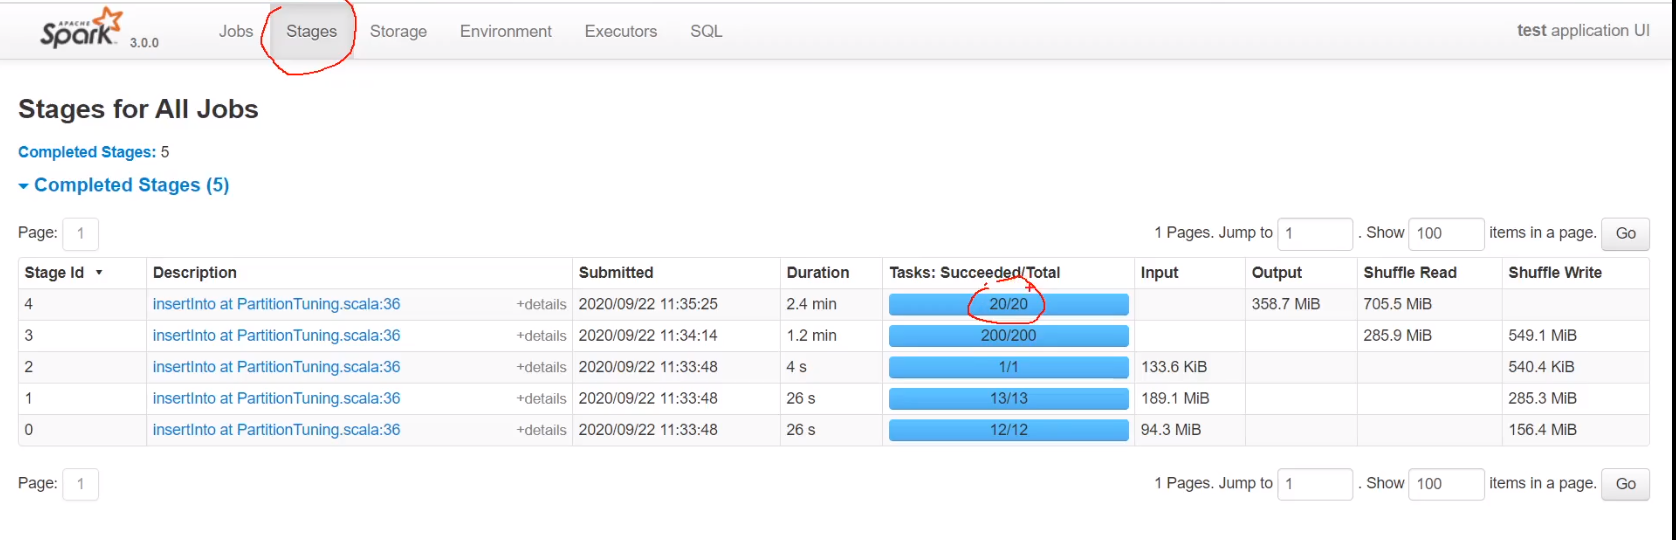
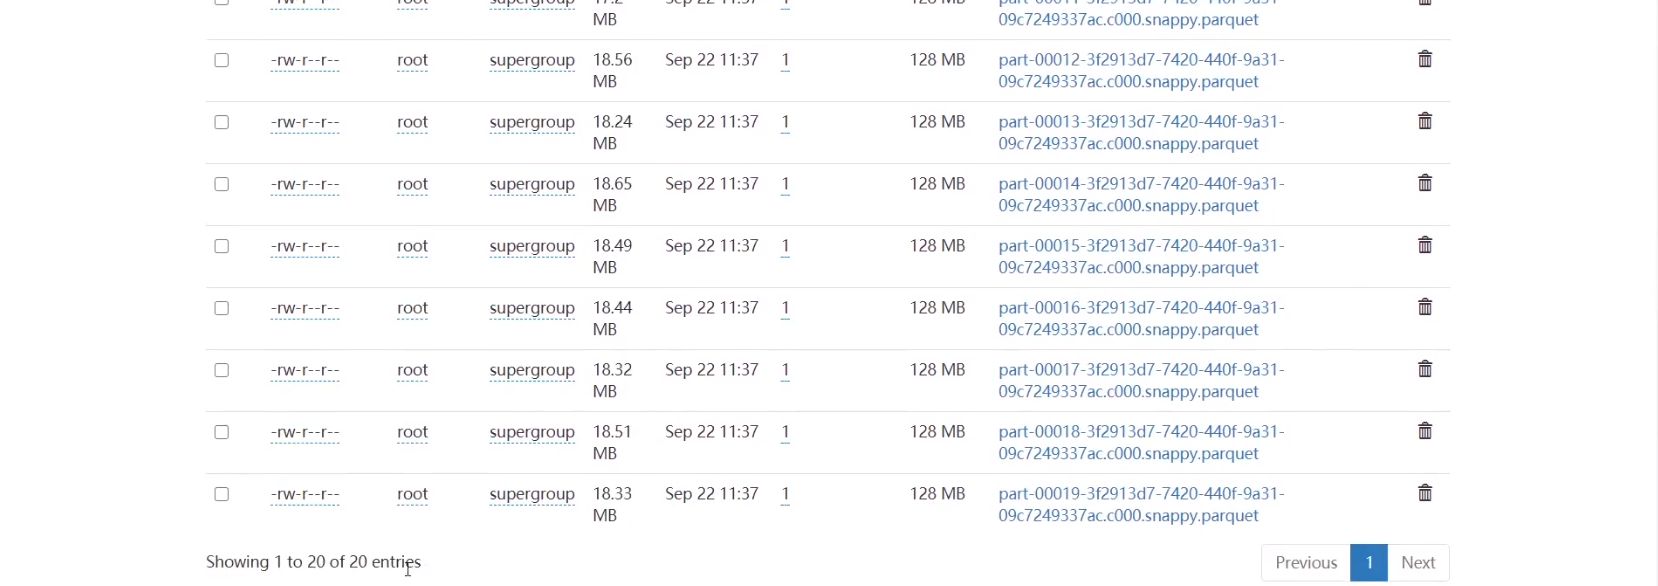
可以看到将分区减少到20,hadoop上只有20个文件
3、合理利用cpu资源
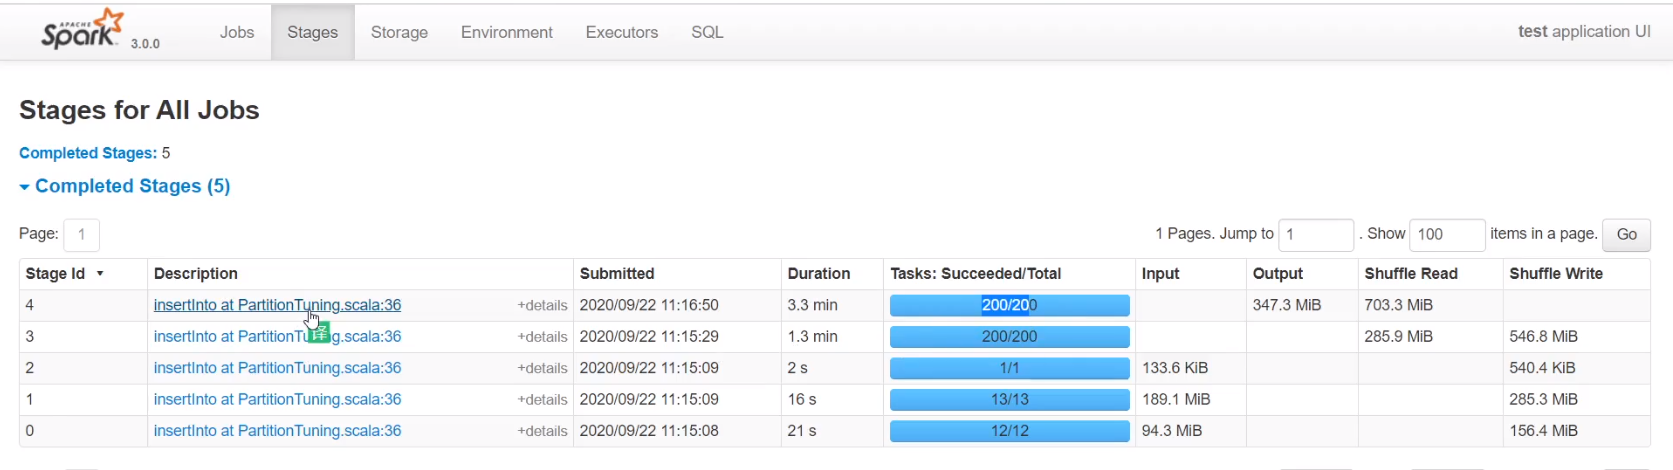
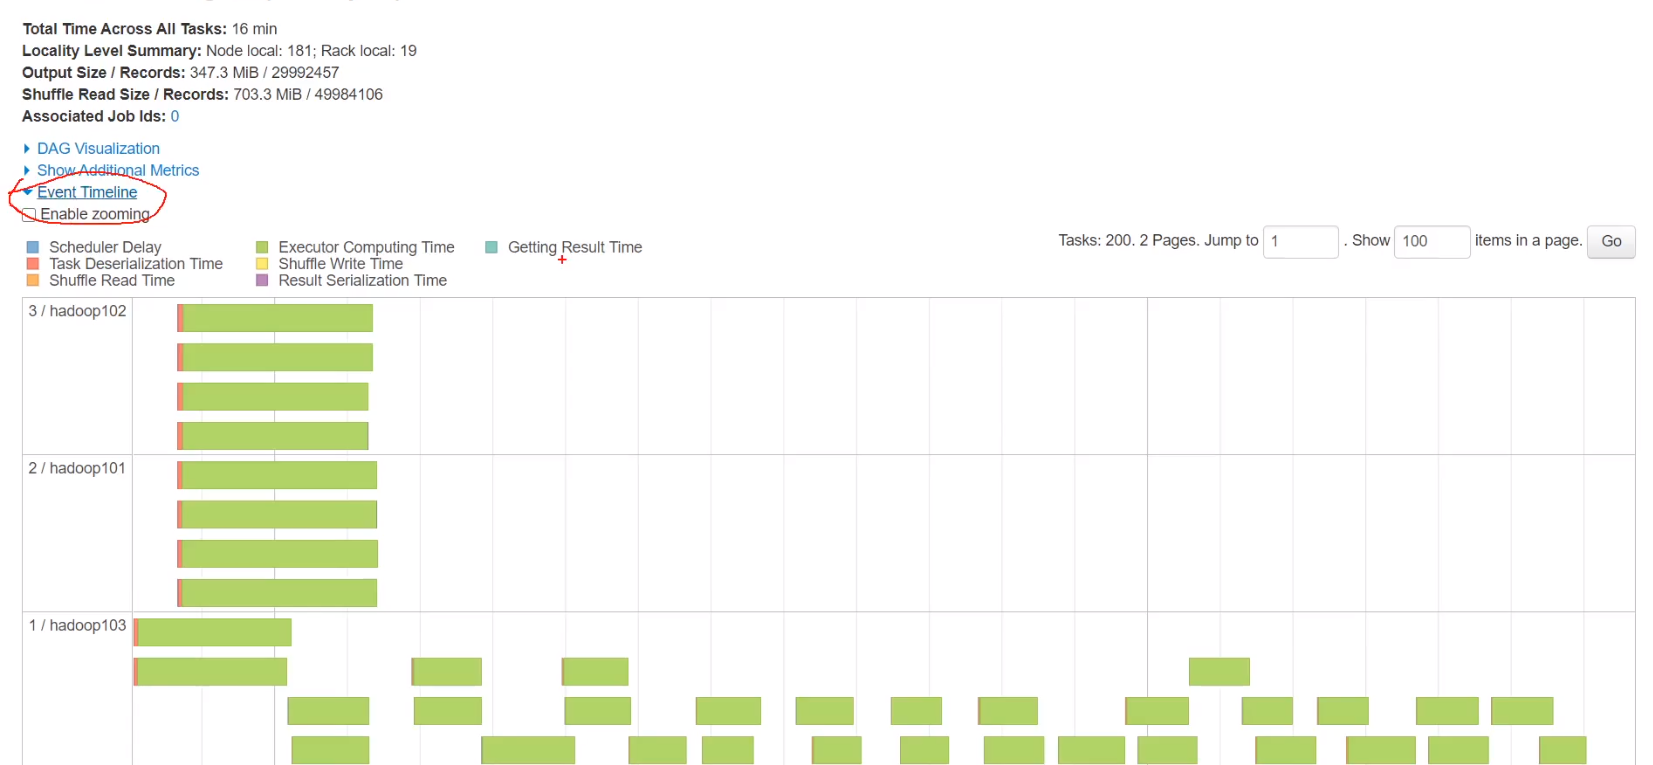
未优化时任务可以看到最后200个任务没有平均分到每台机器上,压力全在hadoop103上,如果数据量很少,hadoop103上有些vcore可能没数据在空转,没有合理利用cpu资源
将·spark.sql.shuffle.partitions设置为总vcore的2到3倍可以达到最优效果

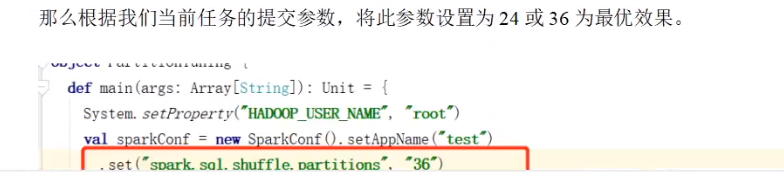

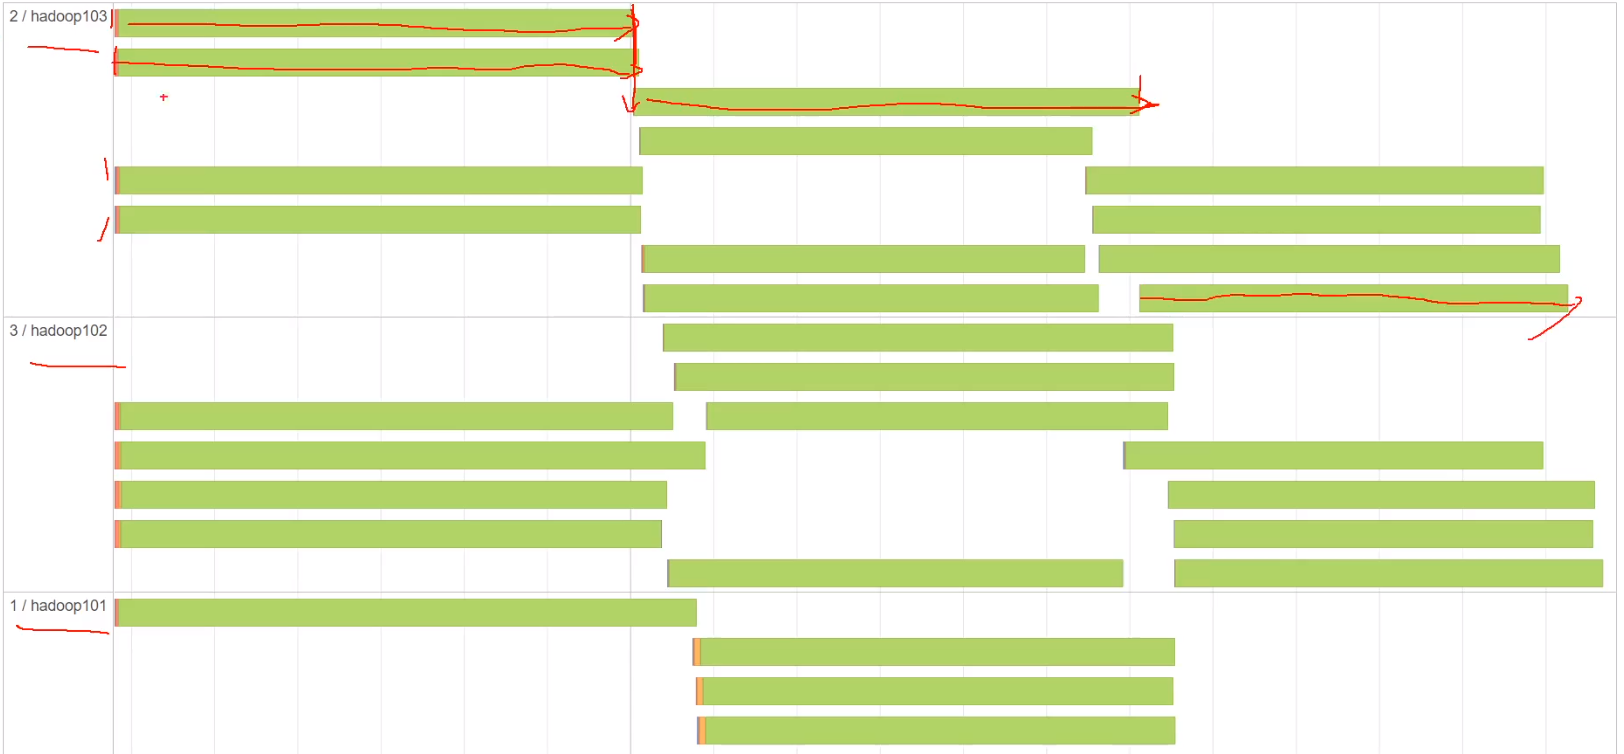
不添加缩小分区coalesce可以看到有36个任务
任务分配也很平均,达到优化效果,避免空转情况,合理利用cpu资源,任务时间缩短到2.5分钟
4、广播join
将小表聚合到driver端,分发到每个executor,规避shuffle,避免此stage
只适合小表join大表
正常大表join大表走SortMergeJoin
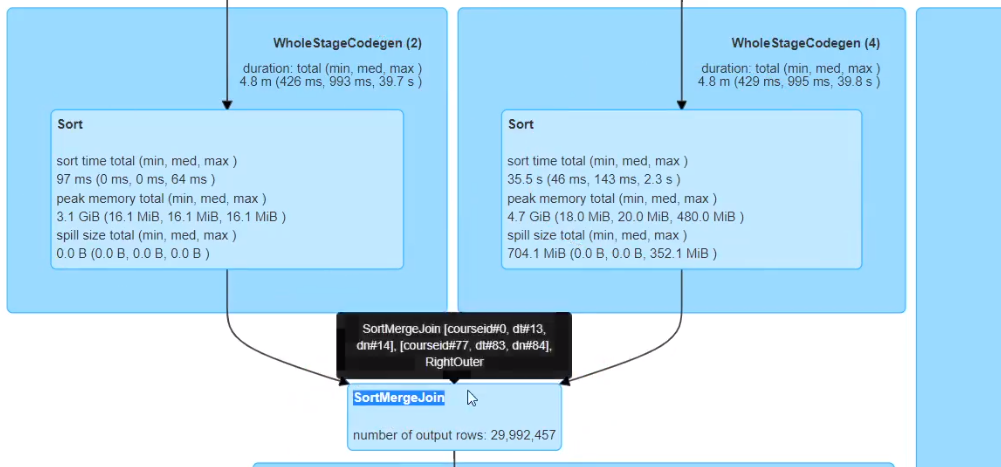
小于等于10M,自动进行广播join
spark.sql.autoBroadcastJoinThreshold 10485760 (10 MB)
Configures the maximum size in bytes for a table that will be broadcast to all worker nodes when performing a join. By setting this value to -1 broadcasting can be disabled. Note that currently statistics are only supported for Hive Metastore tables where the command ANALYZE TABLE <tableName> COMPUTE STATISTICS noscan has been run.
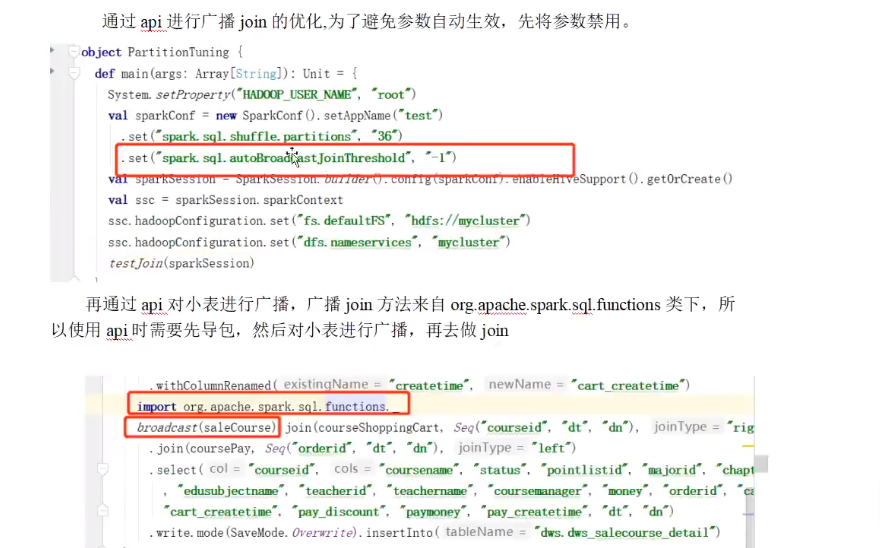
4.1 API
禁用掉广播join ,设置参数为-1
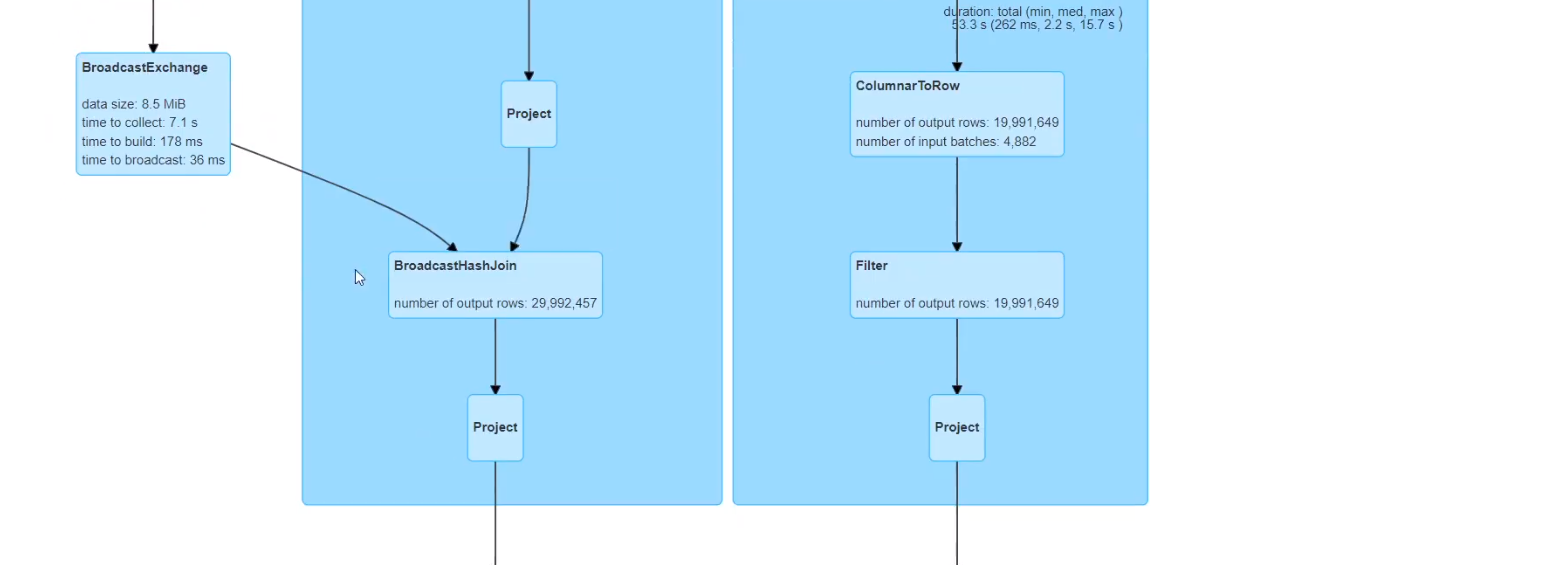
可以看到只剩下一个36task的join stage,多出来一步broadcast exchange,
变成BroadcastHashJoin 耗时变成2分钟

4.2 参数
单位不能是M,10485760
默认10M,实际生产可调大参数,如改成20MB,可以避免小表join大表时数据倾斜
set("spark.sql.autoBroadcastJoinThreshold","20971520")

5、数据倾斜


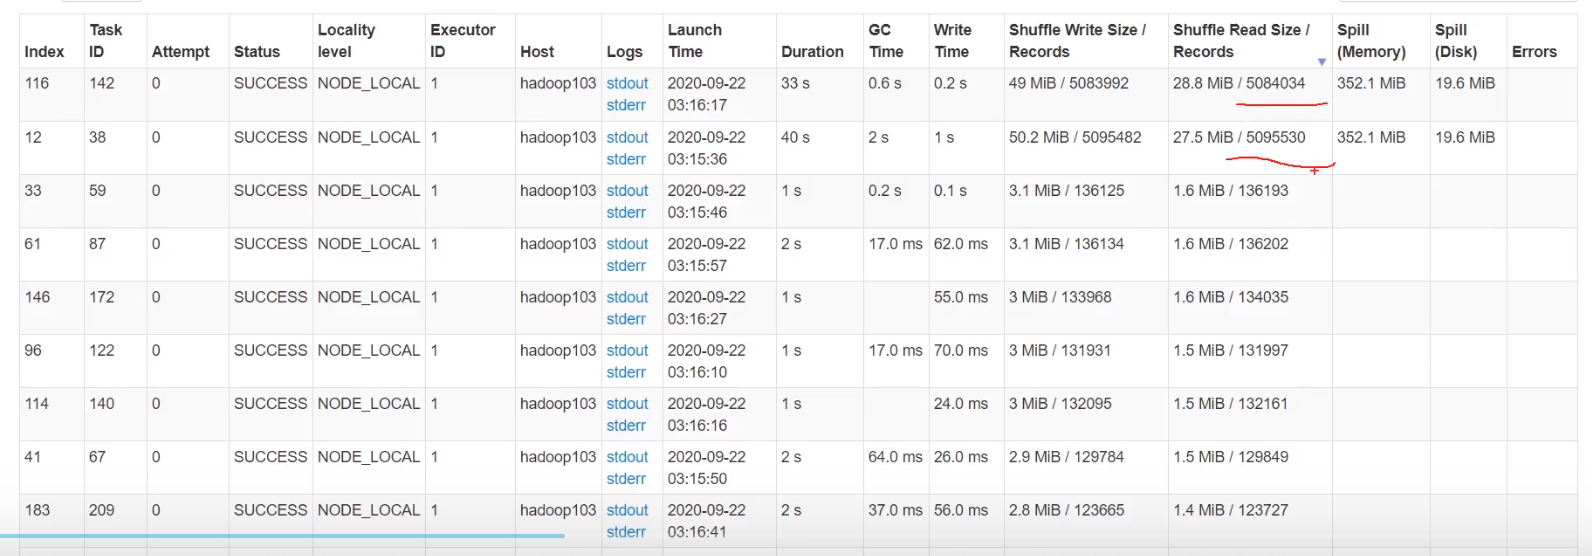
并不只是500万,因为一个分区里不只一个key,包含多个key,如分区1 101 102 分区2 103 104
本质将相同key的数据聚集到一个task
5.1 解决数据倾斜错误方法
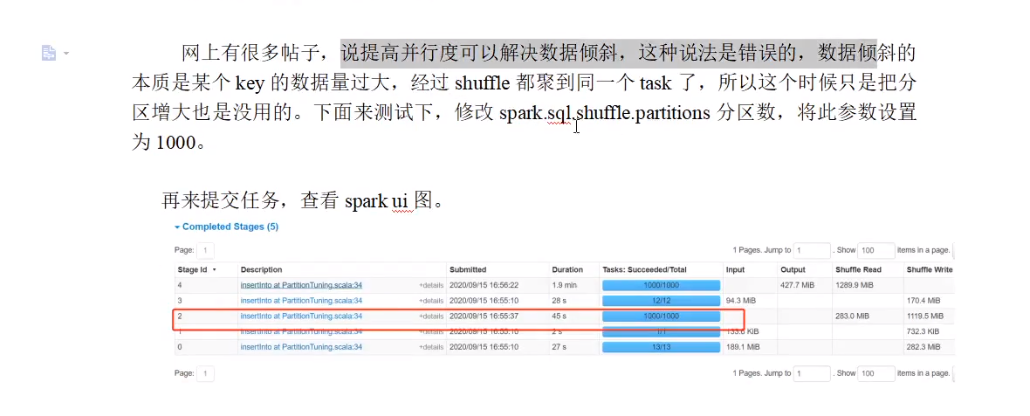

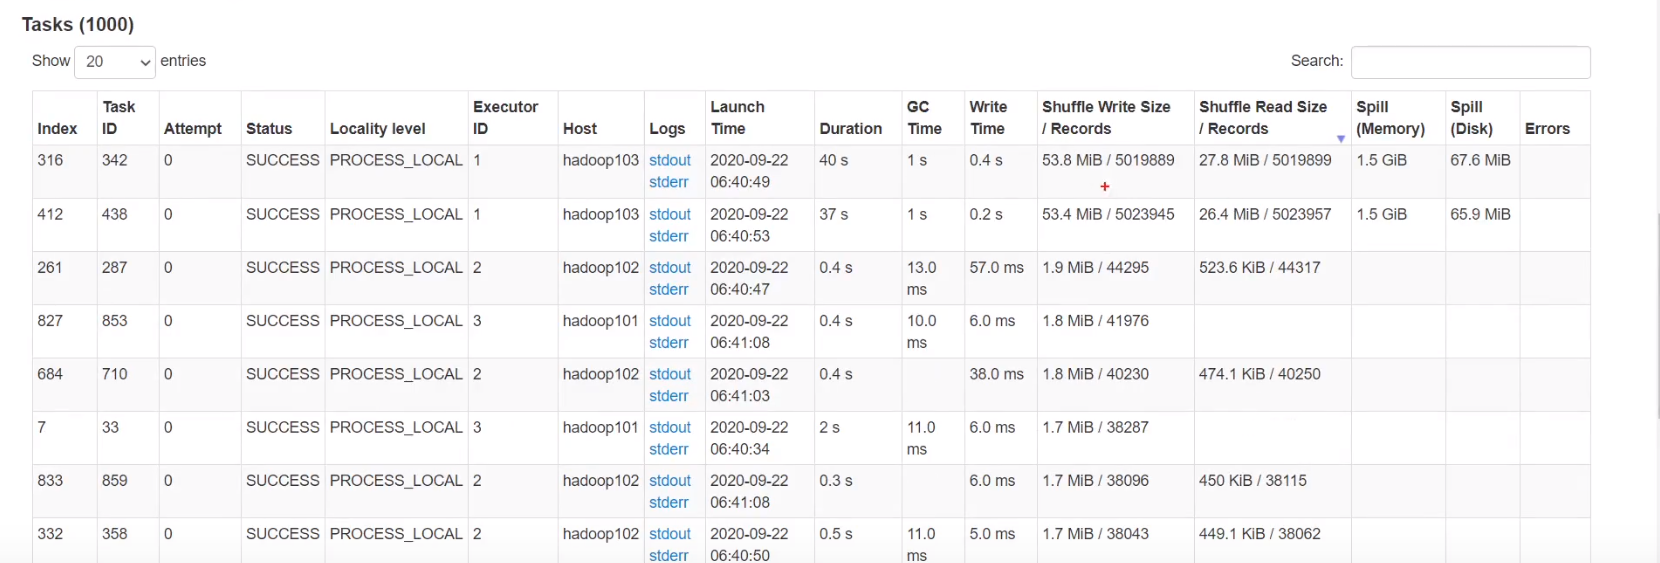
5.2 解决数据倾斜
1、广播join
2、打散大表,扩容小表 能解决,但可能更加耗时,因为小表数据量增加了
除非情况非常严重,结果出不来


拿打散后的courseId进行join

可以看到dataframe.map后变成dataset


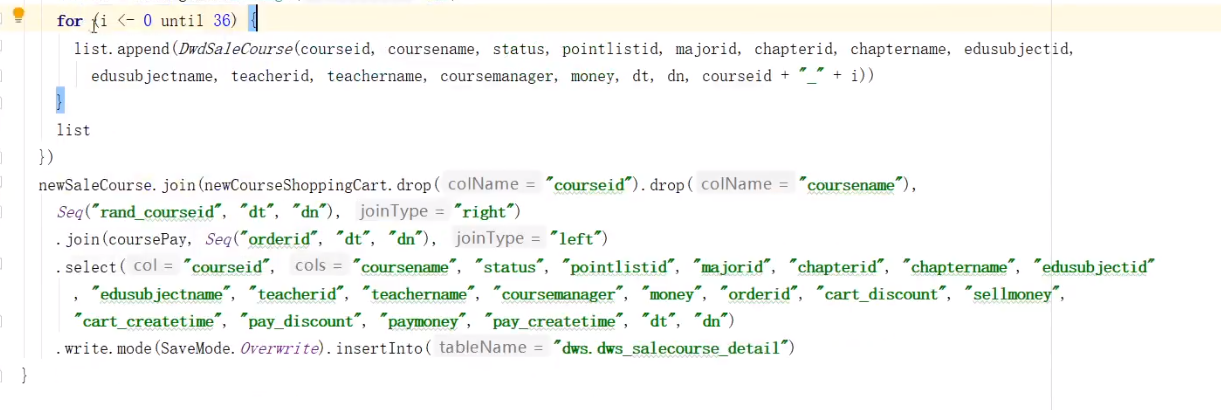
循环里面为i+"_"+courseid,写错了
可以看到已经得到优化
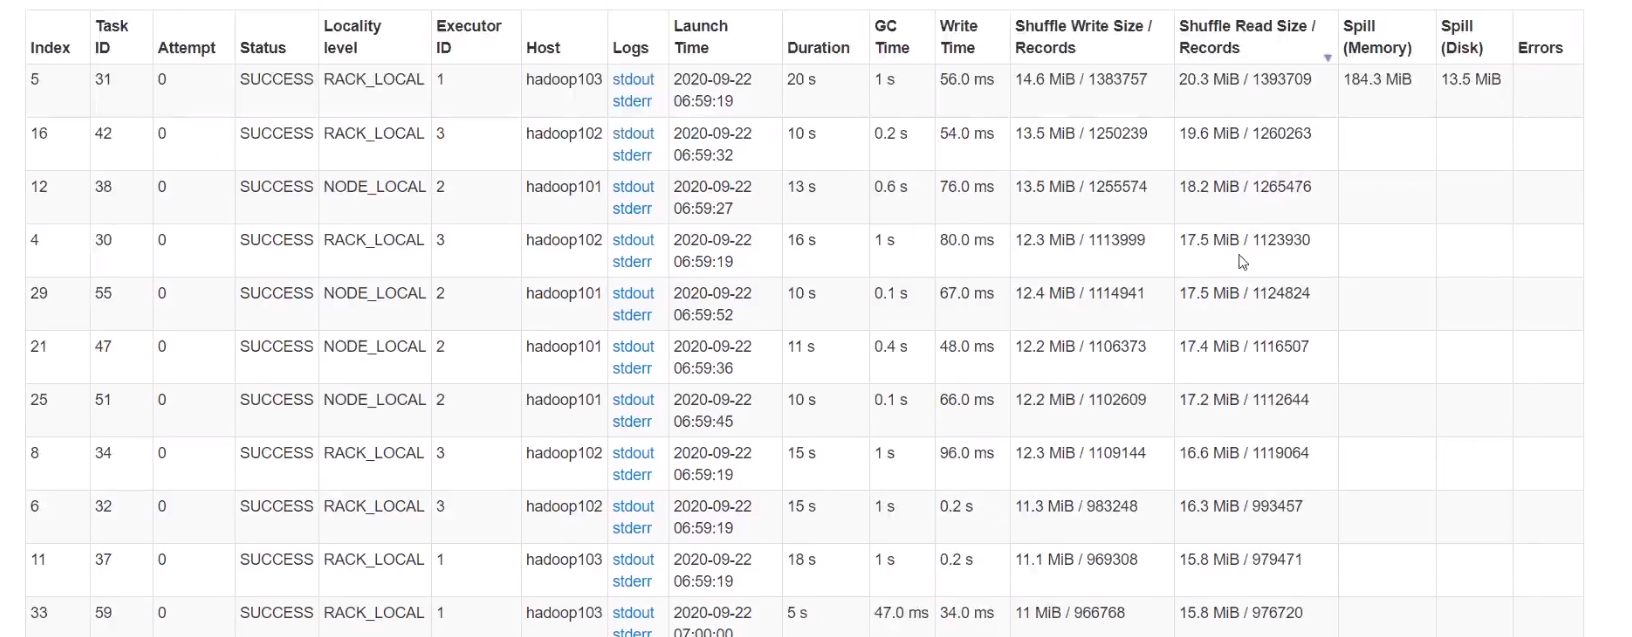
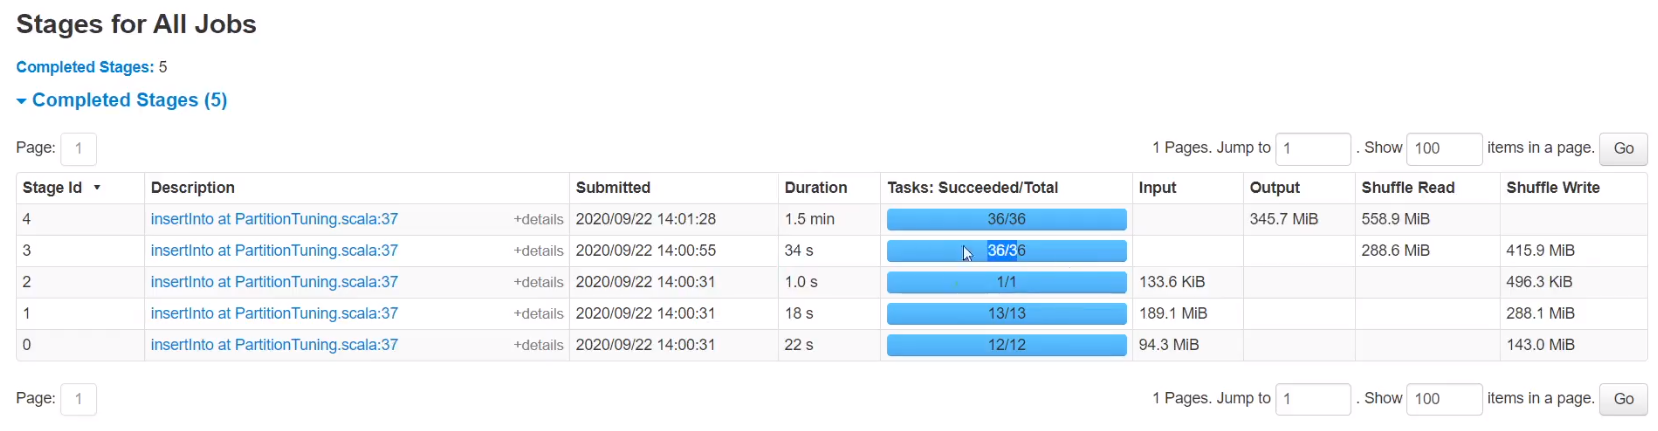
但是时间由变成50秒
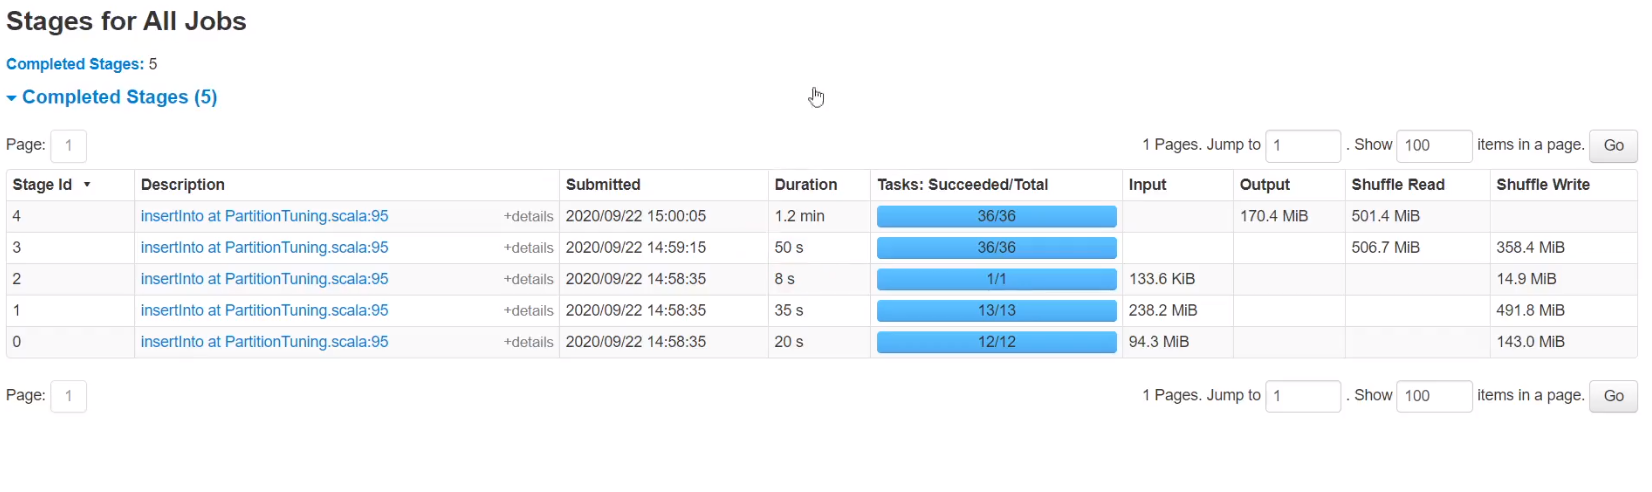
和3中只缩小分区34秒时间增加,虽然3中有数据倾斜

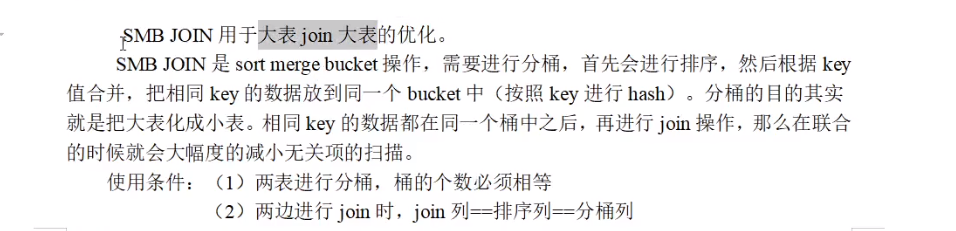
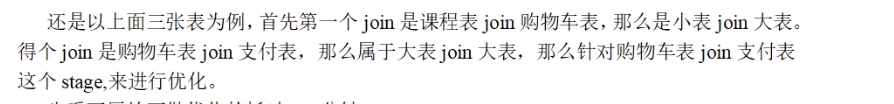
6、SMB join
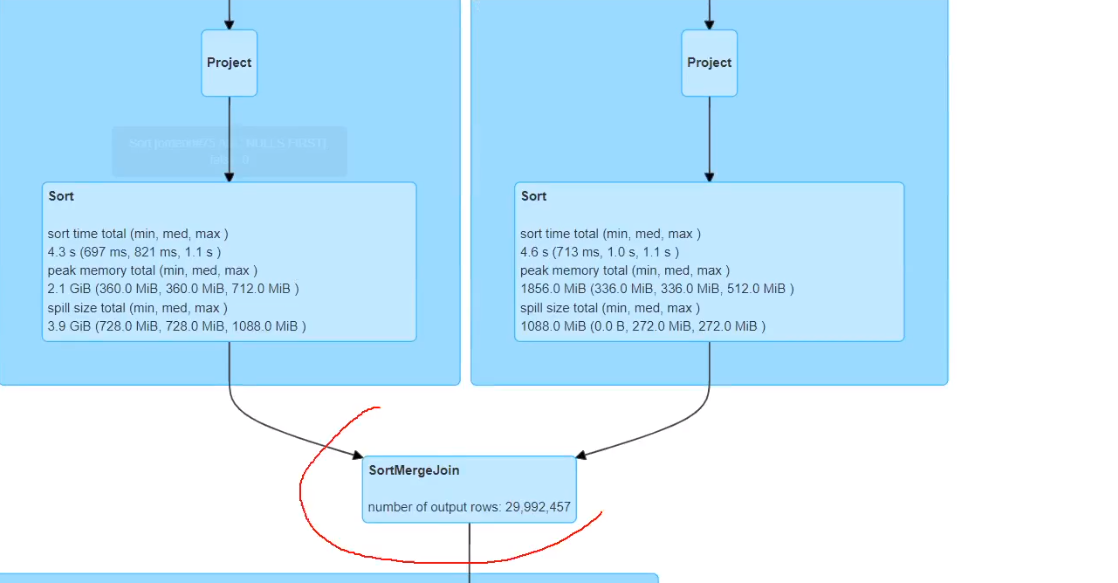
排序时间优化,数据量大的时候效果很明显
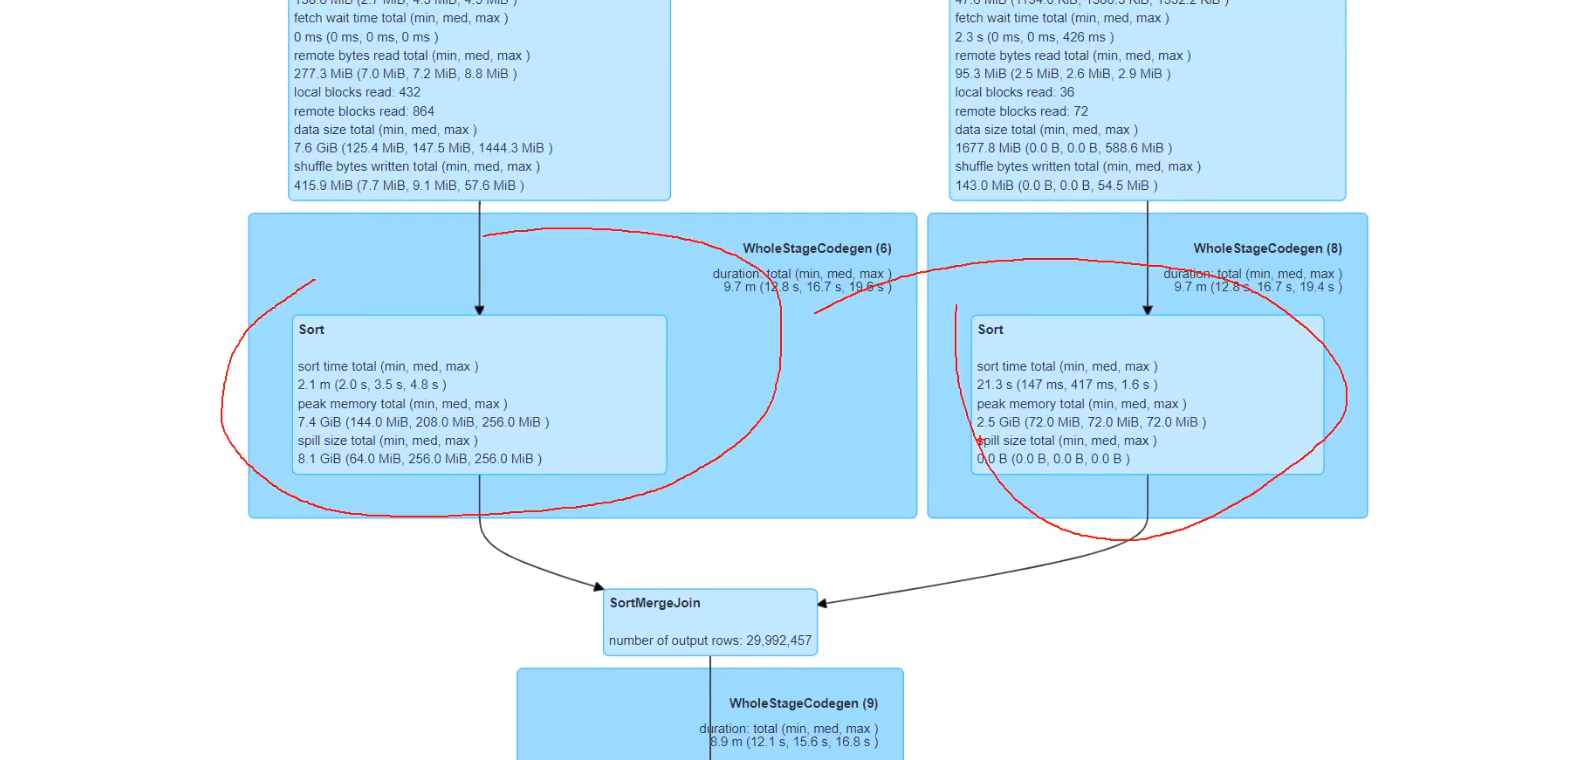
spark中支持分桶必须用saveastable,insertinto不支持分桶

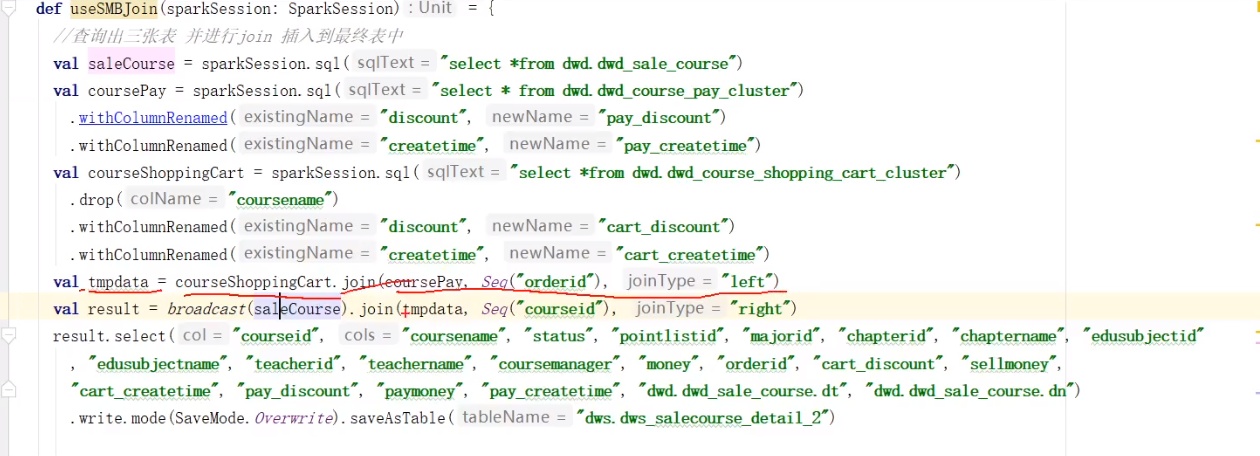
先拿两张分桶表做join
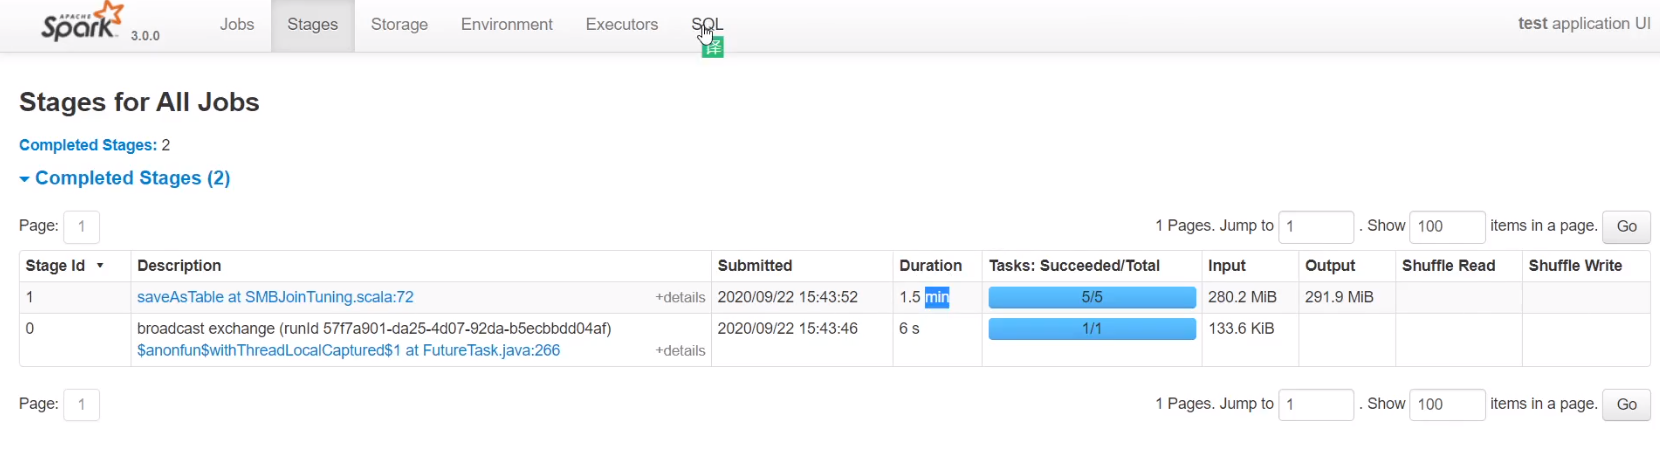
分桶后task数就和分桶数一样
7、使用堆外内存
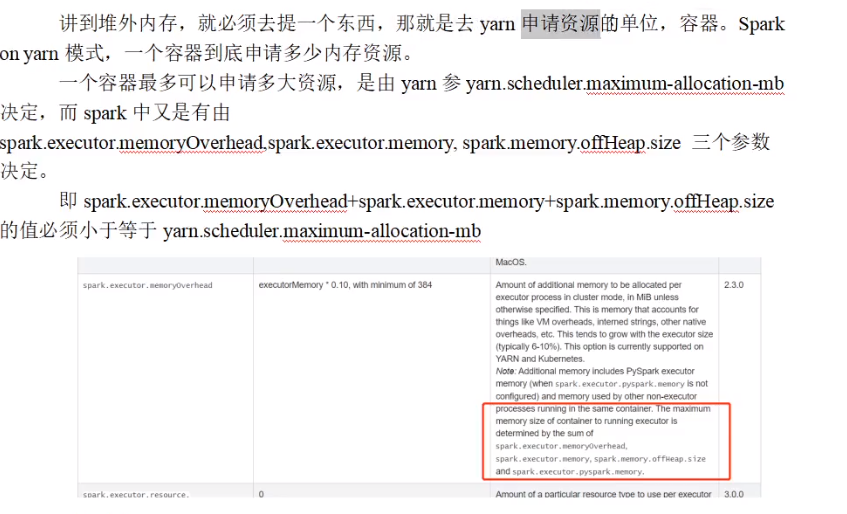

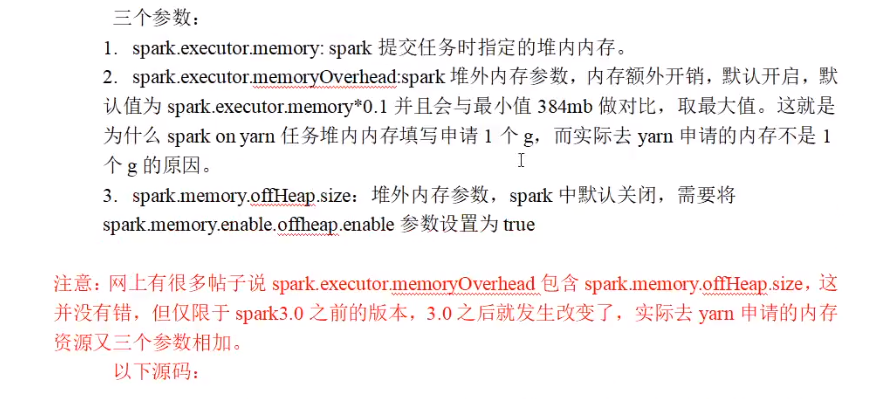
3.0之前
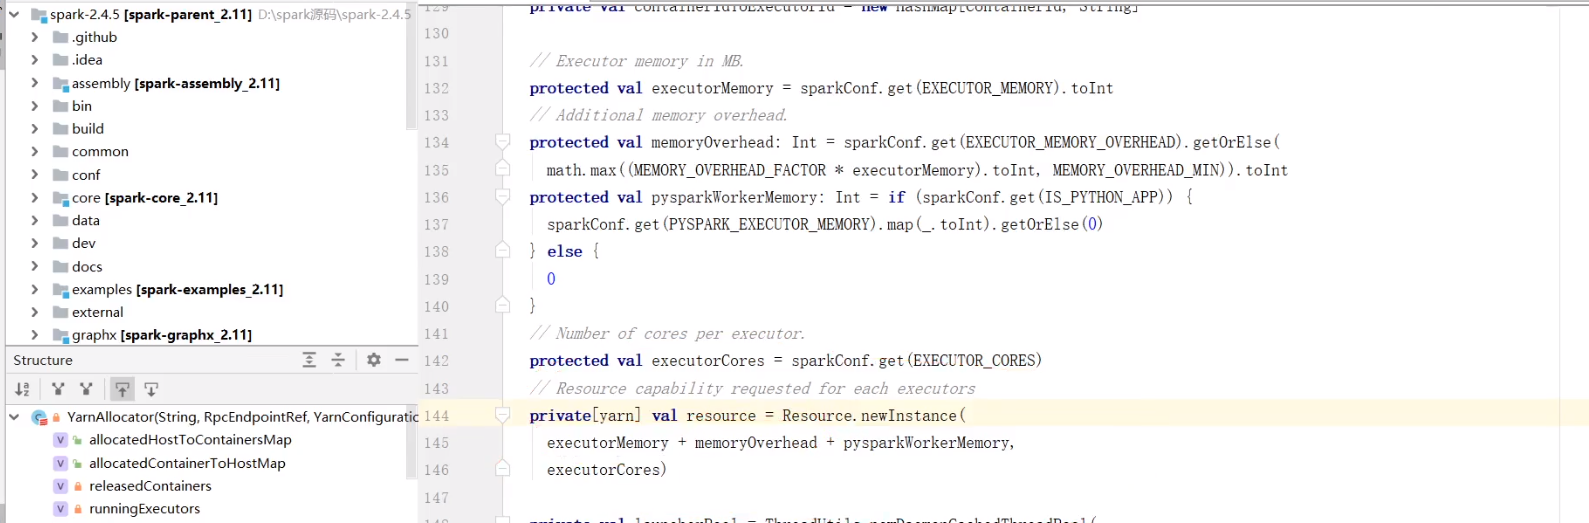
3.0之后

修改内存测试

max(2G*0.1 384)
2G+2G+384>4G
实际申请4个G,申请会大于4个G

堆外内存使用
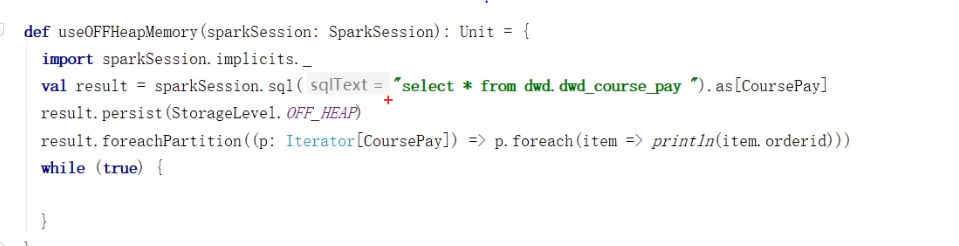
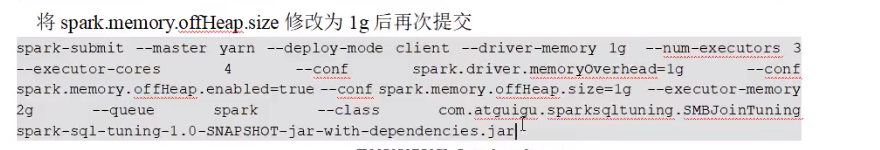
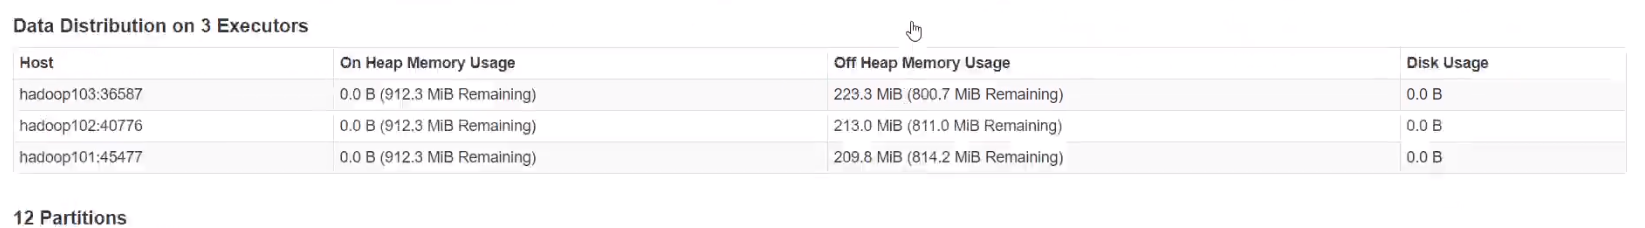

堆内堆外会互相借用
什么情况下使用堆外内存

spark sql优化的更多相关文章
- Spark SQL概念学习系列之Spark SQL 优化策略(五)
查询优化是传统数据库中最为重要的一环,这项技术在传统数据库中已经很成熟.除了查询优化, Spark SQL 在存储上也进行了优化,从以下几点查看 Spark SQL 的一些优化策略. (1)内存列式存 ...
- spark sql 优化心得
本篇文章主要记录最近在使用spark sql 时遇到的问题已经使用心得. 1 spark 2.0.1 中,启动thriftserver 或者是spark-sql时,如果希望spark-sql run ...
- spark第七篇:Spark SQL, DataFrame and Dataset Guide
预览 Spark SQL是用来处理结构化数据的Spark模块.有几种与Spark SQL进行交互的方式,包括SQL和Dataset API. 本指南中的所有例子都可以在spark-shell,pysp ...
- spark SQL (一)初识 ,简介
一, 简介 Spark SQL是用于结构化数据处理的Spark模块.与基本的Spark RDD API不同,Spark SQL提供的接口为Spark提供了关于数据结构和正在执行的计算的更多信息.在内部 ...
- Spark SQL知识点大全与实战
Spark SQL概述 1.什么是Spark SQL Spark SQL是Spark用于结构化数据(structured data)处理的Spark模块. 与基本的Spark RDD API不同,Sp ...
- Spark SQL知识点与实战
Spark SQL概述 1.什么是Spark SQL Spark SQL是Spark用于结构化数据(structured data)处理的Spark模块. 与基本的Spark RDD API不同,Sp ...
- 深入研究Spark SQL的Catalyst优化器(原创翻译)
Spark SQL是Spark最新和技术最为复杂的组件之一.它支持SQL查询和新的DataFrame API.Spark SQL的核心是Catalyst优化器,它以一种新颖的方式利用高级编程语言特性( ...
- Spark SQL 性能优化再进一步:CBO 基于代价的优化
摘要: 本文将介绍 CBO,它充分考虑了数据本身的特点(如大小.分布)以及操作算子的特点(中间结果集的分布及大小)及代价,从而更好的选择执行代价最小的物理执行计划,即 SparkPlan. Spark ...
- 47、Spark SQL核心源码深度剖析(DataFrame lazy特性、Optimizer优化策略等)
一.源码分析 1. ###入口org.apache.spark.sql/SQLContext.scala sql()方法: /** * 使用Spark执行一条SQL查询语句,将结果作为DataFram ...
随机推荐
- Redis缓存篇(四)缓存异常
这一节,我们来学习一下缓存异常.缓存异常有四种类型,分别是缓存和数据库的数据不一致.缓存雪崩.缓存击穿和缓存穿透. 下面通过了解这四种缓存异常的原理和应对方法. 缓存和数据库的数据不一致 缓存和数据库 ...
- ethernet
OSI参考模型 简化相关网络操作:提供不同厂商之间的互联 应用层 为应用程序提供服务 HTTP Telnet 表示层 数据格式化,加密.解密 ASCII EBCDIC JPEG 会话层 建立.维护.管 ...
- SqlLoad的简单使用
sqlload的简单使用: 能实现: 快速导入大量数据 1.先安装oracle 客户端机器.有点大,600M+, 2.安装时选择管理员安装(1.1g) 3.第三步的时候我的出错了.说是环境变量校验不通 ...
- web渗透之常见shell反弹姿势
常见反弹shell总结: 原文链接请点击:https://ruoli-s.github.io/posts/b956.html 一.bash反弹 通用 ① 在kali机里面开启端口监听: nc -lvv ...
- 容器编排系统K8s之crd资源
前文我们了解了k8s节点污点和pod的对节点污点容忍度相关话题,回顾请参考:https://www.cnblogs.com/qiuhom-1874/p/14255486.html:今天我们来聊一下扩展 ...
- 【MySQL 基础】MySQ LeetCode
MySQL LeetCode 175. 组合两个表 题目描述 表1: Person +-------------+---------+ | 列名 | 类型 | +-------------+----- ...
- 容器编排系统K8s之HPA资源
前文我们了解了用Prometheus监控k8s上的节点和pod资源,回顾请参考:https://www.cnblogs.com/qiuhom-1874/p/14287942.html:今天我们来了解下 ...
- MoChat - 国内首款完全开源的 PHP 企业微信管理系统正式发布
MoChat -- 让企业微信开发更简单 项目地址 Github: https://github.com/mochat-cloud/mochat Gitee: https://gitee.com/mo ...
- 利用Numpy求解投资内部收益率IRR
一. 内部收益率和净现值 内部收益率(Internal Rate of Return, IRR)其实要和净现值(Net Present Value, NPV)结合起来讲.净现值指的是某个投资项目给公司 ...
- sentinel-实战
sentinel-实战笔记 什么是Sentinel Sentinel是阿里开源的项目,提供了流量控制.熔断降级.系统负载保护等多个维度来保障服务之间的稳定性. Sentinel主要特性: 获取Sent ...