
ClickHouse安装使用(单机、集群、高可用)
Clickhouse版本:20.3.6.40-2
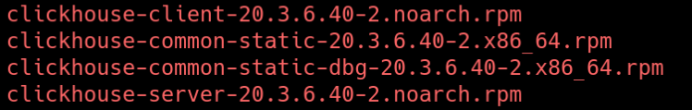
安装包地址:https://repo.yandex.ru/clickhouse/rpm/stable/x86_64/
一、单机版
1、安装依赖
yum install libicu.x86_64
2、下载安装包
http://repo.yandex.ru/clickhouse/rpm/
3、安装
rpm -ivh *.rpm --force --nodeps
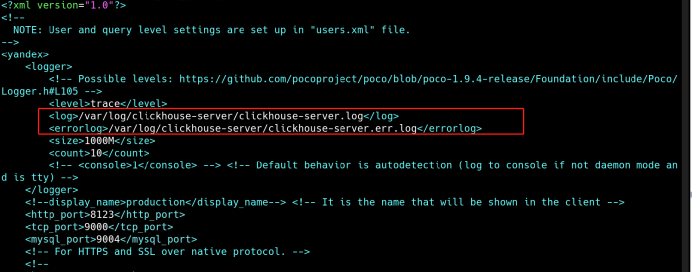
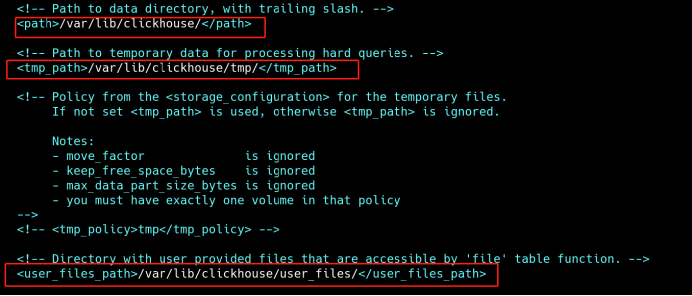
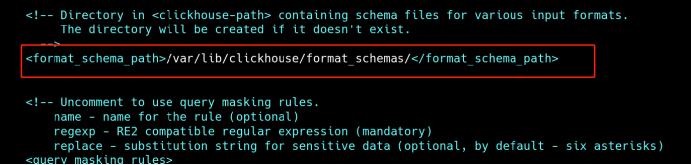
4、修改数据、日志目录
vi /etc/clickhouse-server/config.xml
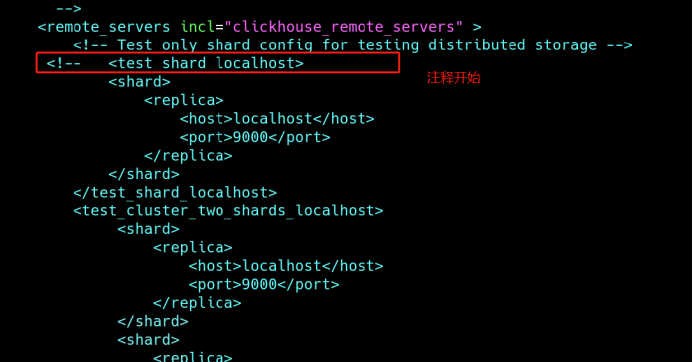
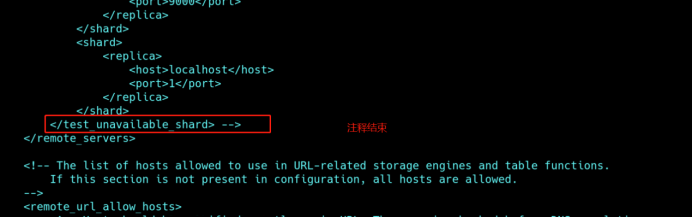
5、创建相关目录
只需创建log文件目录即可
mkdir /bigdata/clickhouse
mkdir /bigdata/clickhouse/log
chown clickhouse:clickhouse /bigdata/clickhouse
chown clickhouse:clickhouse /bigdata/clickhouse/log
6、启动
/etc/init.d/clickhouse-server start
/etc/init.d/clickhouse-server stop
7、登录
由于9000与其它服务端口冲突,故tcp端口更改为9011
clickhouse-client --host localhost --port 9011
二、集群版
1、修改配置文件(三分片、单副本)
分别在三个节点都创建文件,红色字体每个节点配置不一样
vim /etc/metrika.xml
<yandex>

    <clickhouse_remote_servers>

        <cluster-01>

            <shard>

                <internal_replication>true</internal_replication>

                <replica>

                    <host>spbsjzy19</host>

                    <port>9011</port>

                    <user>rt</user>

                    <password>SPBsjzy@)@)</password>

                </replica>

            </shard>

            <shard>

                <internal_replication>true</internal_replication>

                <replica>

                    <host>spbsjzy20</host>

                    <port>9011</port>

                    <user>rt</user>

                    <password>SPBsjzy@)@)</password>

                </replica>

            </shard>

            <shard>

                <internal_replication>true</internal_replication>

                <replica>

                    <host>spbsjzy21</host>

                    <port>9011</port>

                    <user>rt</user>

                    <password>SPBsjzy@)@)</password>

                </replica>

            </shard>

        </cluster-01>

    </clickhouse_remote_servers>

    <zookeeper-servers>

        <node index="1">

            <host>spbsjzy33</host>

            <port>2181</port>

        </node>

        <node index="2">

            <host>spbsjzy34</host>

            <port>2181</port>

        </node>

        <node index="3">

            <host>spbsjzy35</host>

            <port>2181</port>

        </node>

    </zookeeper-servers>

     <macros>

      <cluster>cluster-01</cluster>

      <shard>01</shard>

      <replica>spbsjzy19</replica>

     <!-- <shard>02</shard>

      <replica>spbsjzy20</replica>

      <shard>03</shard>

      <replica>spbsjzy21</replica>

-->

    </macros>

    <clickhouse_compression>

        <case>

            <min_part_size>10000000000</min_part_size>

            <min_part_size_ratio>0.01</min_part_size_ratio>

            <method>lz4</method>

        </case>

    </clickhouse_compression>

</yandex>
注意:
1) <macros> </macros>中的shard名
三个节点配置相同则在任意一个节点插入数据,其他节点都会查询到;不相同的话复制表之间数据不会同步(插入分布表,数据会随机分配到某个节点的复制表;插入任意一个节点的复制表,分布表可以查询到,其他节点复制表无法查到)
2) <macros> </macros>中 <cluster>表示集群名称,<shard>表示分片编号,<replica>表示副本标识,这里使用了cluster{cluster}-{shard}-{replica}的表示方式
3) <internal_replication>
如果设置为true,则往本地表写入数据时,总是写入到完整健康的副本里,然后由表自身完成复制,这就要求本地表是能自我复制的(推荐)。如果设置为false,则写入数据时,是写入到所有副本中。这时,是无法保证一致性的
4) <user></user><password></password>
添加完后使用默认default用户也可以查询分布表。
相关报错信息:
ru.yandex.clickhouse.except.ClickHouseException: ClickHouse exception, code: 516, host: spbsjzy20, port: 8123; Code: 516, e.displayText() = DB::Exception: Received from spbsjzy19:9011. DB::Exception: default: Authentication failed: password is incorrect or there is no user with such name. (version 20.3.6.40 (official build))
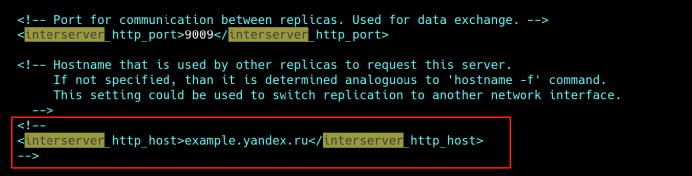
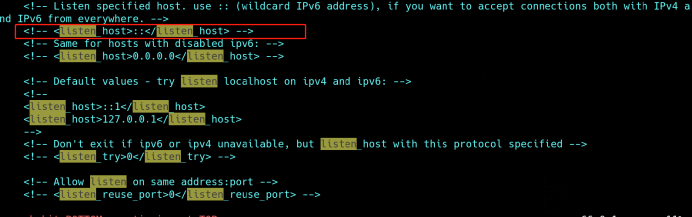
2、修改配置
vim /etc/clickhouse-server/config.xml
把注释打开,否则节点之间无法访问,分布表也无法查询其它节点数据
3、建议
生产中建议一般采用复制表和分布表;先创建复制表而后创建分布表,复制表用来存储数据,分布表用来查询和写入
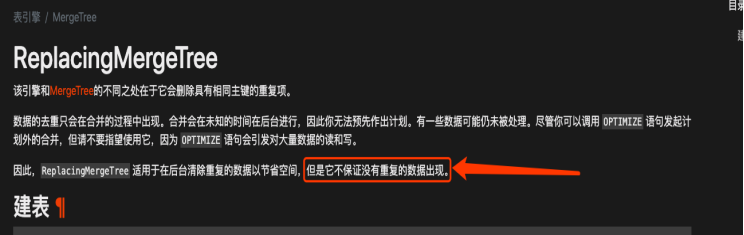
ReplacingMergeTree:
4、创建表
分别在三个节点创建复制表:
分别在三个节点创建复制表:
CREATE TABLE default.test (`eventdate` Date, `company` String, `deliveryno` String, `usercardtype` String, `id` String, `name` String, `mob` String, `orgcode` String, `creditcode` String, `taxregno` String, `type` String, `cardid` String, `staffna` String, `staffmob` String, `staffaddress` String, `checkdate` String, `method` String, `address` String, `utcdate` DateTime DEFAULT now()) ENGINE = ReplicatedMergeTree('/clickhouse/tables/{shard}/test', '{replica}', eventdate, (eventdate, company, deliveryno, id, mob, name), 8192)
在一个节点创建分布表:
CREATE TABLE default.test_all (`eventdate` Date, `company` String, `deliveryno` String, `usercardtype` String, `id` String, `name` String, `mob` String, `orgcode` String, `creditcode` String, `taxregno` String, `type` String, `cardid` String, `staffna` String, `staffmob` String, `staffaddress` String, `checkdate` String, `method` String, `address` String, `utcdate` DateTime DEFAULT now()) ENGINE = Distributed('{cluster}', 'default', 'test', rand())
5、插入表
insert into test(eventdate,company,deliveryno,id) VALUES('2020-12-05','ff','vv','xx');

insert into test_all(eventdate,company,deliveryno,id) VALUES('2020-12-06','xx','vv','xx');
6、数据分布测试
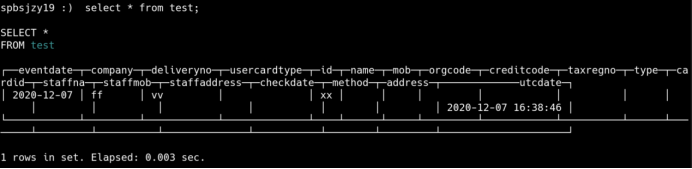
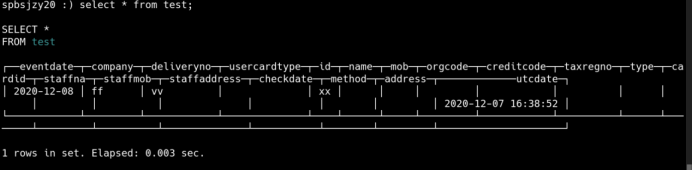
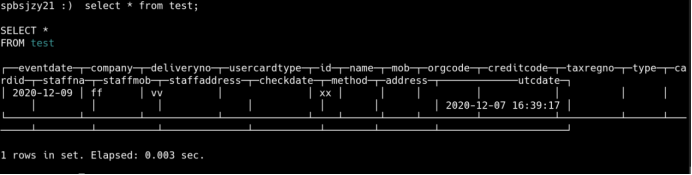
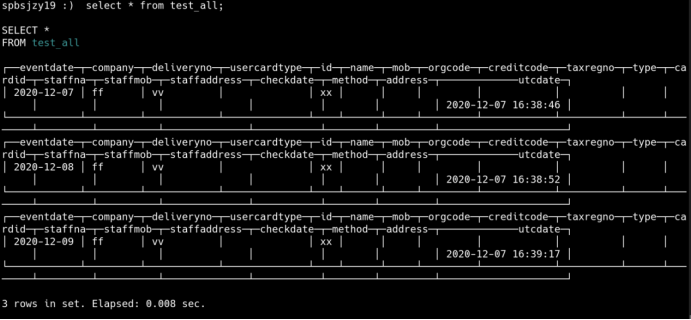
(1)三张复制表分别执行
insert into test(eventdate,company,deliveryno,id) VALUES('2020-12-07','ff','vv','xx');

insert into test(eventdate,company,deliveryno,id) VALUES('2020-12-08','ff','vv','xx');

insert into test(eventdate,company,deliveryno,id) VALUES('2020-12-09','ff','vv','xx');
查询复制表:
查询分布表
(2)插入分布表(随机分布)
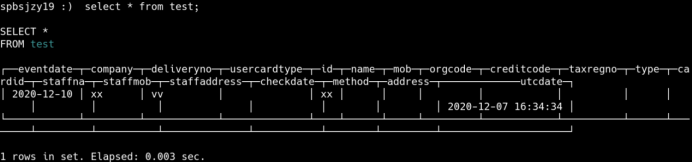
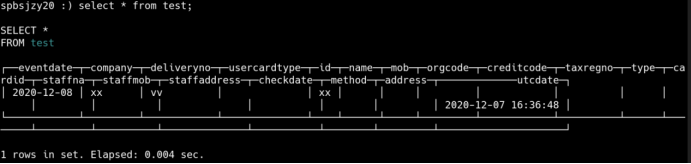
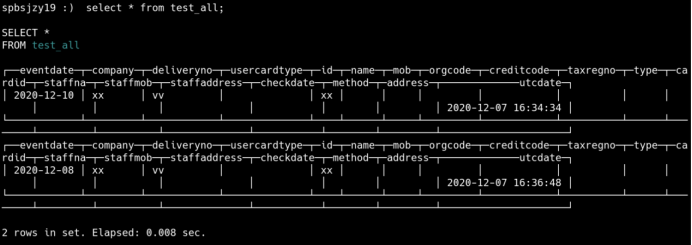
insert into test_all(eventdate,company,deliveryno,id) VALUES('2020-12-07','xx','vv','xx');

insert into test_all(eventdate,company,deliveryno,id) VALUES('2020-12-08','xx','vv','xx');
查询复制表
查询分布表
7、节点宕机测试
ClickHouse安装使用(单机、集群、高可用)的更多相关文章
- openstack pike 集群高可用 安装 部署 目录汇总
# openstack pike 集群高可用 安装部署#安装环境 centos 7 史上最详细的openstack pike版 部署文档欢迎经验分享,欢迎笔记分享欢迎留言,或加QQ群663105353 ...
- Rabbitmq集群高可用测试
Rabbitmq集群高可用 RabbitMQ是用erlang开发的,集群非常方便,因为erlang天生就是一门分布式语言,但其本身并不支持负载均衡. Rabbit模式大概分为以下三种:单一模式.普通模 ...
- 浅谈MySQL集群高可用架构
前言 高可用架构对于互联网服务基本是标配,无论是应用服务还是数据库服务都需要做到高可用.对于一个系统而言,可能包含很多模块,比如前端应用,缓存,数据库,搜索,消息队列等,每个模块都需要做到高可用,才能 ...
- bitmq集群高可用测试
Rabbitmq集群高可用 RabbitMQ是用erlang开发的,集群非常方便,因为erlang天生就是一门分布式语言,但其本身并不支持负载均衡. Rabbit模式大概分为以下三种:单一模式.普通模 ...
- mysql集群高可用架构
前言 高可用架构对于互联网服务基本是标配,无论是应用服务还是数据库服务都需要做到高可用.对于一个系统而言,可能包含很多模块,比如前端应用,缓存,数据库,搜索,消息队列等,每个模块都需要做到高可用,才能 ...
- hadoop+zookeeper集群高可用搭建
hadoop+zookeeper集群高可用搭建 Senerity 发布于 2 ...
- RabbitMQ从零到集群高可用(.NetCore5.0) -高可用集群构建落地
系列文章: RabbitMQ从零到集群高可用(.NetCore5.0) - RabbitMQ简介和六种工作模式详解 RabbitMQ从零到集群高可用(.NetCore5.0) - 死信队列,延时队列 ...
- Eureka 集群高可用配置.
SERVER:1 server: port: 1111 eureka: instance: hostname: ${spring.cloud.client.ip-address} instance-i ...
- 集群高可用之lvs+keepalive
集群高可用之lvs+keepalive keepalive简介: 负载均衡架构依赖于知名的IPVS内核模块,keepalive由一组检查器根据服务器的健康情况动态维护和管理服务器池.keepalive ...
- RabbitMQ从零到集群高可用(.NetCore5.0) - 死信队列,延时队列
系列文章: RabbitMQ从零到集群高可用(.NetCore5.0) - RabbitMQ简介和六种工作模式详解 RabbitMQ从零到集群高可用(.NetCore5.0) - 死信队列,延时队列 ...
随机推荐
- ELK-Kibana汉化
https://github.com/anbai-inc/Kibana_Hanization 补丁包 教程:1:首先,我们先杀死了Kibana进程,其实,教程说不用重启或关闭Kibana,但是,我们 ...
- uniapp-父组件数组变化同步子组件视图渲染
项目中子组件封装的是一个picker,父组件需要传数组到子组件中. 如果父组件的数组出现变更,视图中的子组件或许不能直接刷新渲染,需要反复弹起几下才能看到. 试过深度监听,但都没有用,ref也不知道为 ...
- Pytest 学习(二十七)- Jenkins+Allure+Pytest的持续集成
一.配置 allure 环境变量 1.下载 allure是一个命令行工具,可以去 github 下载最新版:https://github.com/allure-framework/allure2/re ...
- 自顶向下redis4.0(4)时间事件与expire
redis4.0的时间事件与expire 目录 redis4.0的时间事件与expire 简介 正文 时间事件注册 时间事件触发 expire命令 删除过期键值 被动删除 主动删除/定期删除 参考文献 ...
- Hbase备份以及清表脚本
脚本主要是方便自己工作使用,服务器环境中配置了hbase相关环境变量 1.hbase备份脚本 #!/bin/bash tableList=("table1" "table ...
- 系统类 System类
System类代表系统,系统级的很多属性和控制方法都放置在该类的内部.该类位于java.lang包. 由于该类的构造方法是private的,所以无法创建该类的对象,也就是无法实例化该类.其内部的成员变 ...
- Spark性能调优篇二之重构RDD架构及RDD持久化
如果一个RDD在两个地方用到,就持久化他.不然第二次用到他时,会再次计算. 直接调用cache()或者presist()方法对指定的RDD进行缓存(持久化)操作,同时在方法中指定缓存的策略. 原文:h ...
- 网络编程-python实现-TCP(1.1.3)
@ 目录 1.TCP是什么 2.代码实现 1.TCP是什么 传输控制协议(TCP,Transmission Control Protocol)是一种面向连接的.可靠的.基于字节流的传输层通信协议,由I ...
- Excel 快速跳到表格最后一行/第一行
快速跳到表格的最后一行 首先鼠标选中一个带有数据的单元格,点击shift键,把鼠标放到该单元格底部的边缘地带,出现带四个方向的箭头为止,再连续点击鼠标左键两次,直接跳到表格的最后一行 快速跳到表格的最 ...
- 【Java】指定【微信】好友自动发送消息
package user.controller; import java.awt.*; import java.awt.datatransfer.Clipboard; import java.awt. ...