
crawlergo动态爬虫去除Spidername使用
本来是想用AWVS的爬虫来联动Xray的,但是需要主机安装AWVS,再进行规则联动,只是使用其中的目标爬虫功能感觉就太重了,在github上面找到了由360 0Kee-Team团队从360天相中分离出来的动态爬虫模块crawlergo,尝试进行自定义代码联动
基础使用
下载最新的releases版本,到其目录下使用:
在PowerShell里面运行
./crawlergo -c "C:\Program Files (x86)\Google\Chrome\Application\chrome.exe" -t 10 http://testphp.vulnweb.com/

但是很明显可以看到在爬虫的请求头里面存在:

Spider-Name:crawlergo字段
crawlergo团队也说明了这个问题:
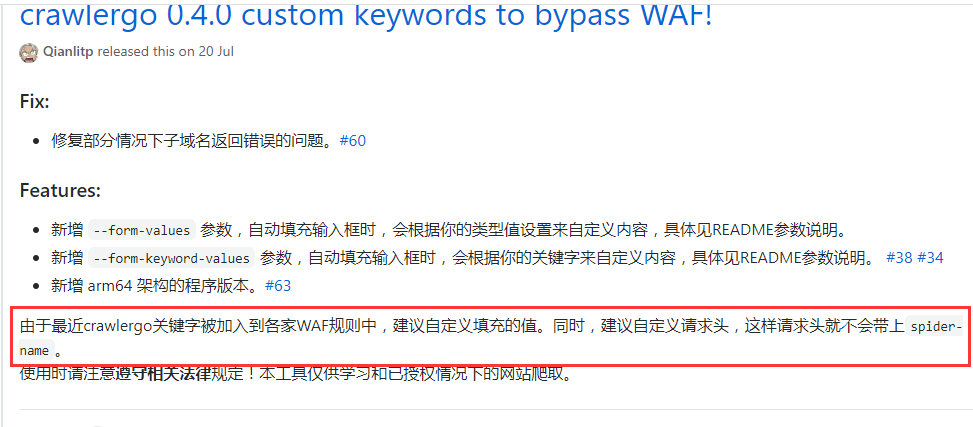
也有issue提到了这一点

所以我们先解决关键字被WAF拦截的问题,使用自定义请求头进行crawlergo页面爬取。
使用fake_useragent伪造请求头:
from fake_useragent import UserAgent

ua = UserAgent()

def GetHeaders():

    headers = {'User-Agent': ua.random}

    return headers
在爬取的时候指定请求头为随机生成的,即:
"--custom-headers",json.dumps(GetHeaders())
然后根据crawlergo团队给出的系统调用部分代码进行修改
原代码如下(我已将谷歌浏览器路径改为自己本地的了):
#!/usr/bin/python3

# coding: utf-8

import simplejson

import subprocess

def main():

    target = "http://testphp.vulnweb.com/"

    cmd = ["./crawlergo", "-c", "C:\Program Files (x86)\Google\Chrome\Application\chrome.exe", "-o", "json", target]

    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)

    output, error = rsp.communicate()

	#  "--[Mission Complete]--"  是任务结束的分隔字符串

    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])

    req_list = result["req_list"]

    print(req_list[0])

if __name__ == '__main__':

    main()
该代码默认打印当前域名请求
运行结果如图:

将关键部分代码:
cmd = ["./crawlergo", "-c", "C:\Program Files (x86)\Google\Chrome\Application\chrome.exe", "-o", "json", target]
根据项目参数:
--custom-headers Headers自定义HTTP头,使用传入json序列化之后的数据,这个是全局定义,将被用于所有请求
修改为:
cmd = ["./crawlergo", "-c", "C:\Program Files (x86)\Google\Chrome\Application\chrome.exe", "--custom-headers",json.dumps(GetHeaders()),"-t","10","-o", "json", target]
GetHeaders()函数上面已经给出,运行结果为:

可以看到Spider-Name:crawlergo字段已经没有了。
对于返回结果的处理
当设置输出模式为 json时,返回的结果反序列化之后包含四个部分:
all_req_list: 本次爬取任务过程中发现的所有请求,包含其他域名的任何资源类型。req_list:本次爬取任务的同域名结果,经过伪静态去重,不包含静态资源链接。理论上是all_req_list的子集all_domain_list:发现的所有域名列表。sub_domain_list:发现的任务目标的子域名列表。
我们想要获取的是任务的同域名结果,所以输出:
result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])

    # print(result)

    req_list = result["req_list"]

    for url in req_list:

        print(url['url'])

可以看到去重不算太完美
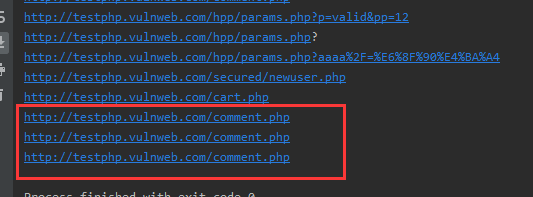
最后为了方便配置可以写一个config.py,用来放置chorme的路径,增加扫描系统的通用性,将结果存储到txt或者队列里面去。
crawlergo动态爬虫去除Spidername使用的更多相关文章
- 数字crawlergo动态爬虫结合长亭XRAY被动扫描
群里师傅分享了个挖洞的视频,搜了一下,大概就是基于这篇文章录的 https://xz.aliyun.com/t/7047 (小声哔哔一下,不得不说,阿里云先知社区和360酒仙桥六号部队公众号这两个地方 ...
- QQ空间动态爬虫
作者:虚静 链接:https://zhuanlan.zhihu.com/p/24656161 来源:知乎 著作权归作者所有.商业转载请联系作者获得授权,非商业转载请注明出处. 先说明几件事: 题目的意 ...
- scrapy + selenium 的动态爬虫
动态爬虫 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会 ...
- scala 爬虫 去除不能存储的特殊字符
scala 爬虫 去除不能存储的特殊字符 /** * 去除不能存储的特殊字符 */ def zifuChange(str: String): String = { var bo = true var ...
- 动态爬虫——selenium2搭载phantomjs入门范例
这是我学习爬虫比较深入的一步了,大部分的网页抓取用urllib2都可以搞定,但是涉及到JavaScript的时候,urlopen就完全傻逼了,所以不得不用模拟浏览器,方法也有很多,此处我采用的是sel ...
- Python3网络爬虫之requests动态爬虫:拉钩网
操作环境: Windows10.Python3.6.Pycharm.谷歌浏览器目标网址: https://www.lagou.com/jobs/list_Python/p-city_0?px=defa ...
- Selenium+Chrome或Firefox的动态爬虫程序
新版本的Selenium不再支持PhantomJS了,请使用Chrome或Firefox的无头版本来替代.
- crawler: 爬虫的基本结构
目前我所知道的爬虫在获取页面信息上,分为静态爬虫和动态爬虫:静态爬虫主要用于获取静态页面,获取速度一般也比较快:但是现在很多网站的页面都是采用动态页面,当我们用爬虫去获取信息的时候,页面的信息可能还没 ...
- 【python爬虫】初识爬虫
一.爬虫的定义 爬虫定义:程序或者脚本——自动的爬取万维网的数据的程序或者脚本. 二.爬虫可以解决的问题 1.解决冷启动问题. 2.搜索引擎的根基——通用爬虫. 3.帮助机器学习建立知识图谱. 4.制 ...
随机推荐
- Android测试三件套:传文件、抓包、看日志
在对安卓进行测试时,我们需要把 apk 传到安卓机上,对请求抓包,同时监控应用日志.本文就来讲讲具体操作. 安卓机是指基于安卓的机器 ,如手机.POS 机.电视盒子等. 传文件 我们拒绝用 U 盘传文 ...
- 【软件配置】JDK+AndroidStudio4.1开发安卓APP环境安装和配置教程详细
目录 一.专业名词 二.搭建前资源准备 2.1 JDK资源下载 2.2 AndroidStudio下载 三.安装 3.1 JDK安装配置 3.2 AndroidStudio安装 四.创建安卓APP工程 ...
- C语言I博课作业04
这个作业属于哪个课程 C语言程序设计II 这个作业要求在哪里 https://edu.cnblogs.com/campus/zswxy/SE2020-1/homework/11489 我在这个作业课程 ...
- CSS之calc()
calc() 函数支持任意CSS长度单位的混合计算,遵循标准数学运算优先级规则,可以动态计算长度值.注意,calc()函数内部的运算符两侧各加一个空白符,否则会产生解析错误. calc()使用的难点在 ...
- linux 命令之file
Linux file命令用于辨识文件类型. 通过file指令,我们得以辨识该文件的类型. 语法 file [-bcLvz][-f <名称文件>][-m <魔法数字文件>...] ...
- gethostname(获取主机名)、gethostbyname(由主机名获取IP地址)
int gethostname(char *name, size_t len);获取本地主机名存入name[len],成功返回0,失败返回-1: struct hostent * gethostbyn ...
- 1-06-2 Lambda表达式
last modified:2020/10/31 1-06-3-Lambda表达式 6.3.1 为什么引入lambda表达式 lambda表达式是一个可传递的代码块,可以在以后执行一次或多次. 将一个 ...
- //*[starts-with(@class,'btn')][text()='差'] 正则定位元素
starts-with? //*[starts-with(@class,'btn')][text()='差'] 意思找从头开始的这个class
- 我要进大厂之大数据MapReduce知识点(2)
01 我们一起学大数据 今天老刘分享的是MapReduce知识点的第二部分,在第一部分中基本把MapReduce的工作流程讲述清楚了,现在就是对MapReduce零零散散的知识点进行总结,这次的内容大 ...
- scala中的val,var和lazy
转自:https://yerias.github.io/2020/03/19/scala/3/#3%EF%BC%9Alazy%E4%BF%AE%E9%A5%B0%E7%AC%A6%E5%8F%AF%E ...